
L’ANALISI
llama.cpp: cache MoE con CPU e calibrazione locale
llama.cpp divide i cache miss MoE fra CPU e GPU e aggiunge uno script con sei calibrazioni: risultati misurati e stime restano distinti.
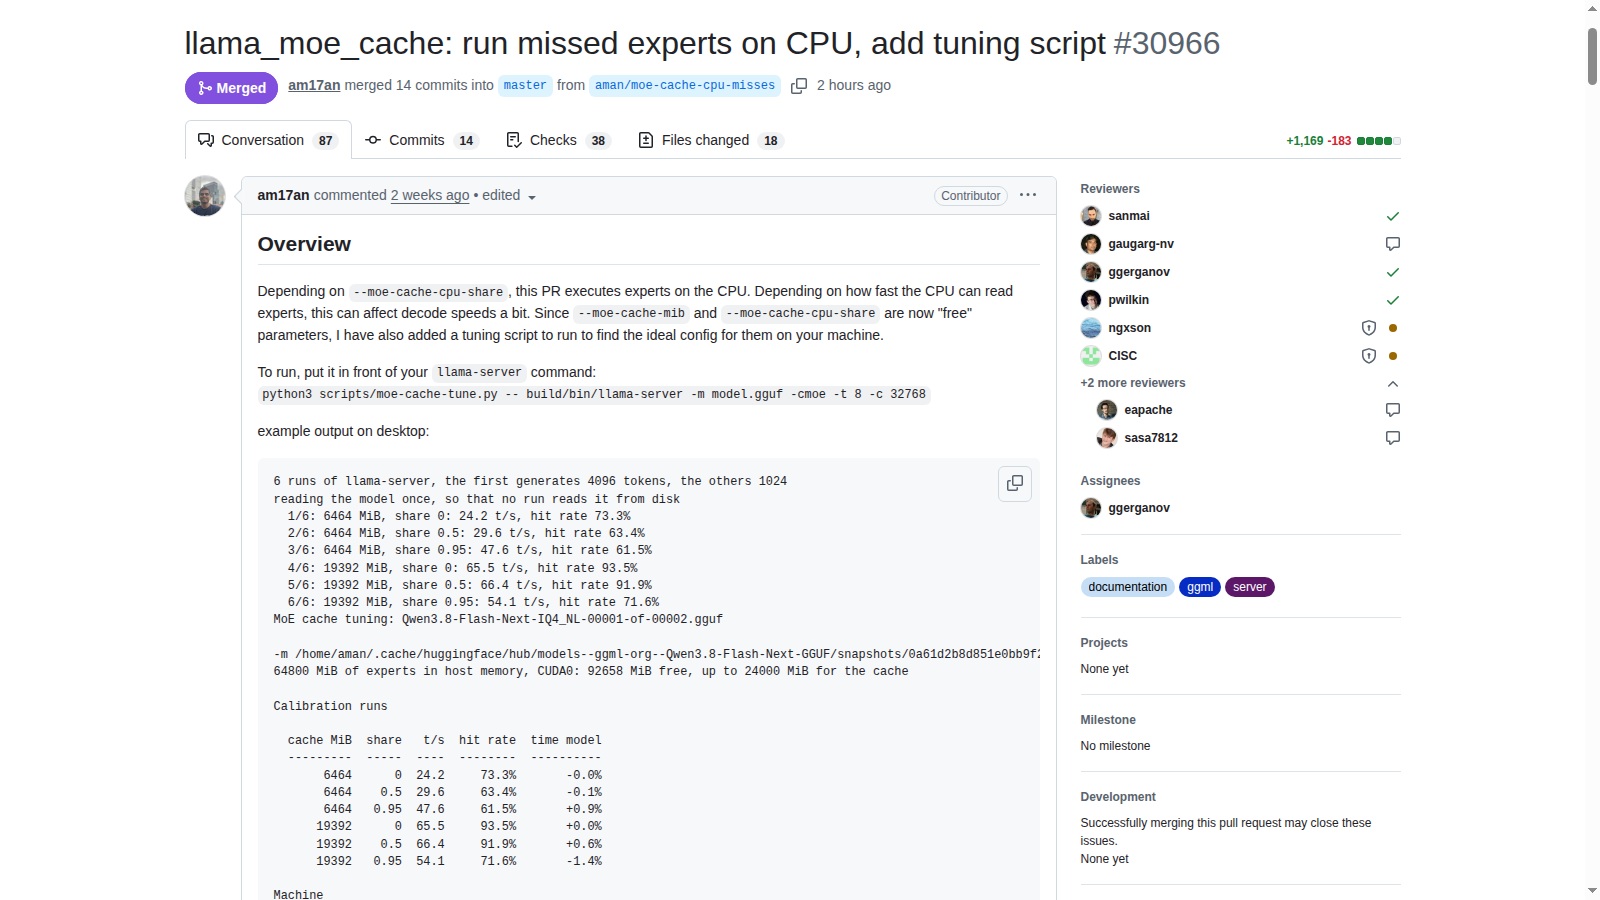
In breve: llama.cpp può ora assegnare alla CPU una parte dei cache miss degli esperti MoE, ma solo dopo che la cache sul dispositivo è piena. Lo script di tuning avvia sei calibrazioni e stima altre combinazioni di memoria e quota CPU: serve a scegliere cosa provare sul proprio hardware, non certifica un guadagno di velocità. llama.cpp: cache miss MoE sulla CPU e script di tuning.
Verifica documentale della pull request 30966, del merge del 7 novembre alle 17:20:59 ora italiana, del tag b12191 e dei file docs/moe-cache.md e scripts/moe-cache-tune.py al commit completo del merge. Il codice Python supera parsing e compilazione sintattica locale, senza avviare server, scaricare pesi o produrre token. Il controllo REST della release b12191 ha restituito HTTP 404 durante l'acquisizione di questo ciclo; il tag risolve invece il commit. Questi sono controlli di provenienza, non un test prestazionale.
Che cosa cambia per gli esperti MoE non in cache?
La cache conserva sulla memoria del dispositivo gli esperti usati più spesso quando i pesi degli esperti restano nella memoria host. La documentazione la colloca nei batch piccoli, compresi decode e speculative decoding; per batch grandi vengono ancora caricati gli esperti utilizzati. Il nuovo parametro --moe-cache-cpu-share accetta una quota da 0 a 1. Con cache piena quella quota dei miss viene calcolata sulla CPU, mentre gli hit restano sul dispositivo e gli altri miss vengono trasferiti. Durante il riempimento iniziale tutti i miss continuano invece a essere caricati. Non è un comando che sposta automaticamente tutto il modello sulla CPU.
Documentazione MoE cache al commit verificato · Diff della pull request 30966 e nuovi parametri.
Quando la CPU può essere una scelta utile?
Il confronto è fra il tempo necessario alla CPU per leggere e calcolare gli esperti in RAM e quello necessario per trasferirli al dispositivo. La documentazione cita RAM veloce, collegamenti PCIe e modalità di caricamento come fattori che cambiano questo equilibrio. Distingue in particolare la memoria host bloccata, o pinned, da mmap: trasferimenti più efficienti possono ridurre l'utilità della quota CPU. Sono condizioni operative, non categorie di computer promosse o bocciate una volta per tutte. La quota predefinita è zero e anche la dimensione predefinita della cache è zero, quindi disabilitata: la nuova opzione da sola non dimostra che la cache sia attiva.
Documentazione MoE cache al commit verificato · Diff della pull request 30966 e nuovi parametri.
Che cosa misura davvero lo script di calibrazione?
moe-cache-tune.py viene anteposto al proprio comando llama-server e avvia il server sei volte: due dimensioni di cache, ciascuna con quote CPU 0, 0.5 e 0.95. Registra tempi e routing, ricava un modello dei costi e riproduce la logica della cache per prevedere altre combinazioni. Il report separa le velocità delle calibrazioni dalle t/s previste. Una cella nella tabella delle previsioni non è quindi una prova eseguita con quella configurazione. Le sei calibrazioni restano inoltre un campione del carico scelto, non un benchmark generale di conversazioni, contesti e concorrenza.
Documentazione MoE cache al commit verificato · Codice dello script moe-cache-tune.py al commit verificato.
Come impostare una prova controllata?
Dopo una build compatibile e con un GGUF già disponibile, la documentazione propone: python3 scripts/moe-cache-tune.py -- build/bin/llama-server -m model.gguf -cmoe -t 8 -c 32768. È un esempio da adattare: model.gguf è il file del modello, mentre thread, contesto, posizionamento degli esperti e modalità di caricamento devono riflettere la macchina e il carico reali. --max-mib restringe le dimensioni di cache considerate nelle previsioni e nella configurazione consigliata, ma non limita le cache delle sei calibrazioni; --out sceglie la directory dei risultati. Prima del tuning verificare quindi che la macchina possa sostenere anche le cache di calibrazione, determinate indipendentemente da --max-mib. Usare una cartella dedicata: quando cambia il comando registrato, lo script elimina i file nella directory dei risultati. La procedura deve essere svolta su una macchina di prova senza richieste di produzione: avvia processi e usa memoria e calcolo, non è una semplice interrogazione informativa.
Documentazione MoE cache al commit verificato · Codice dello script moe-cache-tune.py al commit verificato.
Come evitare un confronto ingannevole?
Conservare una baseline con la stessa build, lo stesso modello e gli stessi argomenti, poi confrontare una configurazione raccomandata con misure ripetute sul proprio carico. Registrare separatamente cache fredda e calda, t/s, memoria, hit rate e correttezza dell'output. Lo script riutilizza i risultati nella directory --out quando il comando resta uguale: per confronti dopo cambiamenti di hardware, build o condizioni usare una directory distinta e conservare quella precedente. Il solo nome del comando non documenta ogni condizione del test. Né le previsioni né l'esempio upstream possono sostituire questa verifica.
llama.cpp: cache miss MoE sulla CPU e script di tuning · Documentazione MoE cache al commit verificato · Codice dello script moe-cache-tune.py al commit verificato.
Il tag b12191 certifica una release stabile?
No. Il tag b12191 punta a e95426f16982054c379ca7bdc8186996dd22f0fe, coincidente con il merge della pull request, ma durante l'acquisizione l'endpoint ufficiale releases/tags/b12191 rispondeva 404. Il fatto verificato è la presenza del codice nel commit, non un insieme di binari pubblicati e collaudati per ogni piattaforma. Chi usa un pacchetto deve controllare la sua revisione e l'effettiva presenza delle nuove opzioni; chi compila dal sorgente deve fissare il commit e mantenere disponibile la build precedente. Non serve cambiare pesi o quantizzazione per raccontare questo delta del runtime.
llama.cpp: cache miss MoE sulla CPU e script di tuning · Riferimento ufficiale del tag b12191 e SHA del commit · Endpoint ufficiale della release b12191, controllo datato.
Condizioni e limitazioni
Analisi di pull request, diff e file fissati al commit e95426f16982054c379ca7bdc8186996dd22f0fe; nessuna build o inferenza eseguita qui. Le misure nell'esempio sono dell'autore e le altre combinazioni sono stime. Un tag non prova disponibilità di binari o stabilità.
Checklist pratica
- Verificare un modello MoE compatibile con esperti in memoria host e annotare modello, quantizzazione, build e backend.
- Fissare il commit del runtime e conservare la build precedente; non dedurre la disponibilità di binari dal tag.
- Registrare RAM, memoria del dispositivo, thread, contesto e modalità di caricamento prima della baseline.
- Eseguire il tuning soltanto su una macchina di prova, verificando prima la memoria necessaria alle calibrazioni: --max-mib limita le previsioni e la configurazione consigliata, non la cache usata dalle sei prove.
- Tenere separati i sei punti misurati, le t/s previste e la configurazione suggerita.
- Ripetere il workload reale con la configurazione proposta e una baseline, controllando anche output e memoria.
- Usare una directory --out distinta quando cambiano build, macchina o condizioni; non scambiare risultati riutilizzati per nuove misure.
Per scegliere hardware e runtime: Modelli AI locali: come scegliere LLM, hardware e runtime.