
IL PUNTO SULL’AI
10 novembre 2026
llama.cpp aggiorna audio, schema e percorsi GPU; Hermes amplia i plugin, DeepSeek il template chat. OpenAI propone cinque priorità formative.
In questa edizione 8 notizie
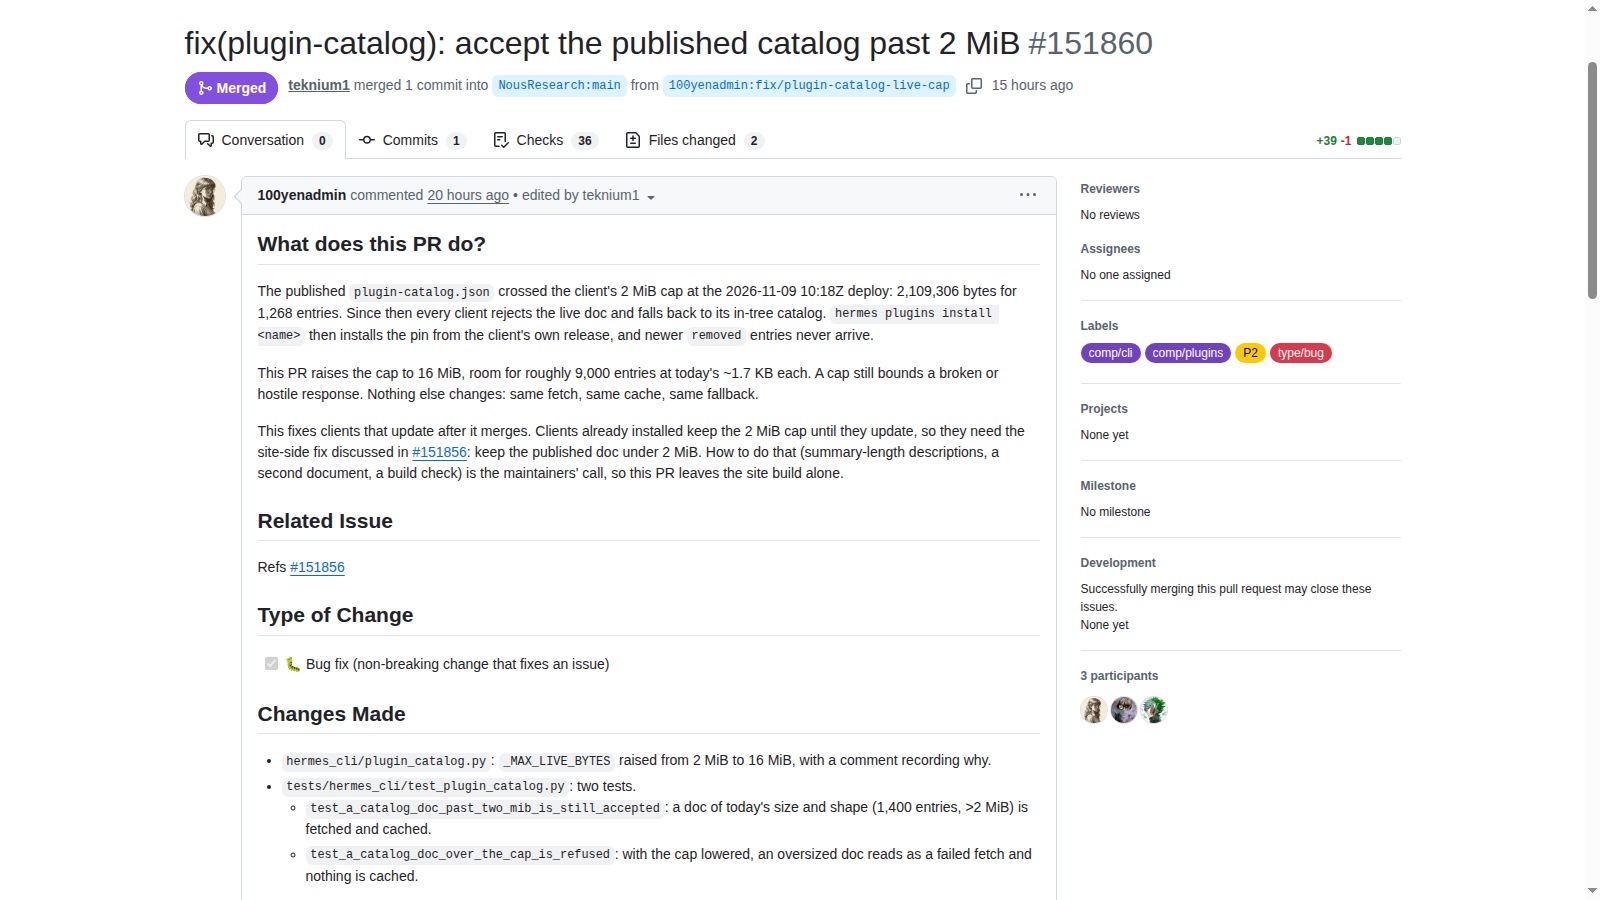
La patch stabile 0.23.1 porta da 2 a 16 MiB il limite del catalogo plugin live. Il catalogo pubblicato aveva superato il limite precedente: i client potevano ripiegare sulla copia inclusa nella propria release, installare pin non aggiornati e non ricevere nuove voci rimosse. La release risulta pubblicata il 10 novembre, anche se le note indicano il 9 novembre.
Limiti da conoscere
Limite: Analisi di release, PR e diff ufficiali, non un aggiornamento della nostra installazione. Le versioni precedenti conservano il vecchio limite finché non vengono aggiornate; la correzione non certifica sicurezza o qualità dei plugin.
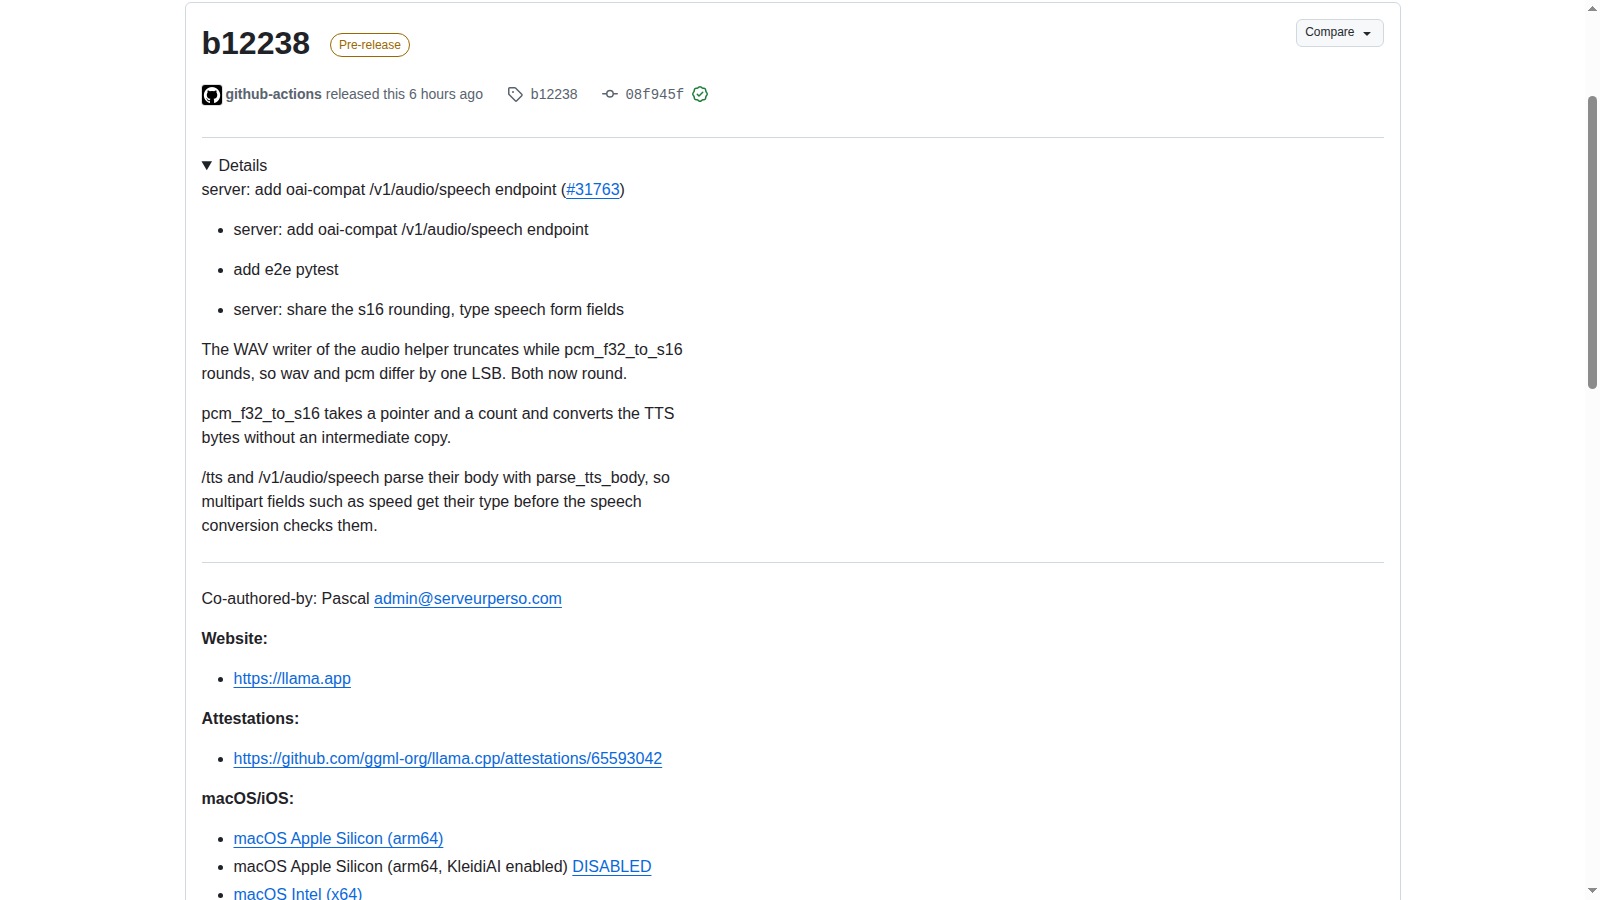
La build b12238 aggiunge /v1/audio/speech e converte le richieste nel percorso TTS del server. Occorre un modello capace di generare audio. La documentazione del commit accetta WAV e PCM, usa le voci esposte dal modello e consente soltanto velocità 1.0: l’etichetta compatibile non rende identiche tutte le opzioni dell’API OpenAI.
Limiti da conoscere
Limite: b12238 è marcata prerelease nell’API GitHub. Nessun audio prodotto e nessuna valutazione di qualità o pronuncia italiana. MP3, SSE e variazioni di velocità non sono supportati da questo contratto documentato.
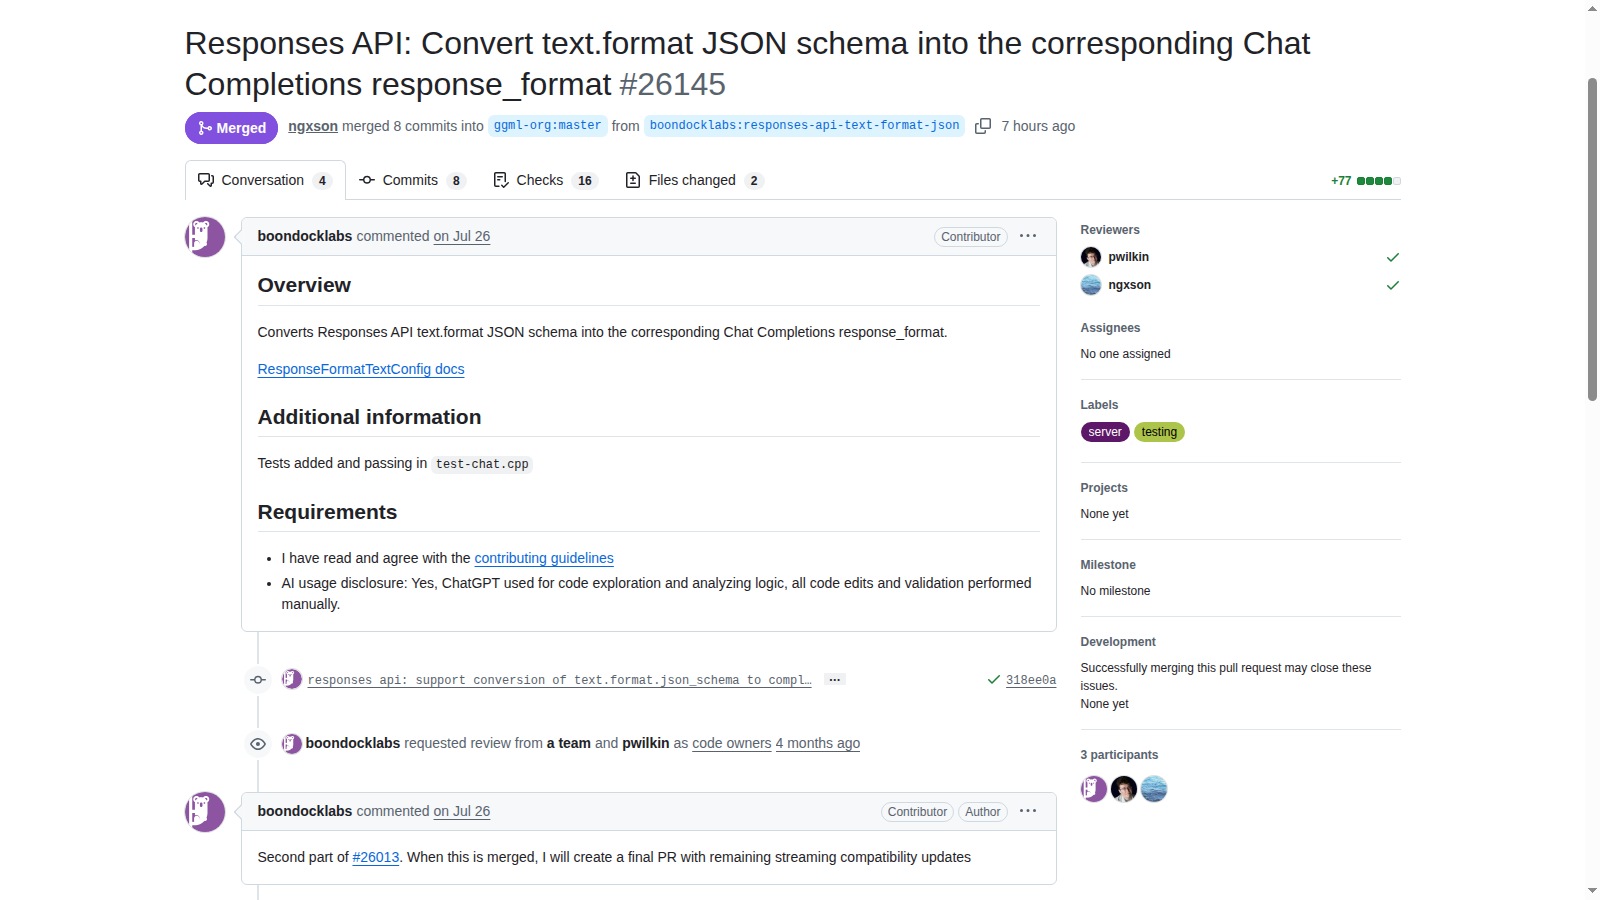
La build b12240 include la conversione di text.format della Responses API nel response_format usato da Chat Completions. La PR conserva nome, schema e opzione strict e aggiunge casi di test. È un delta distinto dalla correzione dello schema al livello principale già coperta il 9 novembre.
Limiti da conoscere
Limite: Build GitHub marcata prerelease. I test dichiarati nel repository non sono una nostra esecuzione e non dimostrano equivalenza completa delle API, supporto di ogni schema o correttezza semantica delle risposte.
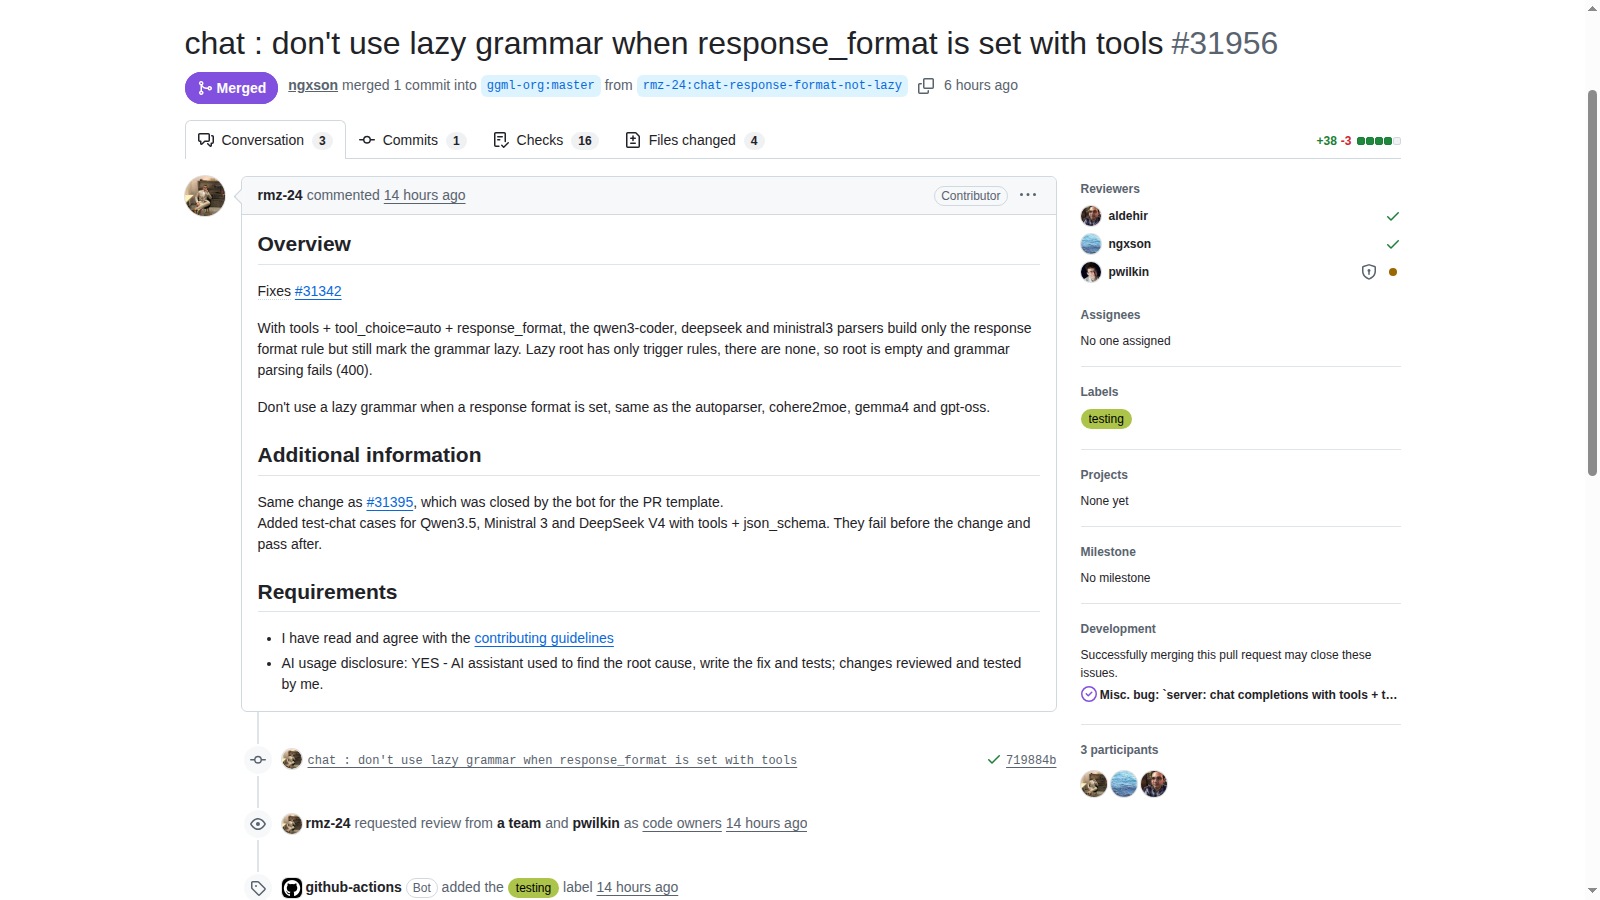
La PR 31956 corregge una grammatica lazy vuota quando tools, tool_choice auto e response_format sono presenti insieme nei parser qwen3-coder, deepseek e ministral3. La revisione primaria precisa un limite decisivo: in questa configurazione i modelli non produrranno tool call. Il fix evita l’errore di grammatica, non garantisce strumenti e JSON vincolato simultanei.
Limiti da conoscere
Limite: Verificato il merge della PR, non una release stabile né un nostro test runtime. Il fix non abilita le tool call nella configurazione descritta e non estende una garanzia a ogni parser o modello.
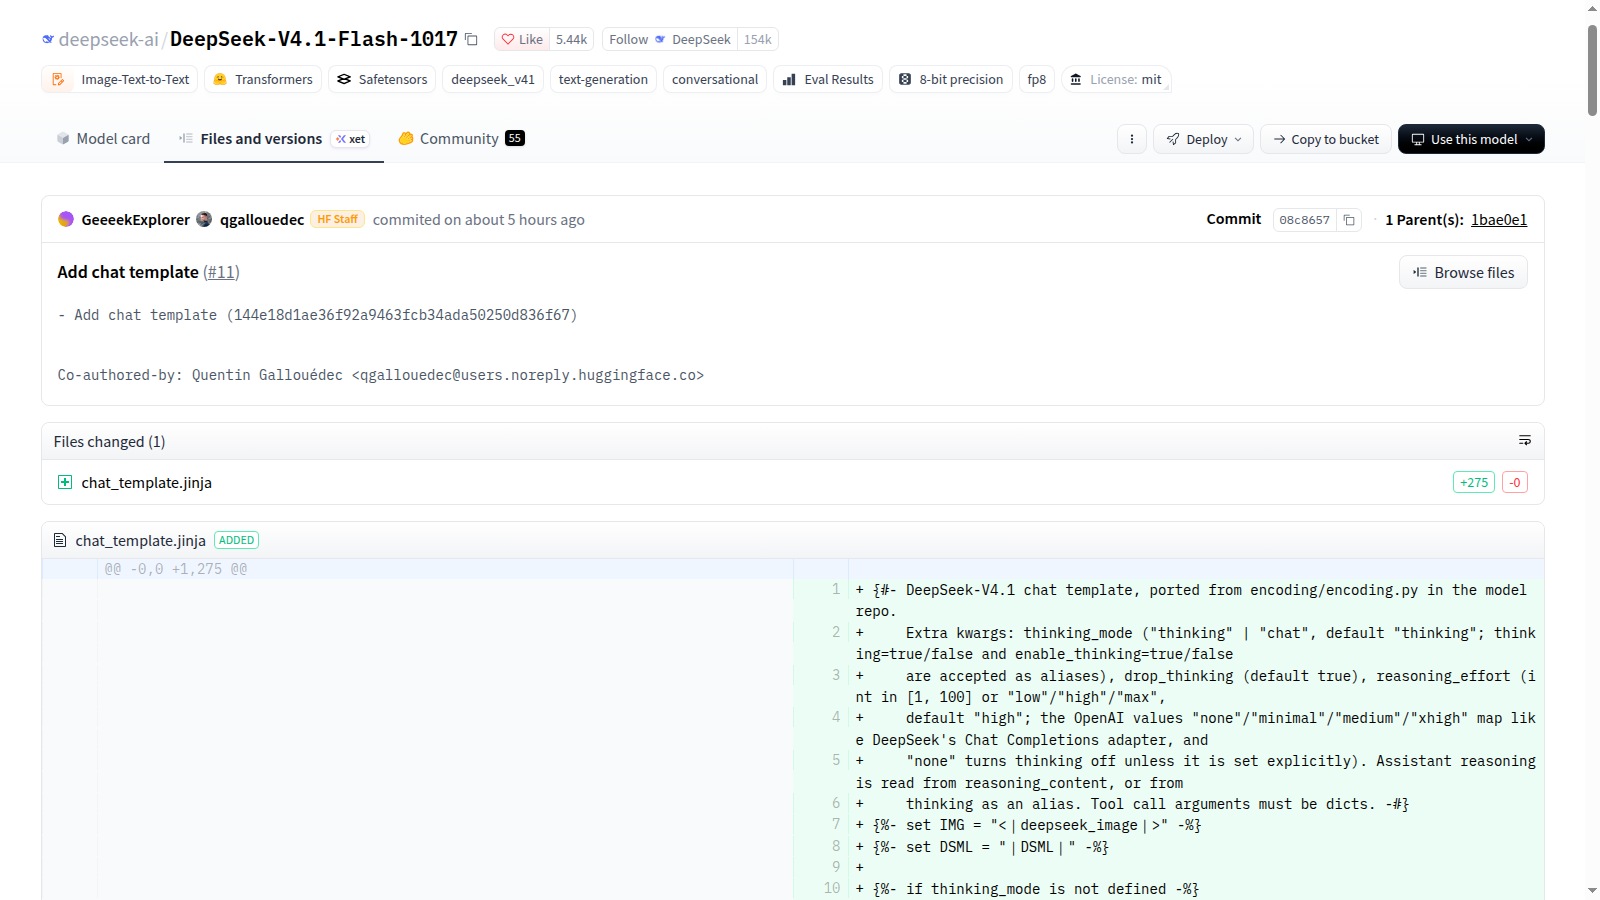
Il repository ufficiale aggiunge chat_template.jinja al checkpoint DeepSeek-V4.1-Flash-1017. Il commit è del 10 novembre e il confronto dei tree identifica il template come unico file aggiunto, senza cambiamenti agli shard dei pesi. È un delta per serializzare conversazioni e tool call, distinto dal lancio del modello del 17 ottobre.
Limiti da conoscere
Limite: Confronto dei file e lettura del template, non inferenza. Nessuna misura di qualità, velocità o compatibilità con ogni runtime. Il nome del repository resta quello del lancio del 17 ottobre; la novità è il commit del 10 novembre.
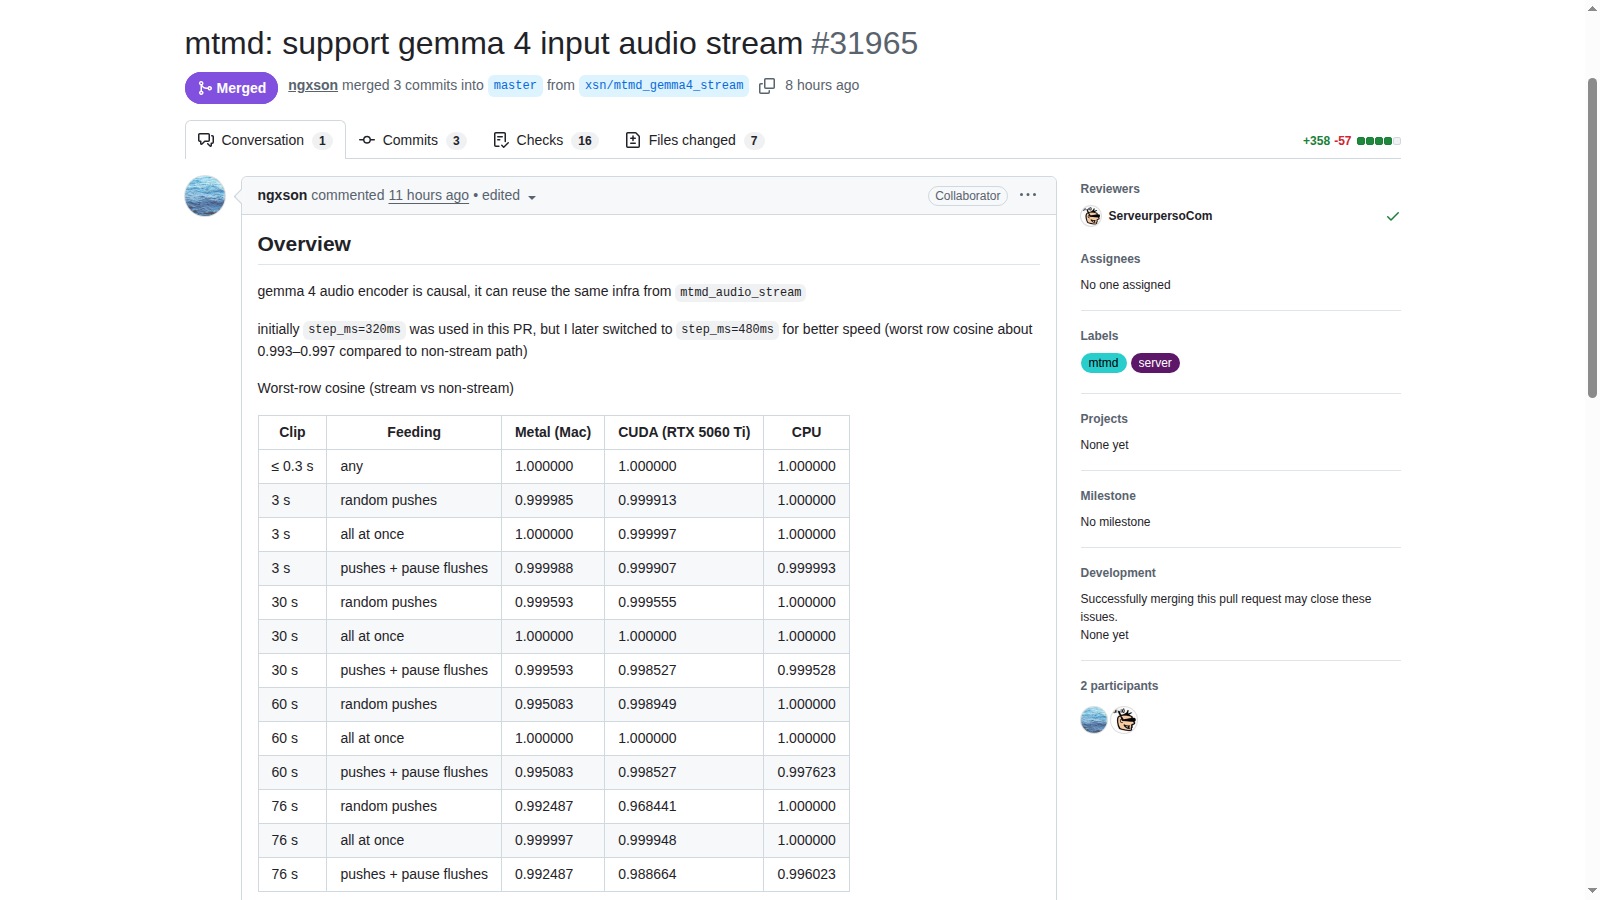
La build b12237 aggiunge il percorso di streaming audio in ingresso per Gemma 4, usando step di 480 ms. Le note includono una correzione delle embeddings forzate che potevano far abortire il primo batch audio di un modello chat. Si tratta di audio da elaborare, non della nuova route speech per produrre voce.
Limiti da conoscere
Limite: Build marcata prerelease, nessun audio elaborato qui. Le comparazioni numeriche della PR sono dell’autore e non misurano da sole comprensione, qualità della trascrizione o latenza dell’applicazione.
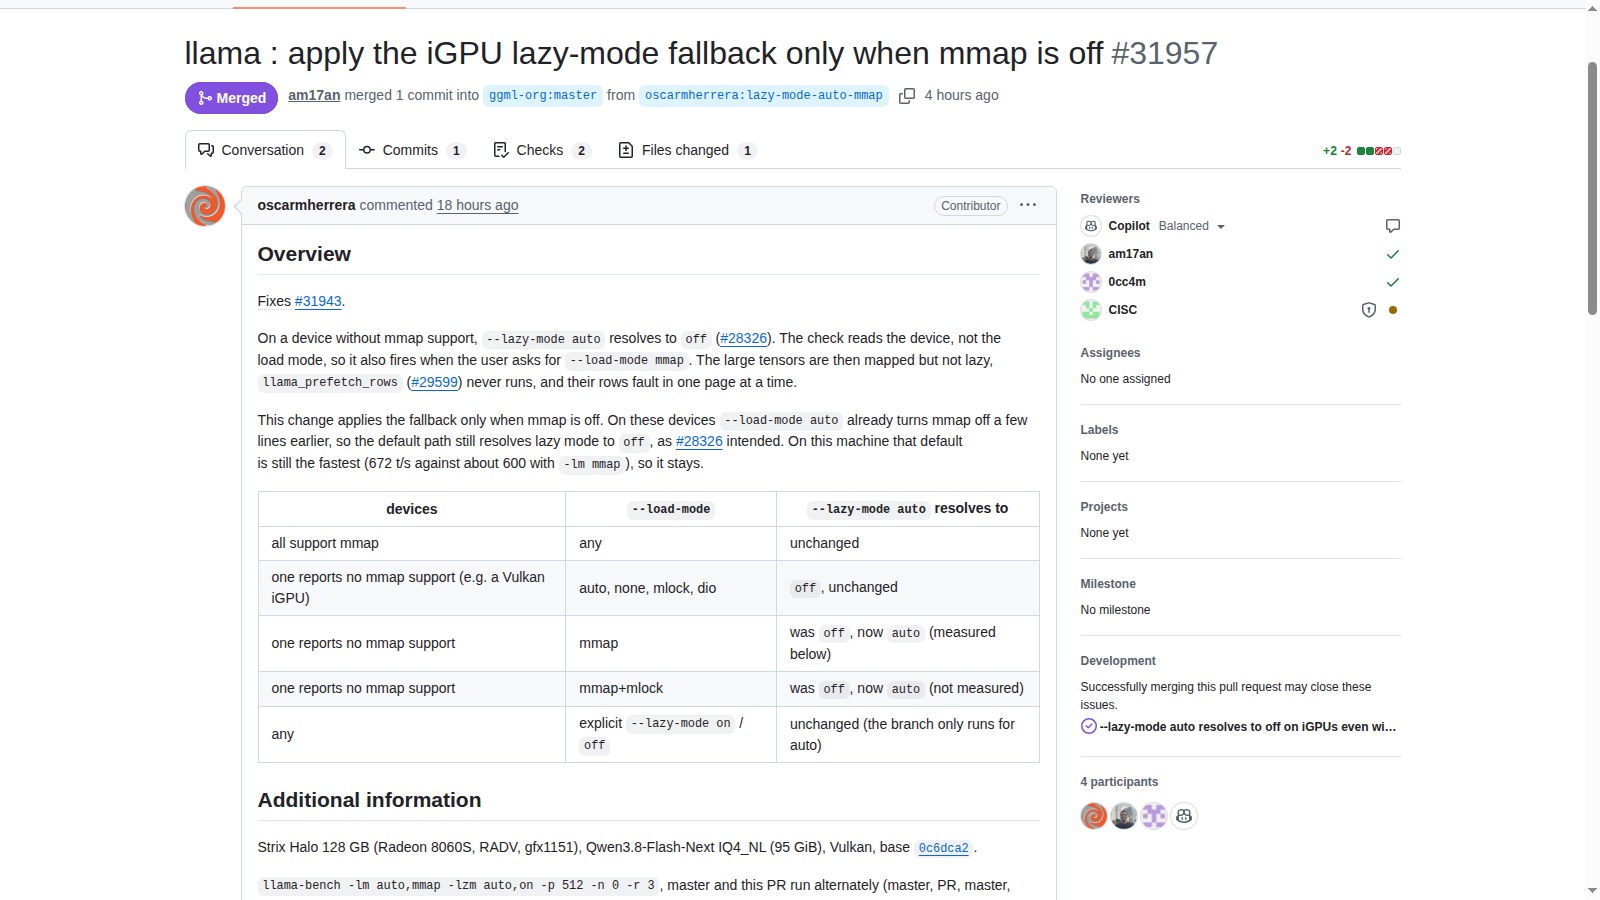
Tre merge del 10 novembre riguardano percorsi diversi: fallback lazy-mode con mmap sulle iGPU, rimozione di una specifica esclusione SDPA sulle Intel Arc A-series e aggiornamento della toolchain SYCL. Le build Intel b12243 e b12244 risultano prerelease; il merge iGPU non prova la disponibilità di b12245.
Limiti da conoscere
Limite: Il percorso iGPU predefinito auto resta invariato. Il caso Arc richiede attenzione ai vecchi runtime Linux. Nel confronto B570 dell'autore migliora il prompt processing, non la generazione. b12245 restituisce 404 nell'API verificata; b12243 e b12244 sono prerelease.
La guida OpenAI del 10 novembre raccoglie lezioni dalle partnership educative EMEA e indica cinque priorità: obiettivi, preparazione dei docenti, capacità locali, alfabetizzazione critica e valutazione. Adozione e tempo risparmiato non dimostrano, da soli, un apprendimento migliore.
Limiti da conoscere
Limite: Il report del fornitore riassume esperienze contestuali, survey e attività di monitoraggio. Risparmio di tempo dichiarato e uso degli strumenti non sono misure equivalenti a conoscenza, autonomia e ritenzione. La generalizzazione ai corsi italiani richiede una valutazione dedicata.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.