
L’ANALISI
llama.cpp b12192: Mage-VL-Cowork arriva nel runtime
llama.cpp b12192 aggiunge Mage-VL-Cowork in 13 file: cambia il supporto multimodale, non i pesi. La pull request segnala un limite Metal.
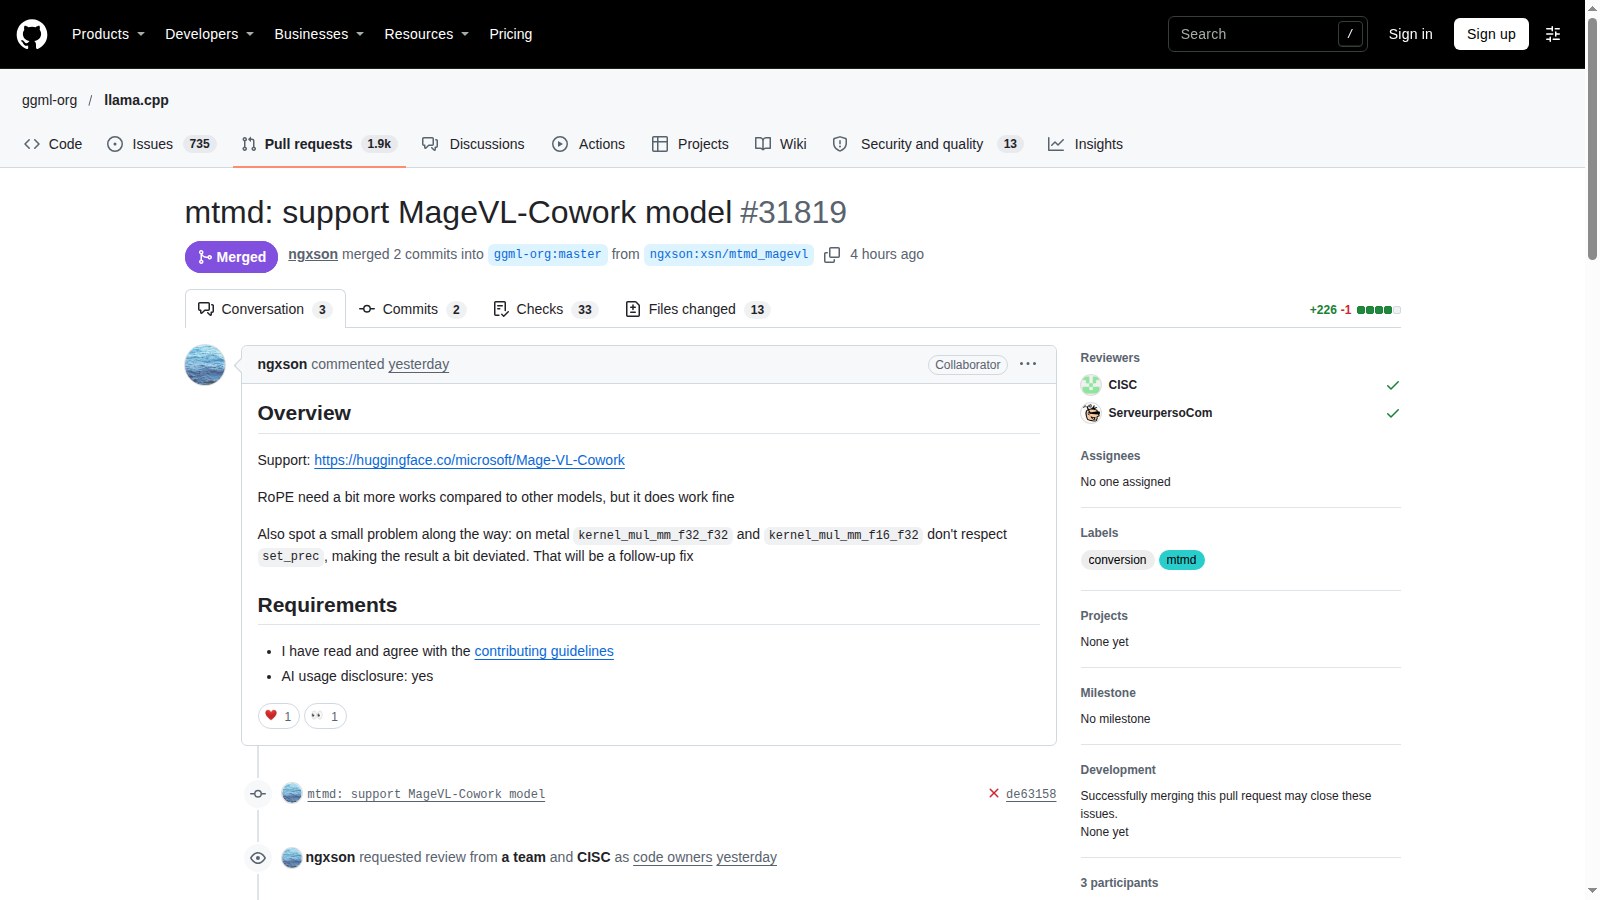
In breve: llama.cpp b12192 aggiunge il supporto di Mage-VL-Cowork nel runtime multimodale. Permette di preparare una prova di compatibilità con questa architettura, ma il merge non certifica il funzionamento su ogni backend: il contributore segnala esplicitamente un problema di precisione Metal ancora da trattare a parte. llama.cpp: pull request per Mage-VL-Cowork e limite Metal.
Verifica della release REST ufficiale, del tag, della pull request e del diff. Il merge è del 7 novembre alle 19:36:45 ora italiana; la prerelease è pubblicata alle 22:28:25. Queste sono due date dello stesso aggiornamento, non due lanci. Non sono stati scaricati pesi né eseguiti benchmark.
Che cosa aggiunge la prerelease b12192?
Il cambiamento riguarda il codice che riconosce e gestisce Mage-VL-Cowork, non un addestramento del modello. Il diff tocca conversione verso GGUF, metadati e implementazione del percorso visivo. Per chi mantiene un'applicazione locale, la domanda operativa diventa se build, file del modello e componente multimodale siano compatibili fra loro. Una versione precedente del runtime non acquisisce questo supporto soltanto perché il modello compare in un catalogo.
llama.cpp: pull request per Mage-VL-Cowork e limite Metal · Commit verificato: conversione, caricamento e grafo multimodale.
Perché contano i controlli sui tensori RoPE?
Le note della release spiegano che i fattori RoPE vengono conservati a livello di modello perché condivisi fra i layer. Il caricatore verifica tipo F32 e dimensioni attese, incluse le partizioni richieste dal grafo. Sono controlli di compatibilità dei dati: aiutano a distinguere un file strutturalmente atteso da un formato incompatibile. Non misurano qualità delle risposte né accuratezza sui documenti dell'utente.
Prerelease ufficiale llama.cpp b12192 · Commit verificato: conversione, caricamento e grafo multimodale.
Quale cautela serve con Metal?
Il contributore segnala che due kernel Metal non rispettano set_prec e possono produrre risultati leggermente diversi da quelli attesi. Indica una correzione successiva, non una soluzione inclusa implicitamente nel supporto del modello. Prima di usare questa build su Apple Silicon occorre controllare lo stato aggiornato del problema e confrontare output ripetibili con una baseline verificata. La presenza di un binario macOS non risolve da sola il limite descritto.
llama.cpp: pull request per Mage-VL-Cowork e limite Metal.
Come preparare una prova senza confondere compatibilità e qualità?
Fissare il commit del runtime, annotare il backend e conservare la build precedente. Verificare i file e la licenza nella scheda del modello, poi usare pochi esempi non sensibili con risposte controllabili: lettura di testo in un'immagine, riconoscimento di elementi e una richiesta senza risposta disponibile. Registrare errori di caricamento, output, memoria e tempi separatamente. È un protocollo proposto, non una procedura eseguita qui; estendere il test solo dopo aver riprodotto la baseline.
llama.cpp: pull request per Mage-VL-Cowork e limite Metal · Scheda ufficiale Microsoft Mage-VL-Cowork.
Condizioni e limitazioni
Analisi documentale della prerelease e del diff al merge 9f0e5098a5d5d8adb8dd5c59036ae2a38ab07db9. Nessuna build, inferenza o prova del backend eseguita. La pull request segnala una deviazione di precisione su Metal da correggere separatamente.
Checklist pratica
- Fissare b12192 e verificare il commit completo, senza chiamarla release stabile.
- Annotare sistema, backend, modello e file multimodali effettivamente usati.
- Leggere lo stato del limite Metal prima di scegliere quel backend.
- Provare esempi locali non sensibili con risposte note e conservare gli output.
- Confrontare qualità, memoria e tempi senza attribuire al merge un guadagno mai misurato.
- Mantenere disponibile la build precedente e fermare la prova se gli output divergono.