
L’ANALISI
Granite Speech 5.0: audio locale con LiteRT-LM
Granite Speech 5.0 aggiunge una conversione LiteRT-LM da 2,85 GB e istruzioni Ollama. Encoder su CPU, limiti audio e lingue da verificare.
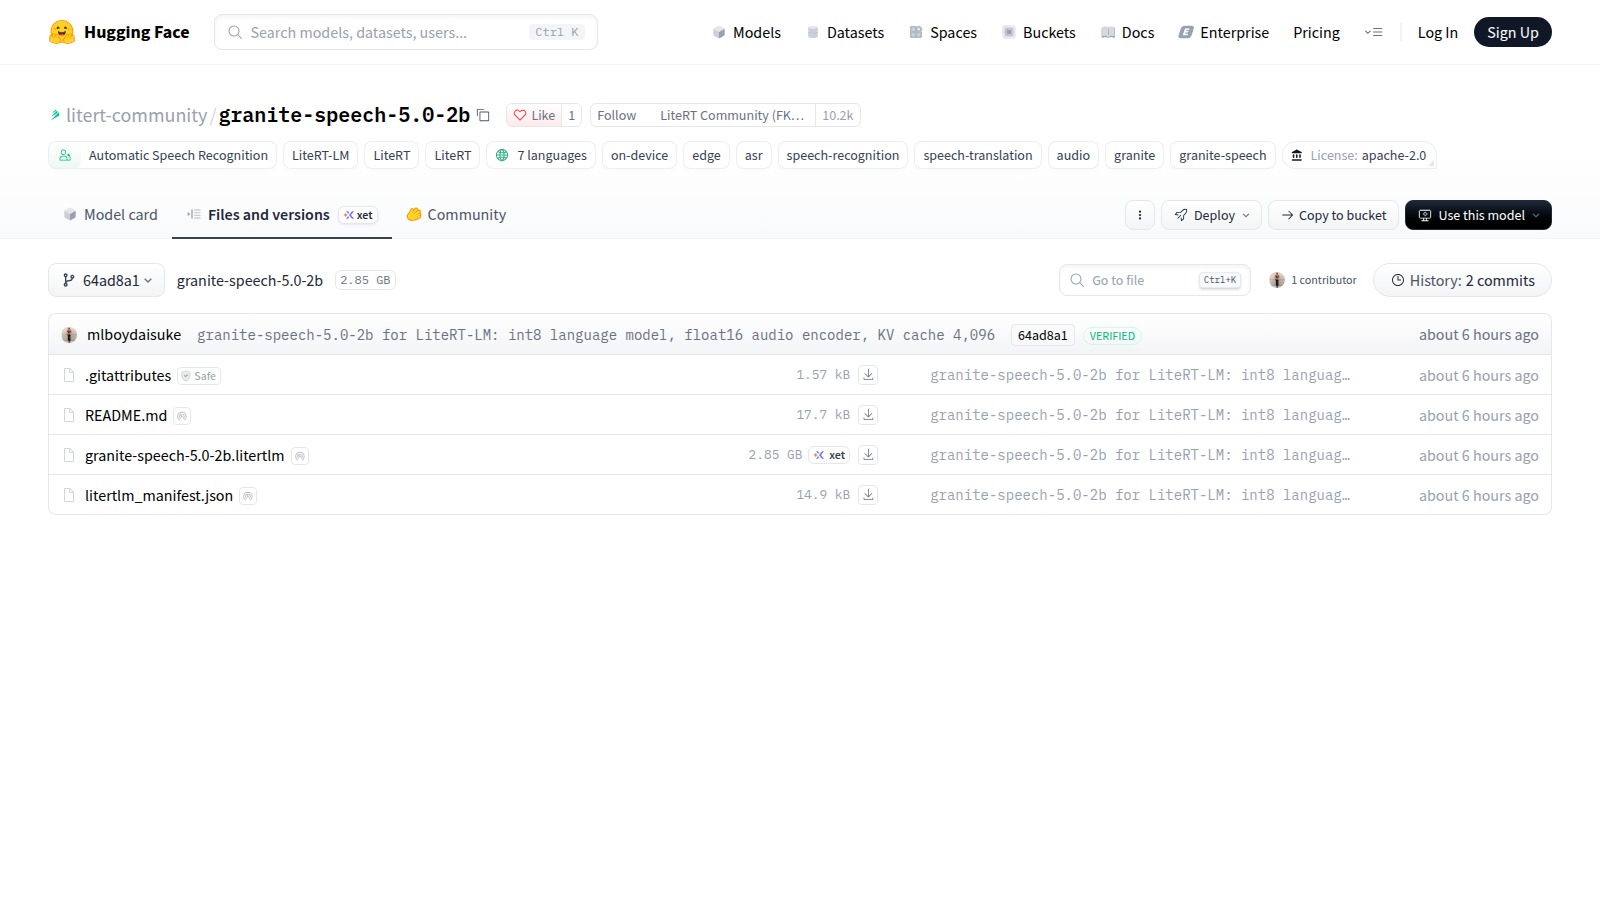
In breve: Granite Speech 5.0 si può valutare con una nuova conversione LiteRT-LM scaricabile, senza confonderla con un nuovo modello IBM. Il file integra encoder audio e modello linguistico; la procedura documentata tiene l'encoder sulla CPU. Per chi vuole trascrivere audio in locale, il primo controllo è la lingua supportata e il secondo è la memoria reale del dispositivo, non la dimensione del download. LiteRT Community: scheda della conversione alla revisione verificata.
Verifica documentale del 6 novembre 2026: confronto tra due revisioni della scheda IBM, lettura della conversione e dei metadati Hugging Face, controllo del manifest pubblico Ollama e della release LiteRT-LM. Nessun modello installato, nessun audio trascritto e nessun benchmark riprodotto in questo ciclo. Le procedure seguenti sono un protocollo proposto, non un test eseguito.
Che cosa cambia il 6 novembre, senza rilanciare il modello?
Il modello IBM ha data di rilascio 20 ottobre. La revisione del 6 novembre aggiunge istruzioni per Ollama e LiteRT-LM; il repository della conversione risulta creato lo stesso giorno. Questo cambia il punto di partenza di una prova: esiste un file da acquisire e una configurazione dichiarata, invece di dover costruire da zero la conversione. Non dimostra però equivalenza su qualsiasi dispositivo. Il manifest della conversione reca la data 7 novembre: per la disponibilità qui si usano i timestamp UTC del repository, non quel campo isolato.
IBM Granite Speech 5.0: istruzioni, lingue e limiti · IBM Granite Speech: cronologia delle revisioni · Hugging Face: identità, data e dimensioni della conversione · LiteRT Community: manifest della conversione.
LiteRT-LM: che cosa scaricare e quale backend scegliere?
La scheda della conversione specifica LiteRT-LM 0.19.1, pesi int8 per il modello linguistico e float16 per l'encoder audio. Richiede audio mono a 16 kHz; l'encoder resta sulla CPU, mentre il modello linguistico può usare CPU o GPU. Il contesto è di 4.096 token complessivi, ingresso e risposta inclusi. La procedura consiglia una conversazione nuova per ogni clip. Per una prima prova controllata conviene mantenere entrambi i backend sulla CPU, conservare l'output e cambiare una sola opzione alla volta. È una scelta metodologica, non una promessa di maggiore velocità.
LiteRT Community: scheda della conversione alla revisione verificata · LiteRT-LM 0.19.1: release ufficiale.
Ollama è disponibile, ma download e RAM sono cose diverse
La pagina ufficiale espone ibm/granite5-speech:2b e il registro restituisce un manifest con modello Q8_0 e proiettore separato. Il file LiteRT-LM pesa 2,85 GB: nessuna delle due dimensioni basta per dedurre la RAM necessaria. Per confrontare i percorsi serve lo stesso audio, con identiche istruzioni e una trascrizione di riferimento. Registrare separatamente avvio a freddo, tempo della trascrizione completa, picco di memoria e output consente di decidere sul dispositivo concreto. Non usare i token al secondo del solo modello linguistico come misura dell'intera pipeline audio.
LiteRT Community: scheda della conversione alla revisione verificata · Ollama: pagina IBM granite5-speech · Ollama: manifest pubblico del tag 2b.
L'italiano è una lingua di trascrizione supportata?
IBM elenca inglese, francese, tedesco, spagnolo, portoghese e giapponese per il riconoscimento vocale. L'italiano compare come destinazione della traduzione dall'inglese, non come supporto dichiarato alla trascrizione di parlato italiano. Perciò un progetto su riunioni italiane non dovrebbe scegliere questo modello solo perché la scheda contiene la parola Italian. Un eventuale test italiano va separato dalle lingue supportate, con errori annotati e senza presentarlo come capacità garantita. Anche i risultati pubblicati dall'autore della conversione restano misure del produttore dell'artefatto, non nostre prove indipendenti.
LiteRT Community: scheda della conversione alla revisione verificata · IBM Granite Speech 5.0: istruzioni, lingue e limiti · Ollama: pagina IBM granite5-speech.
Condizioni e limitazioni
Nessuna prova locale eseguita. La conversione è pubblicata da litert-community e richiamata dalla scheda IBM; ciò non rende ogni benchmark indipendente. Il download da 2,85 GB non è una stima RAM. La trascrizione italiana non è tra le lingue dichiarate; l'italiano è indicato come output di traduzione dall'inglese.
Checklist pratica
- Fissare la revisione 64ad8a15af02278537ec7e307e0f3caef4371656 della conversione e conservare il manifest insieme al file.
- Verificare il checksum pubblicato c90a3dae17d3399acbce3f9642a308d65bd0214134ce958562dbb2ef90337265 dopo il download; questo ciclo ha controllato il metadato, non scaricato i pesi.
- Preparare una breve clip mono a 16 kHz in una lingua supportata, con testo di riferimento e senza dati personali o di clienti.
- Per il percorso LiteRT-LM seguire la versione 0.19.1 documentata, encoder audio su CPU e una nuova conversazione per ogni clip.
- Annotare dispositivo, sistema, backend, prompt, durata dell'audio, tempo totale, memoria e trascrizione; distinguere avvio a freddo e modello già caricato.
- Confrontare l'eventuale percorso Ollama sulla stessa clip; verificare l'esecuzione senza rete solo dopo avere acquisito dipendenze e pesi.
- Tenere la traduzione inglese-italiano separata dalla trascrizione di italiano e non trasferire risultati tra le due attività.