
L’ANALISI
Arete-27B: cosa cambia nel fine-tuning di Qwen
Arete-27B applica SFT a Qwen3.8-27B: Nous pubblica pesi e una valutazione su 803 prompt. Cosa misura il test e cosa resta da verificare.
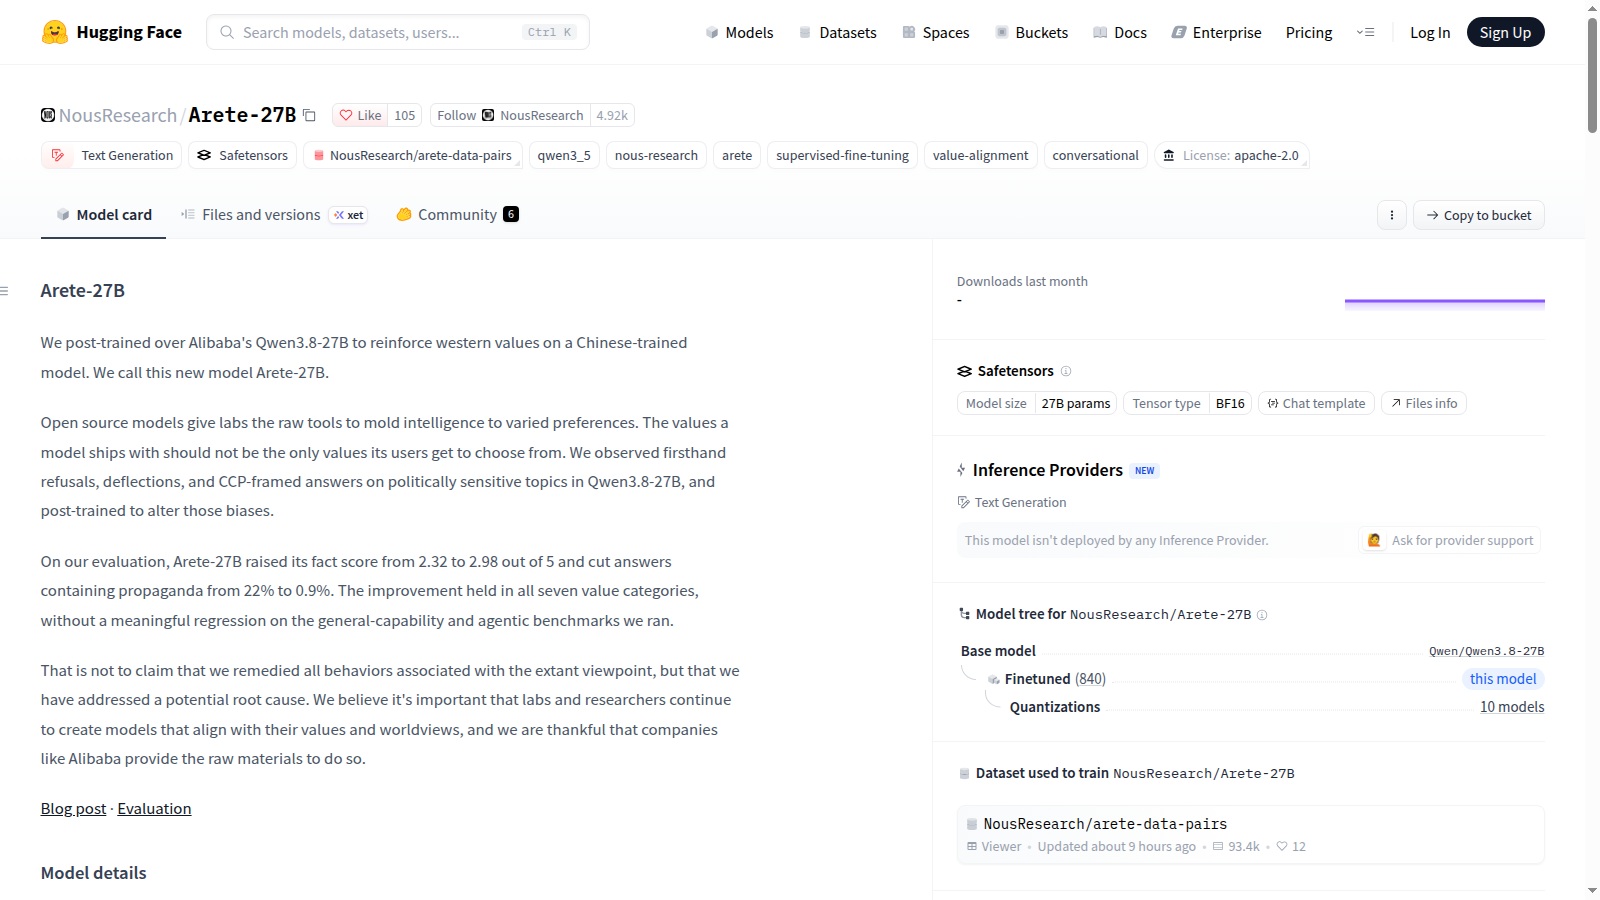
In breve: Arete-27B è un insieme di pesi derivati da Qwen3.8-27B tramite supervised fine-tuning, non una nuova architettura. È interessante per chi vuole studiare come il post-training modifichi il comportamento: prima di sostituire il modello base serve una valutazione propria, separata dai numeri di Nous. Nous Research: model card Arete-27B, revisione verificata.
Verifica documentale del 7 novembre 2026: model card fissata alla revisione 108f0afbdcfaa1ceeda4a635004304dfff6d4da2, annuncio e scheda della valutazione. Non sono stati scaricati i pesi né eseguita inferenza; la checklist seguente è un protocollo proposto.
Che cosa cambia rispetto al modello base?
La model card dichiara SFT con teacher Inkling e soli dati testuali, senza reinforcement learning né modifiche architetturali. L’obiettivo dichiarato da Nous è cambiare il punto di vista del modello su sette categorie di valori. È quindi una modifica comportamentale deliberata: non conviene descriverla come semplice rimozione di errori o come un modello privo di orientamento. Il repository rende il confronto con il modello di partenza un esperimento possibile, non già concluso per ogni utilizzatore.
Nous Research: model card Arete-27B, revisione verificata · Hugging Face: revisione e file pubblici di Arete-27B.
Come leggere i numeri senza confondere la metrica con il risultato?
Il produttore riporta 2,98 contro 2,32 su cinque e 0,9% contro 22% nella quota etichettata dalla propria rubric come «any propaganda». Il confronto Arete-Qwen usa thinking disattivato e temperatura zero; le altre righe della classifica non condividono tutte gli stessi parametri. Prima di riutilizzare un numero occorre capire che cosa il giudice premia, che cosa penalizza e su quali domande. Una diminuzione della categoria valutata non equivale a un audit generale di affidabilità.
Nous Research: model card Arete-27B, revisione verificata · Propaganda_Eval: dataset e criteri della valutazione.
Perché questo caso non sostituisce il RAG?
La distinzione pratica da verificare è fra comportamento desiderato e conoscenza da recuperare. Per un assistente documentale proporrei due prove separate: una sulle risposte a fonti fornite nel contesto, l’altra sul modo di trattare domande controverse senza documenti. Se si mescolano i due problemi, un miglioramento di stile può nascondere un recupero scarso o una risposta non supportata. La guida RAG vs fine-tuning collegata sotto serve a impostare questa scelta, non certifica Arete.
Nous Research: model card Arete-27B, revisione verificata.
Quale confronto fare prima di usarlo?
Un protocollo utile parte da prompt italiani tenuti fuori dal set di sviluppo e dagli stessi parametri per base e derivato. Separerei fatti corretti, omissioni, rifiuti e framing, con una lettura umana dei casi divergenti. Aggiungerei compiti ordinari del proprio assistente per cercare regressioni, registrando revisione, template e impostazioni. Il criterio di adozione andrebbe deciso prima di leggere i risultati. Questa è una proposta di test: non ci sono misure locali o un vincitore operativo da riportare.
Nous Research: annuncio e obiettivi di Arete · Propaganda_Eval: dataset e criteri della valutazione.
Condizioni e limitazioni
Valutazione del produttore con giudice automatico, non replicata qui. I risultati non dimostrano neutralità generale né qualità in italiano; il training testuale non prova nuove capacità visive.
Checklist pratica
- Fissare la revisione dei pesi e leggere la licenza dichiarata, senza confondere accessibilità e adeguatezza al proprio impiego.
- Preparare un insieme italiano tenuto fuori dallo sviluppo, con fonti e criteri di valutazione espliciti.
- Confrontare base e Arete usando gli stessi template, thinking, temperatura e limiti di output.
- Rivedere manualmente errori, omissioni e rifiuti; tenere separata la rubric del produttore.
- Registrare memoria, latenza e regressioni prima di decidere un’eventuale sostituzione.