
L’ANALISI
llama.cpp: cosa cambia nella cache MoE ClassLRU
llama.cpp b12170 introduce ClassLRU per la cache degli esperti MoE: otto classi e frequenza decadente. È una prerelease, non un test locale.
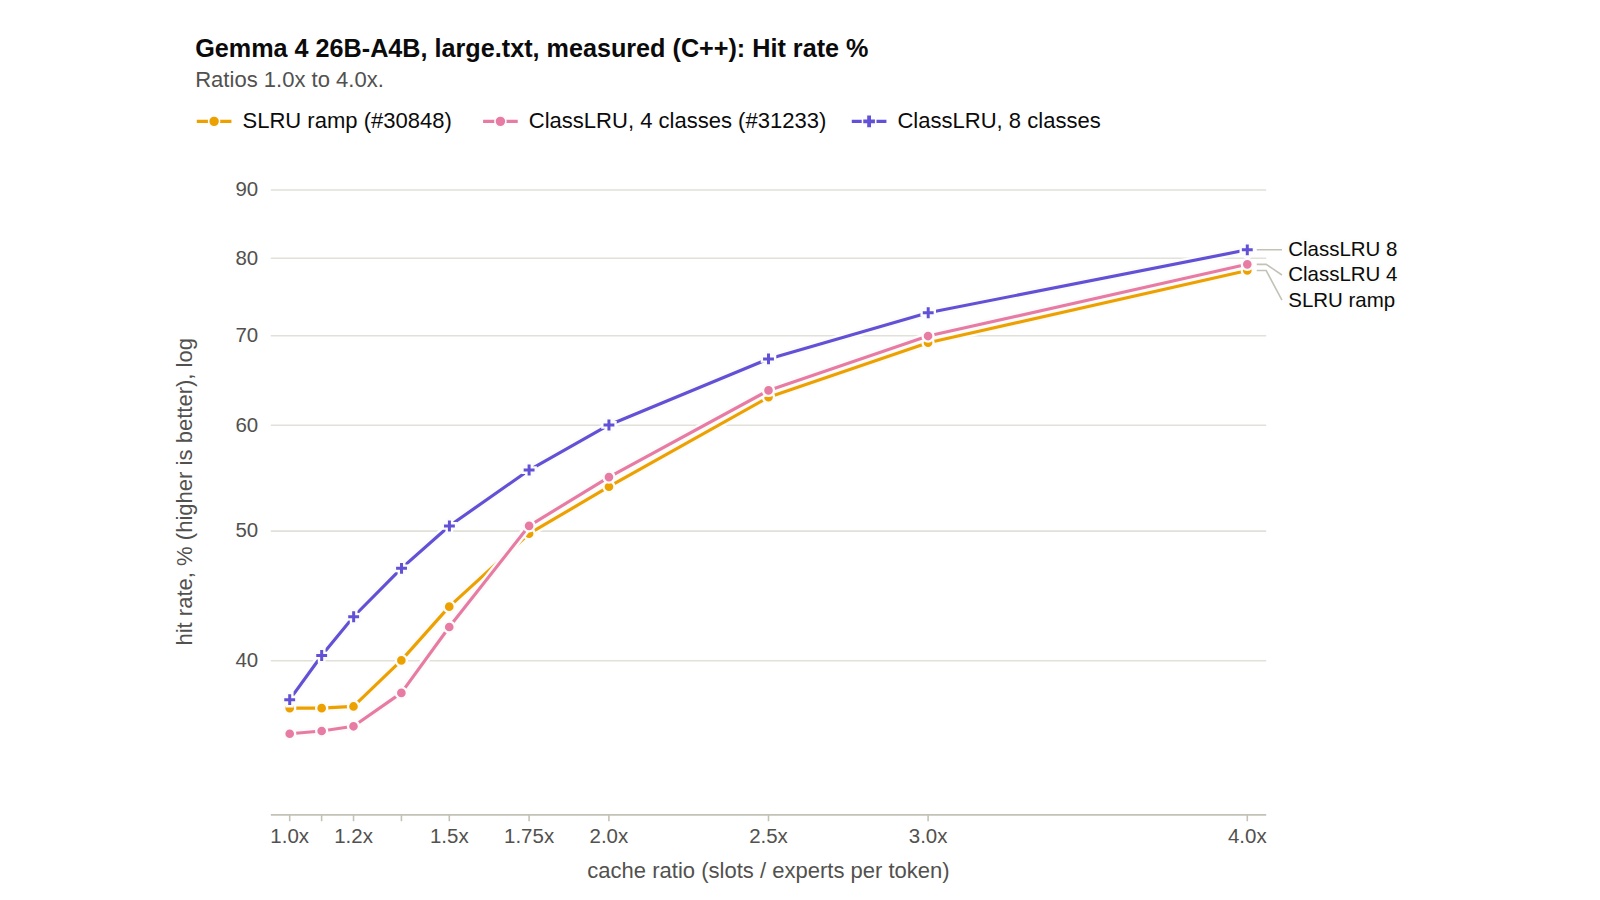
In breve: llama.cpp b12170 aggiorna la politica della cache degli esperti MoE con ClassLRU. Cambia il criterio di permanenza degli esperti, non il modello scaricato. La release esiste nell’API ufficiale ed è contrassegnata come prerelease. llama.cpp: PR #31233, cache ClassLRU e condizioni dei test.
Verifica documentale del 6 novembre 2026 su release REST, PR integrata e sorgente fissato al commit c4fb579695320929b6a453f4f3a56951bda332ee. Non è un benchmark indipendente. La procedura di confronto sotto è una proposta redazionale e non è stata eseguita.
Che cosa cambia rispetto alla politica precedente?
La PR descrive un punteggio che combina uso recente e frequenza, con decadimento nel tempo e otto classi. Anche un esperto prima molto usato può perdere protezione se non torna utile. Il sorgente della release permette di ispezionare il criterio effettivo senza confonderlo con una proposta ancora aperta. La conseguenza editoriale è circoscritta: abbiamo una nuova implementazione da confrontare, non una percentuale garantita per ogni modello.
llama.cpp: PR #31233, cache ClassLRU e condizioni dei test · llama.cpp: sorgente della cache al commit della release.
Perché separare cache calda e partenza a freddo?
Il contributore qualifica i risultati come misure a cache calda e segnala limiti con cache molto piccole. Per una prova propria proponiamo quindi due serie separate: la prima richiesta dopo l’avvio e le richieste ripetute. Non mescolare quei tempi in un unico valore evita di presentare come miglioramento generale un effetto che appare soltanto dopo il riscaldamento. Conservare anche il tempo necessario a raggiungere il regime scelto.
llama.cpp: PR #31233, cache ClassLRU e condizioni dei test.
Come impostare un confronto controllato?
Protocollo proposto, non eseguito: congelare modello, quantizzazione, input, parametri di generazione, backend e dimensione della cache. Confrontare due revisioni note cambiando soltanto l’implementazione sotto esame. Alternare l’ordine delle prove e ripetere lo stesso insieme di richieste; archiviare comando, versione e log completi. Se altre modifiche separano le due build, dichiararle come possibile confondente anziché attribuire automaticamente tutto a ClassLRU.
Quali misure servono prima di aggiornare?
Nel protocollo proposto registriamo separatamente tempo al primo token, elaborazione dell’input, decodifica, memoria e correttezza delle risposte attese. Una cache diversa va giudicata sul compito completo, non soltanto sulla metrica migliore. Decidere prima quale regressione rende inaccettabile l’aggiornamento; se il guadagno resta dentro la variabilità delle ripetizioni, conservarlo come risultato inconcludente. La disponibilità di un binario non sostituisce questa decisione.
Condizioni e limitazioni
Il contributore riporta benefici di decodifica a cache calda, ma anche casi meno favorevoli con cache molto piccole. Non abbiamo compilato questa build né misurato velocità o correttezza sul nostro hardware. Nessuna accelerazione universale è dimostrata.
Checklist pratica
- Verificare b12170 e il commit c4fb579695320929b6a453f4f3a56951bda332ee; annotare il flag prerelease.
- Conservare la build precedente e una procedura di ripristino prima di sostituirla.
- Fissare modello, quantizzazione, backend, cache e richieste di confronto.
- Separare partenza a freddo, riscaldamento e richieste a regime.
- Misurare input e decodifica separatamente, con più ripetizioni e controllo delle risposte.
- Non trasferire i risultati del contributore alla propria macchina senza una prova dedicata.