
L’ANALISI
llama.cpp: ReBAR e gestione della memoria Vulkan
llama.cpp b12171 rileva ReBAR e cambia le allocazioni Vulkan quando manca il supporto. La build è una prerelease, non un benchmark locale.
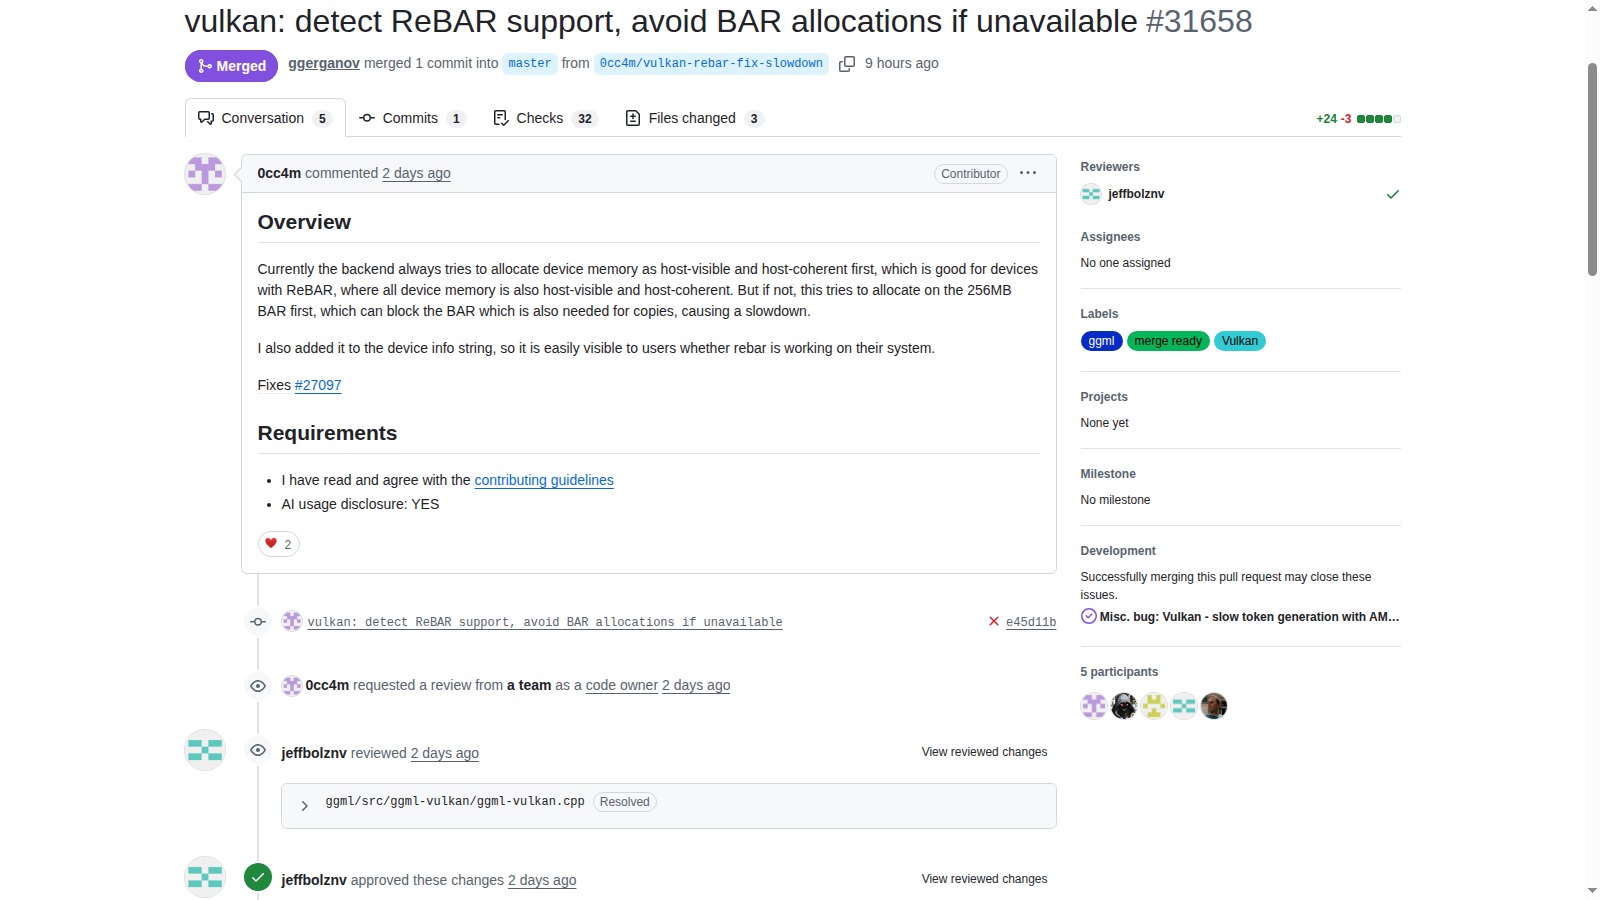
In breve: llama.cpp b12171 include una correzione Vulkan che rileva ReBAR prima di scegliere determinate allocazioni di memoria. La PR collega il vecchio comportamento a un possibile rallentamento senza ReBAR. La presenza della correzione è verificata; il vantaggio prestazionale locale no. llama.cpp: PR #31658, problema e integrazione.
Verifica documentale del 6 novembre 2026 su API ufficiale della release, PR integrata e diff dei tre file modificati. La PR risulta unita al commit 80088fa60b439dd285206b9b665465a8337c59b6; GitHub marca b12171 come prerelease. Nessuna compilazione, installazione o prova GPU eseguita in questo ciclo.
Quale problema corregge senza ReBAR?
Secondo il contributore, il backend provava prima memoria locale al dispositivo e contemporaneamente visibile e coerente per l’host. Senza ReBAR quel tentativo poteva occupare la BAR da 256 MB, necessaria anche alle copie. Il cambiamento evita quel percorso quando il supporto non viene rilevato. Non significa aumentare la VRAM fisica né cambiare i pesi del modello.
llama.cpp: PR #31658, problema e integrazione · llama.cpp: diff dei file della correzione ReBAR.
Come viene rilevato il supporto nel codice?
Il diff aggiunge una funzione che esamina le proprietà di memoria esposte dal dispositivo Vulkan e registra un booleano rebar. La scelta del percorso di allocazione usa quel valore insieme all’opzione già esistente per disabilitare la memoria video visibile all’host. La stringa diagnostica di debug guadagna il campo rebar: un punto utile da conservare nei log, non una certificazione completa della configurazione hardware.
llama.cpp: diff dei file della correzione ReBAR.
Quale versione contiene il delta verificato?
La PR risulta integrata il 6 novembre 2026 e la release b12171 la cita esplicitamente. Nell’API la release è una prerelease: un tag numerato e binari scaricabili non equivalgono a una versione stabile. Per una prova riproducibile annotare la revisione effettiva del binario, senza attribuire automaticamente alla sola correzione ReBAR tutti i cambiamenti di una build successiva.
llama.cpp: PR #31658, problema e integrazione · llama.cpp: release REST b12171 e stato prerelease.
Come valutare l’aggiornamento senza confondere le cause?
Protocollo proposto, non eseguito: conservare il binario precedente e congelare modello, quantizzazione, prompt, driver, backend e parametri. Registrare i log del dispositivo e confrontare elaborazione dell’input, generazione e memoria in più ripetizioni. Separare l’effetto da FWHT, Split-K e cache MoE. Se le revisioni differiscono anche altrove, trattare il confronto come non isolato e non pubblicare percentuali attribuite solo a ReBAR.
Condizioni e limitazioni
La correzione riguarda una condizione di allocazione, non dimostra un’accelerazione generale su AMD o altre GPU. Non abbiamo compilato la build né confrontato prestazioni sul dispositivo. Il rilevamento dipende dalle proprietà di memoria esposte a Vulkan; non è una diagnosi completa del firmware.
Checklist pratica
- Verificare la release b12171 e il suo flag prerelease prima di scegliere un binario.
- Conservare build precedente, revisione, driver e procedura di ripristino.
- Usare il backend Vulkan pertinente e raccogliere i log diagnostici disponibili.
- Tenere invariati modello, quantizzazione, input e parametri di generazione.
- Ripetere il confronto e controllare sia tempi sia correttezza dell’output.
- Non modificare firmware o impostazioni hardware sulla base di questo solo aggiornamento.