
L’ANALISI
llama.cpp b12143: FWHT Vulkan in F16 fino a 8192
llama.cpp b12143 estende il FWHT Vulkan a input F16 e blocchi fino a 8192. Prerelease: requisiti GPU, fallback e test upstream dichiarati.
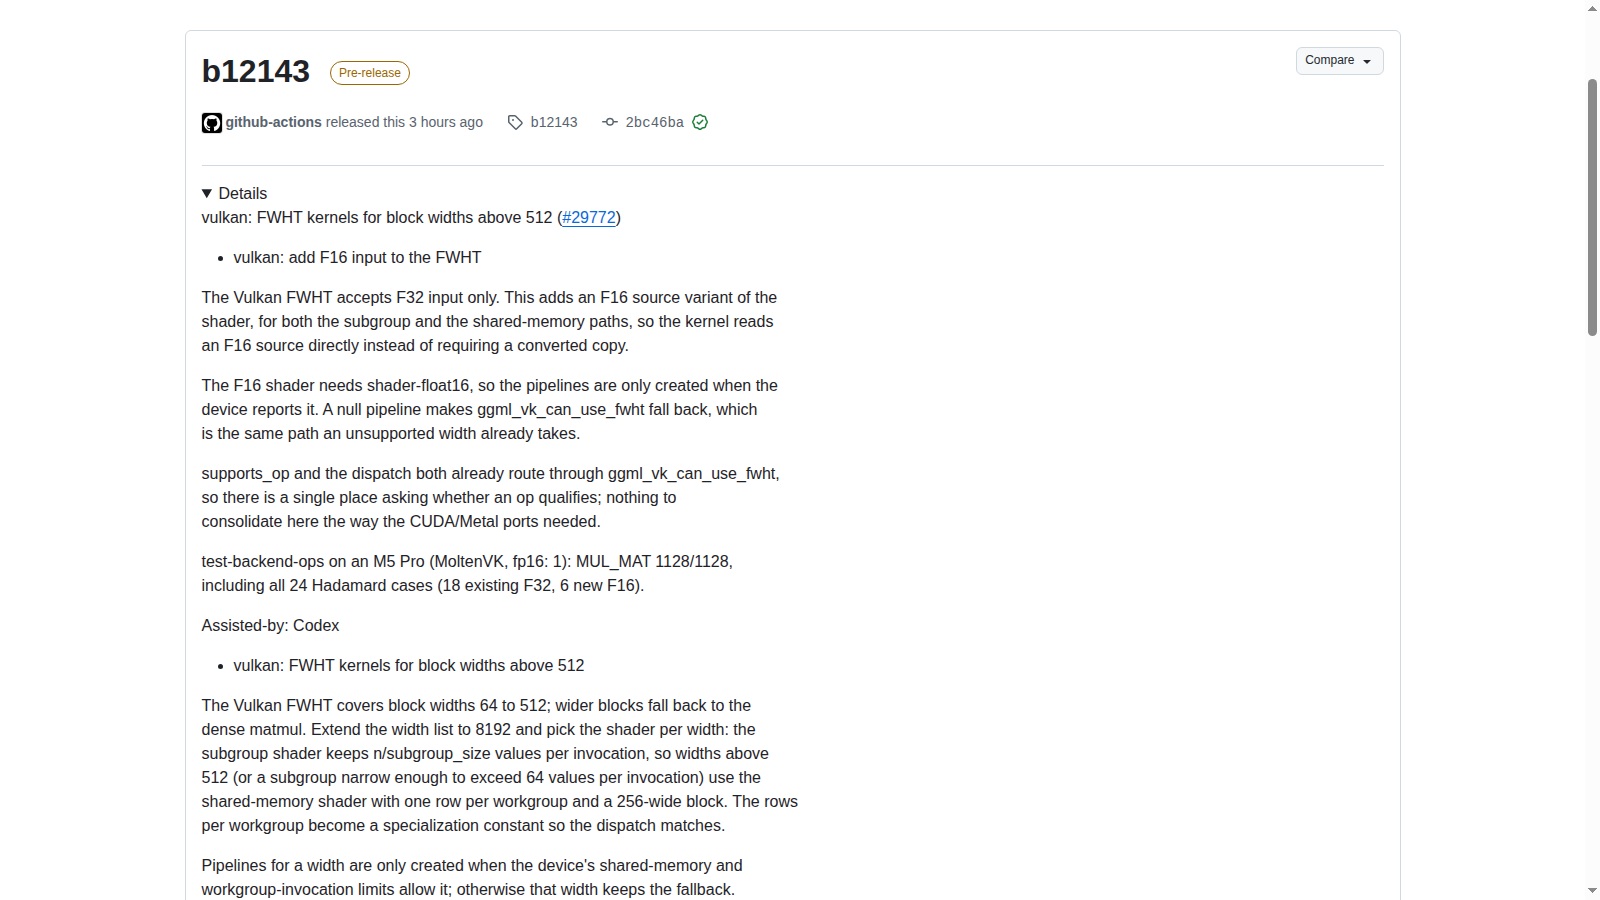
In breve: La b12143 estende il kernel FWHT del backend Vulkan: aggiunge la lettura diretta di input F16 e larghezze di blocco fino a 8192, dove il dispositivo soddisfa i requisiti. GitHub la identifica come prerelease. Non è una prova che ogni modello o GPU diventi più veloce: per verificarlo serve un confronto sul carico effettivamente usato. llama.cpp b12143: note ufficiali della prerelease.
Analisi delle note ufficiali della release b12143 e del relativo oggetto GitHub REST, verificati il 6 novembre 2026. Non è stato compilato o eseguito questo backend e non è stato riprodotto il test sul dispositivo citato dall’upstream.
Che cosa aggiunge il percorso F16?
Secondo le note ufficiali, il FWHT Vulkan accettava soltanto input F32. La modifica introduce una variante dello shader che legge direttamente una sorgente F16, sia nel percorso subgroup sia in quello basato sulla memoria condivisa. Non è un nuovo formato dei pesi e non cambia automaticamente la quantizzazione del modello. Il cambiamento elimina, per questa operazione e per la variante supportata, la necessità della copia convertita descritta dall’upstream. Non fornisce da solo una misura del tempo risparmiato durante una conversazione completa.
llama.cpp b12143: note ufficiali della prerelease.
Che cosa significa arrivare a blocchi di larghezza 8192?
L’upstream indica che il percorso precedente copriva larghezze da 64 a 512 e usava una moltiplicazione densa di fallback per blocchi maggiori. La nuova lista si estende fino a 8192. Per larghezze superiori a 512, oppure quando il subgroup avrebbe troppi valori per invocazione, viene scelto lo shader a memoria condivisa con una riga per workgroup e blocco di larghezza 256. Questi numeri descrivono l’organizzazione del kernel: 8192 non è la finestra di contesto del modello, né un limite di token generati.
llama.cpp b12143: note ufficiali della prerelease.
Quali condizioni deve soddisfare la GPU?
La variante F16 richiede che il dispositivo dichiari shader-float16. Le pipeline per una data larghezza vengono create soltanto quando i limiti di memoria condivisa e di invocazioni del workgroup lo consentono. In caso contrario rimane il fallback. Di conseguenza, vedere Vulkan tra i backend disponibili non certifica l’uso della nuova variante: il percorso effettivo dipende dalle capacità riportate dal dispositivo e dall’operazione eseguita. Prima di attribuire un risultato alla modifica occorre verificare che il test stia davvero attraversando quel percorso.
llama.cpp b12143: note ufficiali della prerelease.
Che cosa dimostrano i test citati nella release?
Le note riportano test-backend-ops su M5 Pro con MoltenVK e fp16 abilitato: MUL_MAT 1128/1128, includendo 24 casi Hadamard, di cui 18 F32 esistenti e 6 nuovi F16. È una dichiarazione di verifica funzionale dell’upstream in quelle condizioni, non un benchmark riprodotto su questa macchina e non una misura della velocità dell’intero modello. Non va estesa senza prova a driver diversi, altre GPU o tutte le possibili larghezze. L’oggetto REST identifica inoltre b12143 come prerelease pubblicata il 6 novembre alle 02:48:02 UTC.
llama.cpp b12143: note ufficiali della prerelease; GitHub REST: data, commit e stato prerelease di b12143.
Quando ha senso provarla invece di aggiornare alla cieca?
La prova è pertinente se il carico usa Vulkan e l’operazione FWHT interessata. Un confronto utile conserva lo stesso GGUF, lo stesso prompt, gli stessi parametri di contesto e gli stessi driver, cambiando soltanto la build. Registrare separatamente esito funzionale, caricamento, prefill e generazione evita di attribuire al kernel una differenza dovuta ad altro. Questa è una procedura consigliata, non un test eseguito. Per una macchina di lavoro è prudente conservare la build precedente e promuovere l’aggiornamento solo dopo controlli sul proprio carico, senza trattare la prerelease come release stabile.
llama.cpp b12143: note ufficiali della prerelease; GitHub REST: data, commit e stato prerelease di b12143.
Checklist pratica
- Controllare che l’artefatto scelto corrisponda al tag b12143 e annotare il suo stato prerelease.
- Verificare backend effettivo, driver e disponibilità di shader-float16 sul dispositivo.
- Tenere uguali modello, quantizzazione, prompt, contesto e impostazioni del confronto.
- Registrare eventuali fallback e non interpretarli automaticamente come errori.
- Separare correttezza dell’operazione, prefill e generazione: il test upstream non misura i token al secondo.
- Conservare la build precedente e tornare indietro se correttezza o stabilità peggiorano.
Condizioni e limiti
È una prerelease. I test su M5 Pro sono dichiarati dall’upstream e non riprodotti qui; nessun incremento di token al secondo o compatibilità con la singola GPU è stato misurato. I casi non supportati mantengono il fallback.