
LA SETTIMANA IN AI
26 ottobre – 1 novembre 2026
Heretic 2.0 cambia configurazioni e plugin; DeepSeek distingue permessi e isolamento. Mistral, Pipecat e llama.cpp aggiornano lo stack AI.
In questa settimana 30 notizie
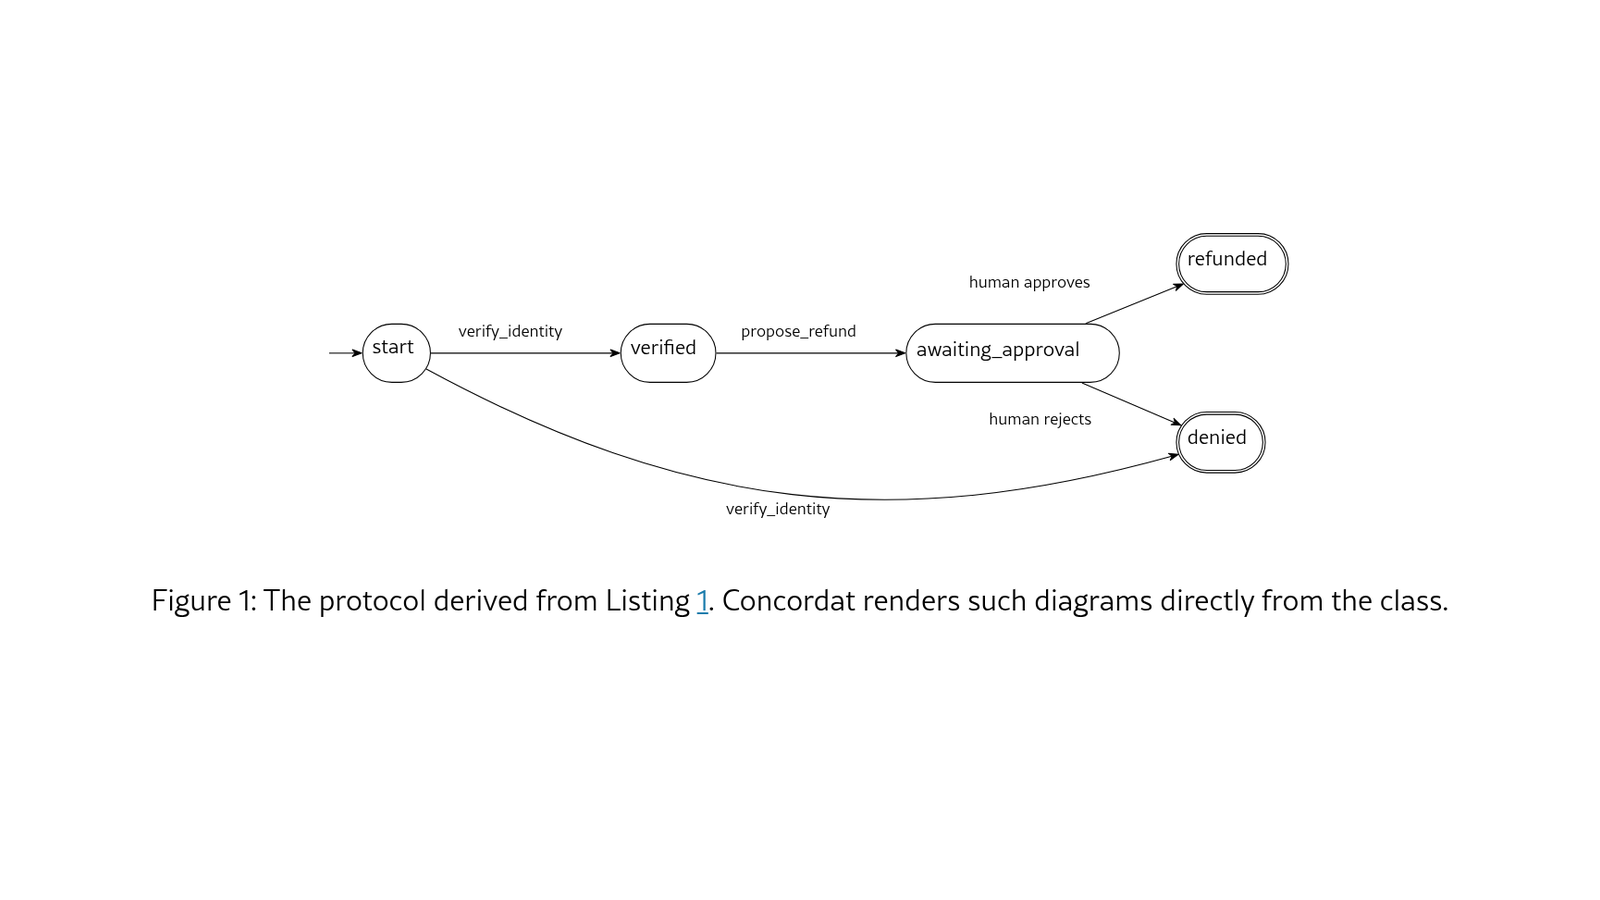
Concordat aggiunge al confronto sugli agenti una distinzione utile: completare il lavoro e avere il permesso di completarlo sono due misure diverse. Il contributo pratico è la restrizione dei tool per stato; il limite da non perdere è che una definizione povera di conferma rimane povera anche quando viene applicata perfettamente.
Limiti da conoscere
Limite: Preprint e libreria pre-alpha, non validazione indipendente. Il test riguarda un dominio, due modelli e clienti simulati. Il riconoscimento della conferma usa parole come yes, yep e yeah: lo zero di violazioni è relativo a questa definizione, non prova un consenso semanticamente valido. Radar non ha installato la libreria né ripetuto il benchmark.
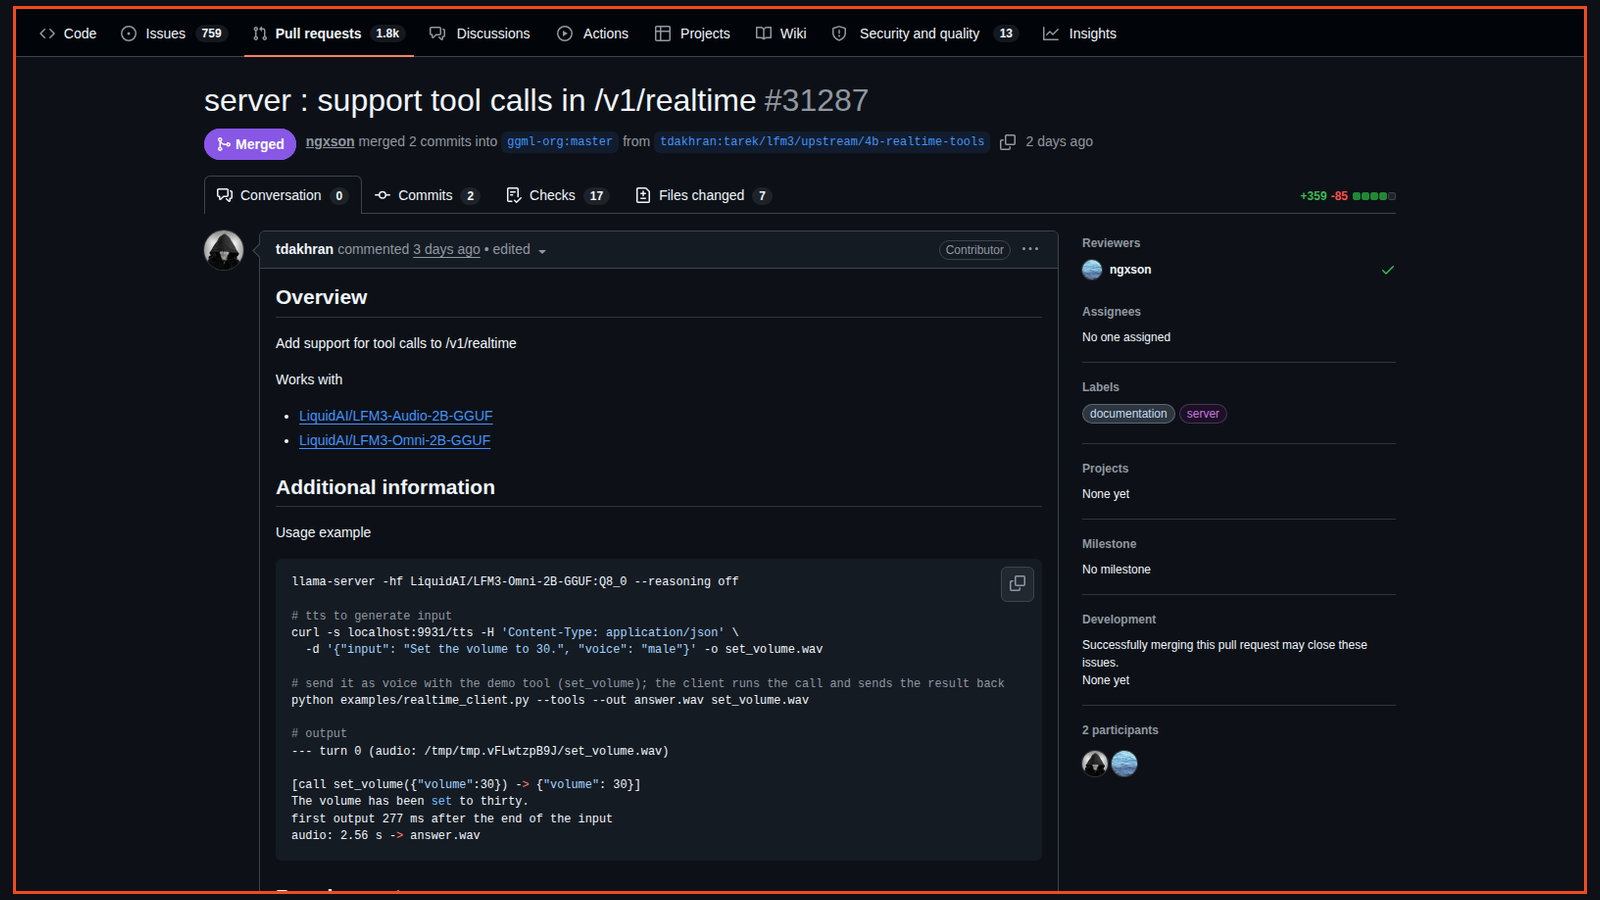
Il delta realtime di llama.cpp porta il confronto dall’audio generato al ciclo completo richiesta, funzione e risultato. Accanto ai protocolli di autorizzazione, mette in evidenza un altro confine: il server può strutturare una chiamata, ma è l’applicazione che deve decidere se e come eseguirla e verificare che l’azione sia davvero avvenuta.
Limiti da conoscere
Limite: È un tag e un cambiamento integrato nel repository, non una release stabile confermata via REST. Radar non ha compilato llama.cpp, scaricato modelli o eseguito conversazioni vocali. Il client dimostrativo set_volume restituisce un oggetto JSON: non modifica il volume del sistema e non prova il controllo di un dispositivo reale.
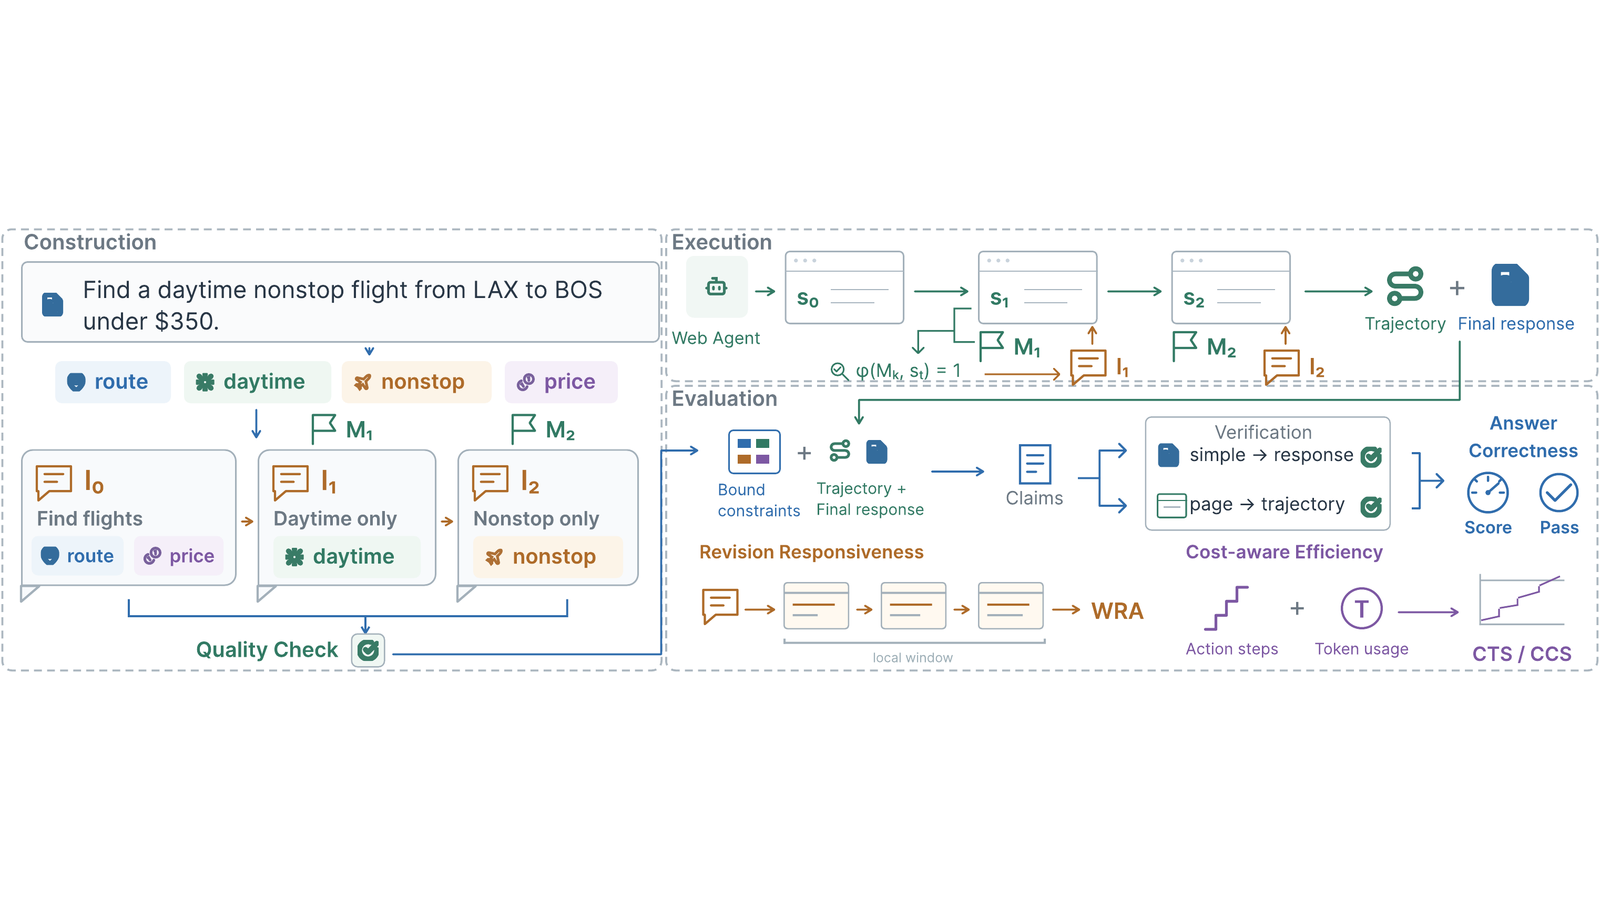
DynaRev aggiunge un criterio di qualità che una richiesta statica non cattura: mantenere coerente l’obiettivo mentre cambia. La scelta di architettura proposta è separare istruzione attiva e stato di esecuzione, misurando il risultato dopo ogni revisione invece di premiare soltanto una risposta rapida.
Limiti da conoscere
Limite: È un preprint con valutatori LLM e compiti derivati da benchmark statici. Il confronto tra strategie usa un modello e un sottoinsieme di compiti. Il repository è stato letto, non installato o eseguito; le istruzioni correnti del 30 ottobre non sono retrodatate alla submission del 29.
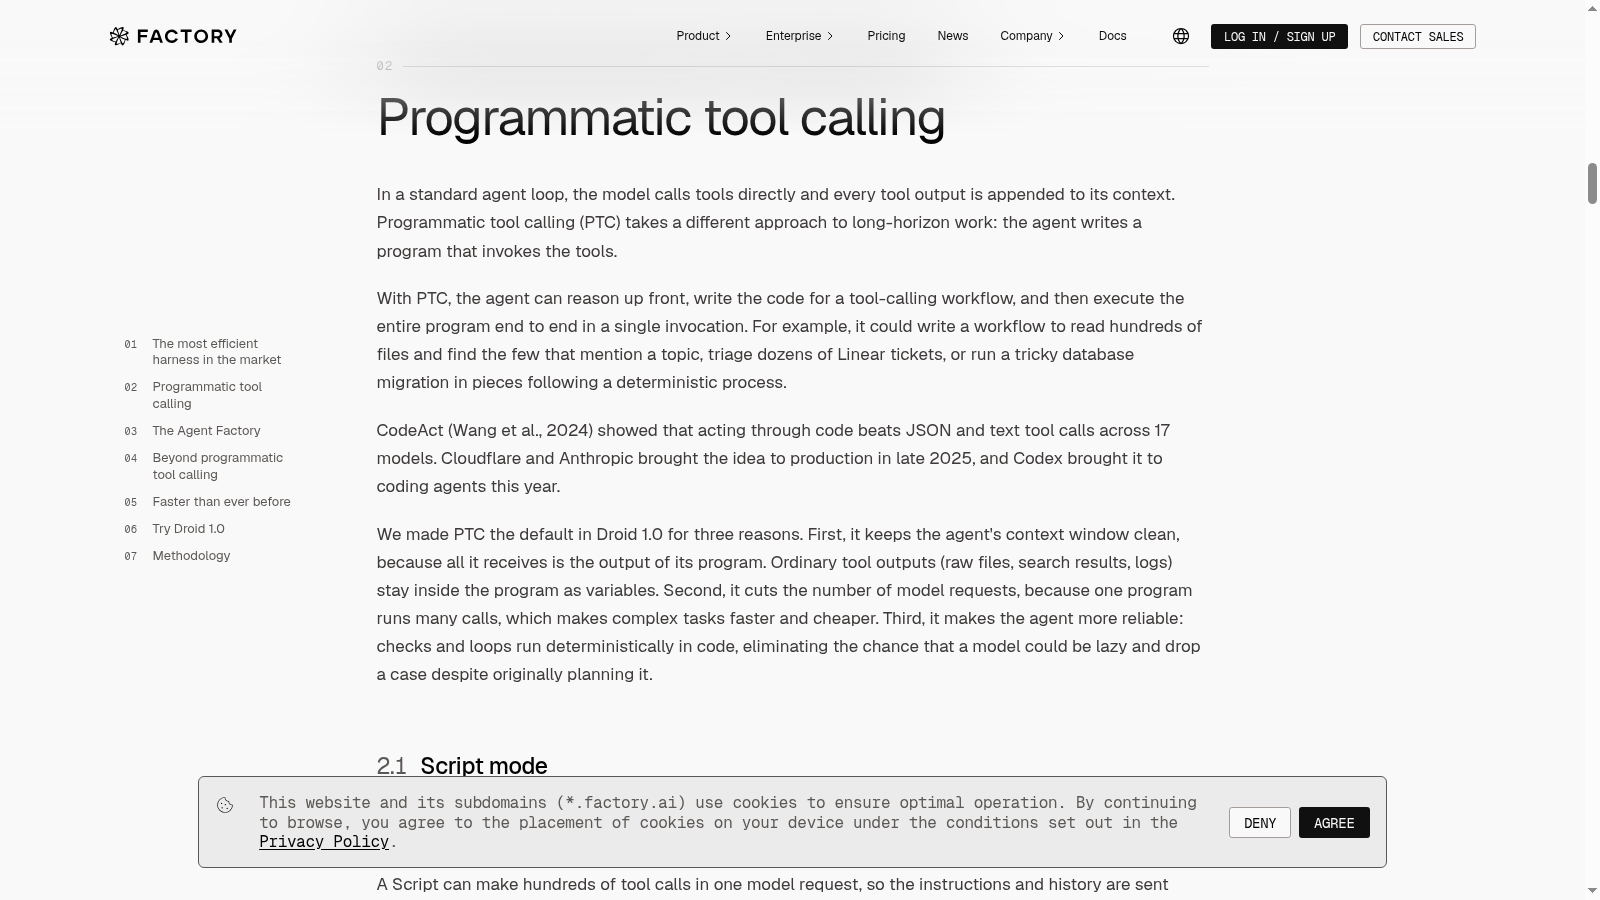
DynaRev studia come un agente cambia obiettivo; Factory interviene invece sul ciclo che esegue gli strumenti. Raggruppare e filtrare i risultati può ridurre lavoro ripetuto, ma il vantaggio va misurato per modello e compito, separando costo, tempo e riuscita.
Limiti da conoscere
Limite: Documentazione e benchmark del produttore, non una prova runtime nell'account di Francesco. Meno chiamate al modello non garantisce meno tempo totale o risultati migliori in ogni compito. L'annuncio è del 29 ottobre; il changelog del client riporta separatamente la versione 1.1.0 del 30 ottobre.
Nella settimana degli agenti, questa operazione sposta l'attenzione dal singolo modello al controllo dello stack vocale. La decisione pratica non è scegliere subito un nuovo fornitore, ma capire quanto dipendono da esso trasporto, orchestrazione e assistenza. Il segnale da seguire dopo l'annuncio del 29 ottobre sarà la pubblicazione delle regole della foundation, insieme a prove ripetibili di cambio provider e a un conto completo dei costi.
Limiti da conoscere
Limite: Sono state verificate due comunicazioni delle parti, non documenti di closing, statuto o funzionamento della foundation. Neutralità, continuità commerciale e interoperabilità restano impegni dichiarati, non risultati misurati. Nessun agente vocale, benchmark, listino o risparmio è stato testato in questa verifica.
Large 4 sposta la decisione dall’accesso al modello alla gestione del deployment: diversamente dalle API degli altri annunci, qui il punto è assumersi hardware, runtime e verifica della licenza.
Limiti da conoscere
Limite: Open weight non equivale a licenza MIT senza condizioni: il Model-as-a-Service richiede un accordo commerciale separato. Non è stato eseguito un test locale del checkpoint. (scheda Hugging Face)
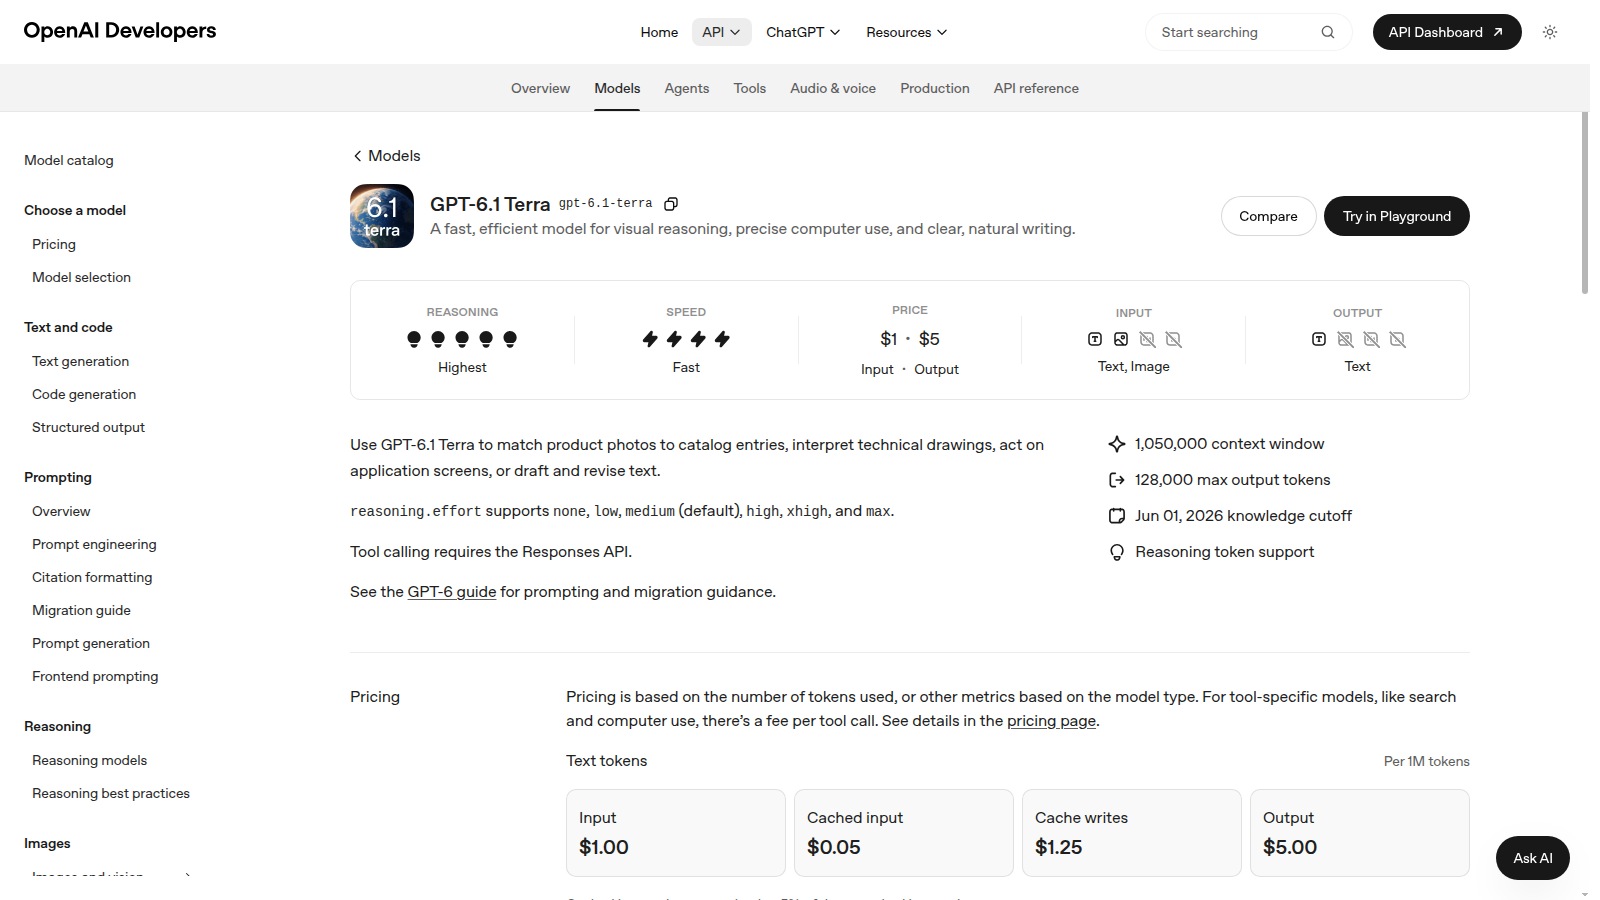
Terra è il percorso cloud da provare su un compito circoscritto; il confronto con Large 4 deve includere il confine dei dati e l’orchestrazione, non soltanto un punteggio del modello.
Limiti da conoscere
Limite: Il modello è erogato in cloud. Accesso agli strumenti e risultato sul proprio account vanno verificati; nessuna sessione end-to-end o misura di affidabilità è stata eseguita in questo ciclo.
Carbon differisce da Terra per il vincolo d’accesso: il primo lavoro è preparare la valutazione e verificare l’abilitazione, non confrontare subito tempi di esecuzione su un’API pubblica.
Limiti da conoscere
Limite: I risultati riportati sono dichiarazioni del fornitore, non test indipendenti di Radar. La pagina non dà una data certa per l’apertura generale.
Ollama affronta un problema diverso dai modelli frontier: estende una pipeline audio a nuovi sistemi operativi. La prova utile è sul proprio dispositivo, non una classifica astratta tra modelli.
Limiti da conoscere
Limite: Il changelog non dimostra prestazioni o compatibilità su ogni GPU e driver. Questo ciclo non ha eseguito inferenza né una prova audio sulle due piattaforme.
L’incidente Cursor è la priorità di sicurezza del recupero: diversamente da un normale aggiornamento di modello, richiede verificare distribuzione e stato della postazione, non soltanto cambiare una dipendenza.
Limiti da conoscere
Limite: L’avviso riguarda quel pacchetto e quella finestra di distribuzione, non tutte le installazioni di Claude Code. Cursor non riporta prove di altre versioni coinvolte; errori nel malware limitano l’attivazione SSH su molti host, ma non eliminano la necessità di verificare chiavi e persistenza.
Granite mostra un tipo di aggiornamento diverso dai nuovi pesi Mistral: il punto è cambiare componenti specializzati e misurare regressioni, non migrare necessariamente l’intero modello.
Limiti da conoscere
Limite: La retrocompatibilità e i miglioramenti sono dichiarazioni del progetto, non regressioni misurate da Radar. L’Adapter SDK e i tutorial per creare adapter terzi sono annunciati come lavoro in corso, non disponibili per il solo fatto che esiste questa patch.
Nemotron riguarda la comprensione di registrazioni e la preparazione dei dati; Ollama/LFM3 riguarda anche la produzione di audio sul dispositivo. Sono pipeline diverse, da confrontare su un compito e non su una singola classifica.
Limiti da conoscere
Limite: Lingue e capacità dipendono dal compito: la copertura ASR non coincide con quella di traduzione o speaker attribution. I confronti del fornitore non sono test Radar; la versione NVFP4 usata in una prova di throughput è indicata come futura, non come checkpoint già scaricabile.
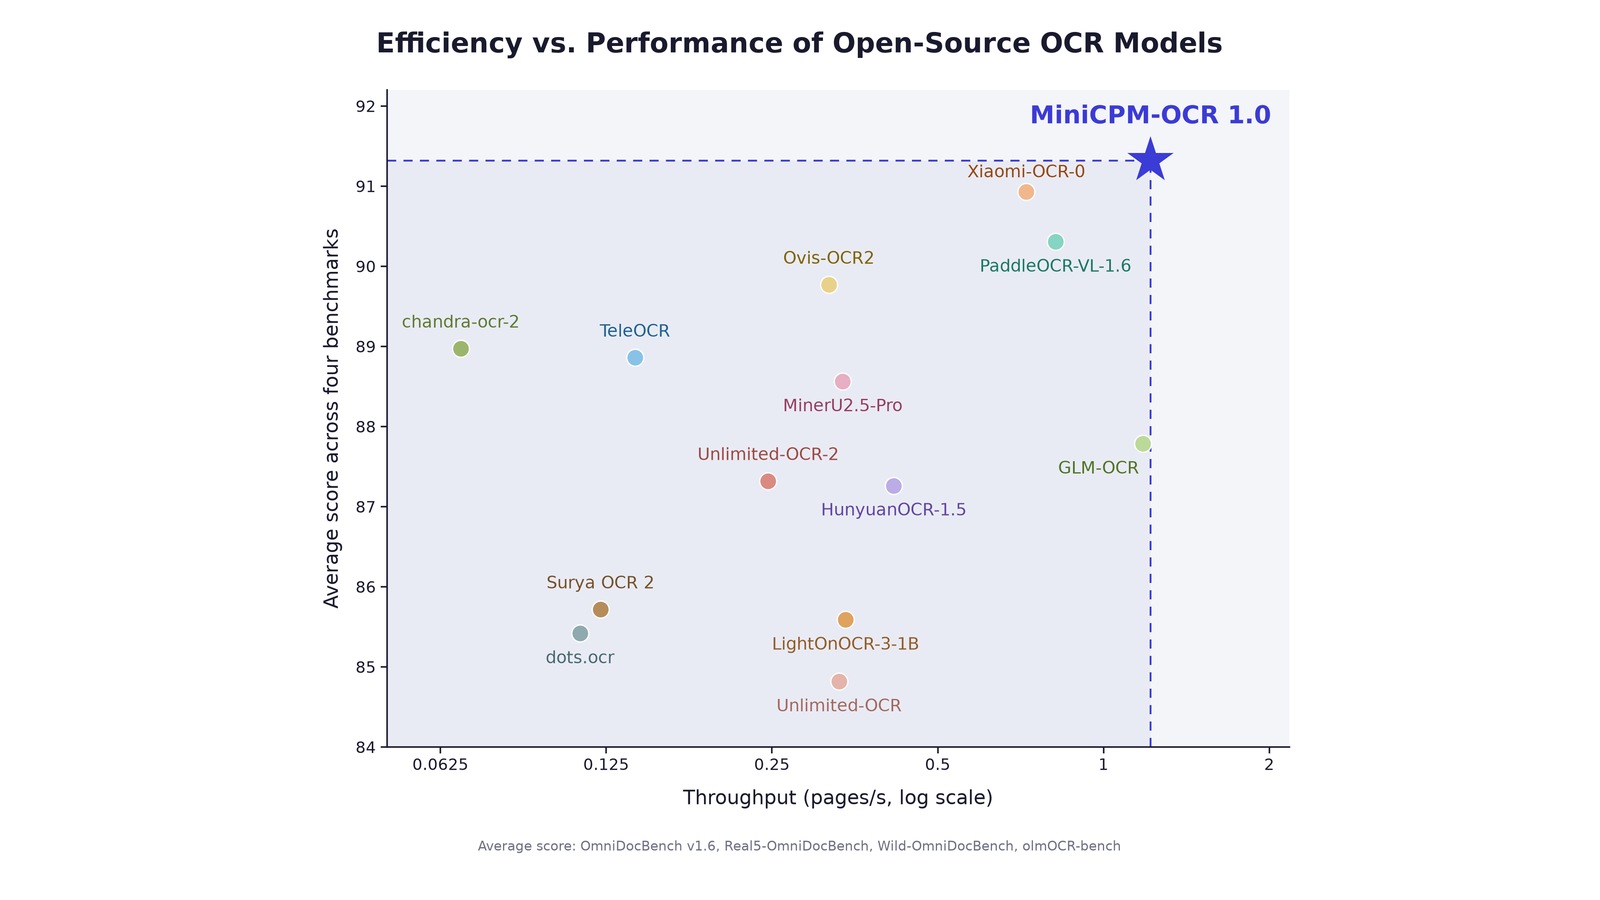
MiniCPM-OCR rende concreto il tema dei modelli locali sui documenti: la decisione riguarda una pipeline con layout e verifica, non soltanto il download dei pesi o il numero di parametri.
Limiti da conoscere
Limite: MiniCPM-OCR-Jev valuta il testo rispetto all’immagine, non genera la trascrizione. Il tag b11928 è marcato prerelease. Le lingue principali documentate per OCR 1.0 sono cinese e inglese: non è stata verificata la qualità su documenti italiani né eseguito il deployment. (fonte ufficiale)
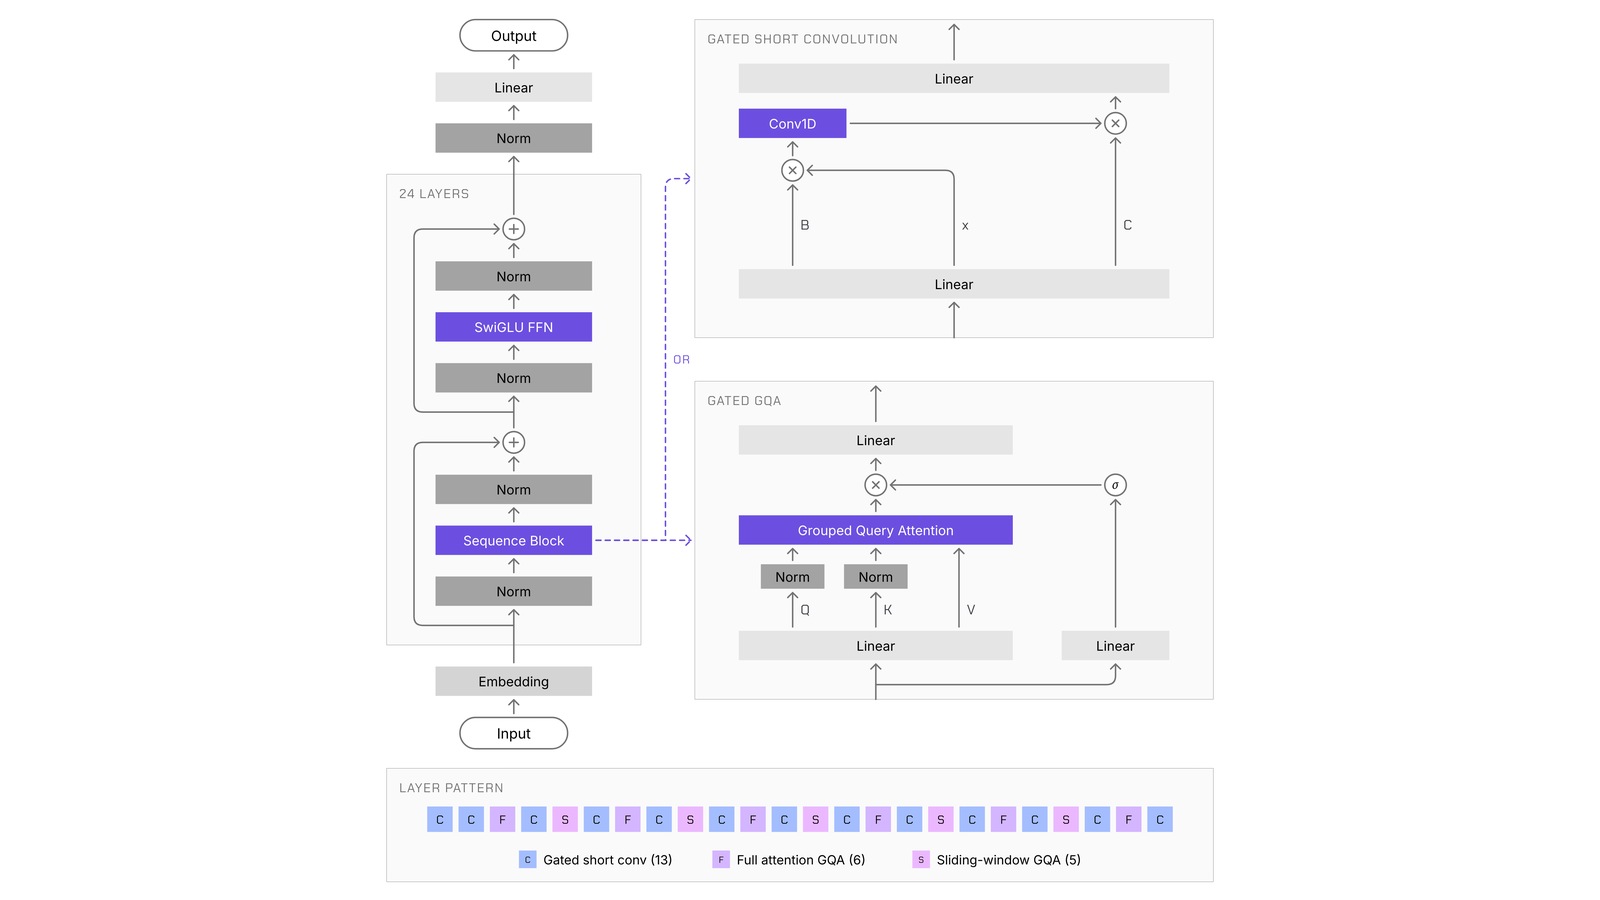
LFM3 aggiunge una scelta di checkpoint compatti; Ollama aggiunge supporto a piattaforme. La prima decisione è quale modello serve, la seconda se il runtime scelto lo esegue correttamente sul dispositivo.
Limiti da conoscere
Limite: Le capacità non sono intercambiabili tra i sei checkpoint. Alcuni esempi richiedono trust_remote_code: codice, dipendenze e condizioni del modello scelto vanno verificati prima dell’esecuzione. Nessun test di inferenza o fine-tuning LFM3 è stato eseguito da Radar.
Genie 4 e Carbon hanno in comune il vincolo d’accesso iniziale, ma non lo stesso uso: simulazione e audio nel primo caso, software e difesa cyber nel secondo. La roadmap deve partire dall’abilitazione effettiva.
Limiti da conoscere
Limite: Le scene pubblicate sono dimostrazioni selezionate da Google, non test indipendenti né validazione di un simulatore fisico. L’accesso consumer e developer è descritto come successivo; questo ciclo non ha utilizzato il modello.
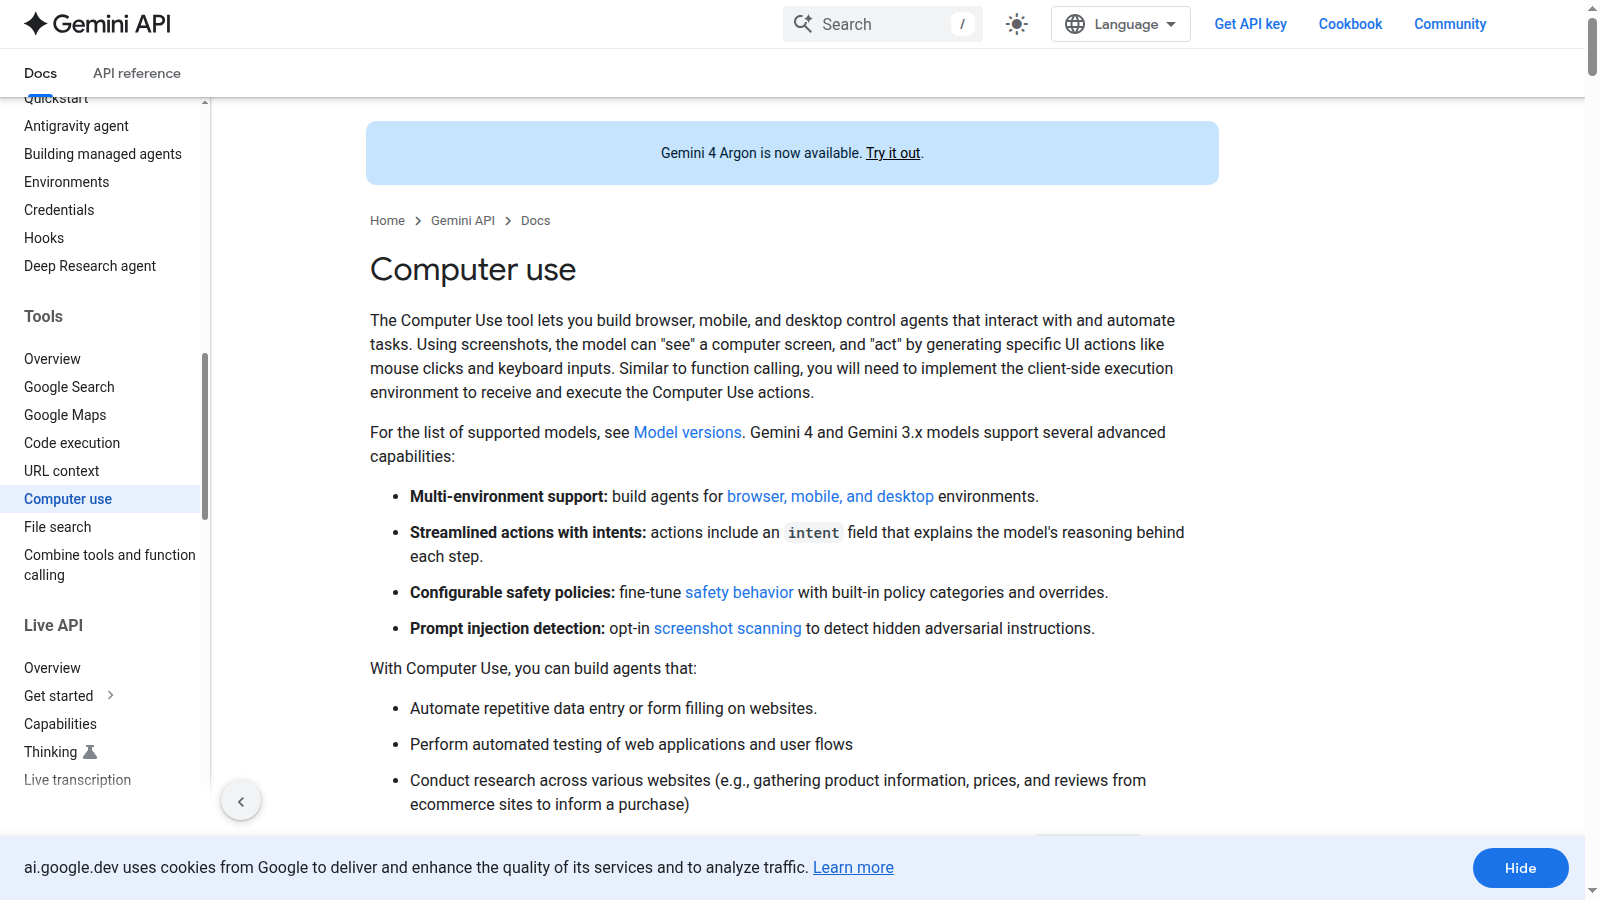
La GA di Computer Use estende le opzioni API, ma non trasferisce a Google la gestione dell’esecutore: rispetto ai nuovi modelli conta chi autorizza le azioni e ne verifica l’esito. Il primo confronto utile è fra lavoro risparmiato e supervisione richiesta.
Limiti da conoscere
Limite: GA non significa flusso infallibile. Questa scheda non include prove operative, confronti indipendenti o misurazioni delle prestazioni.
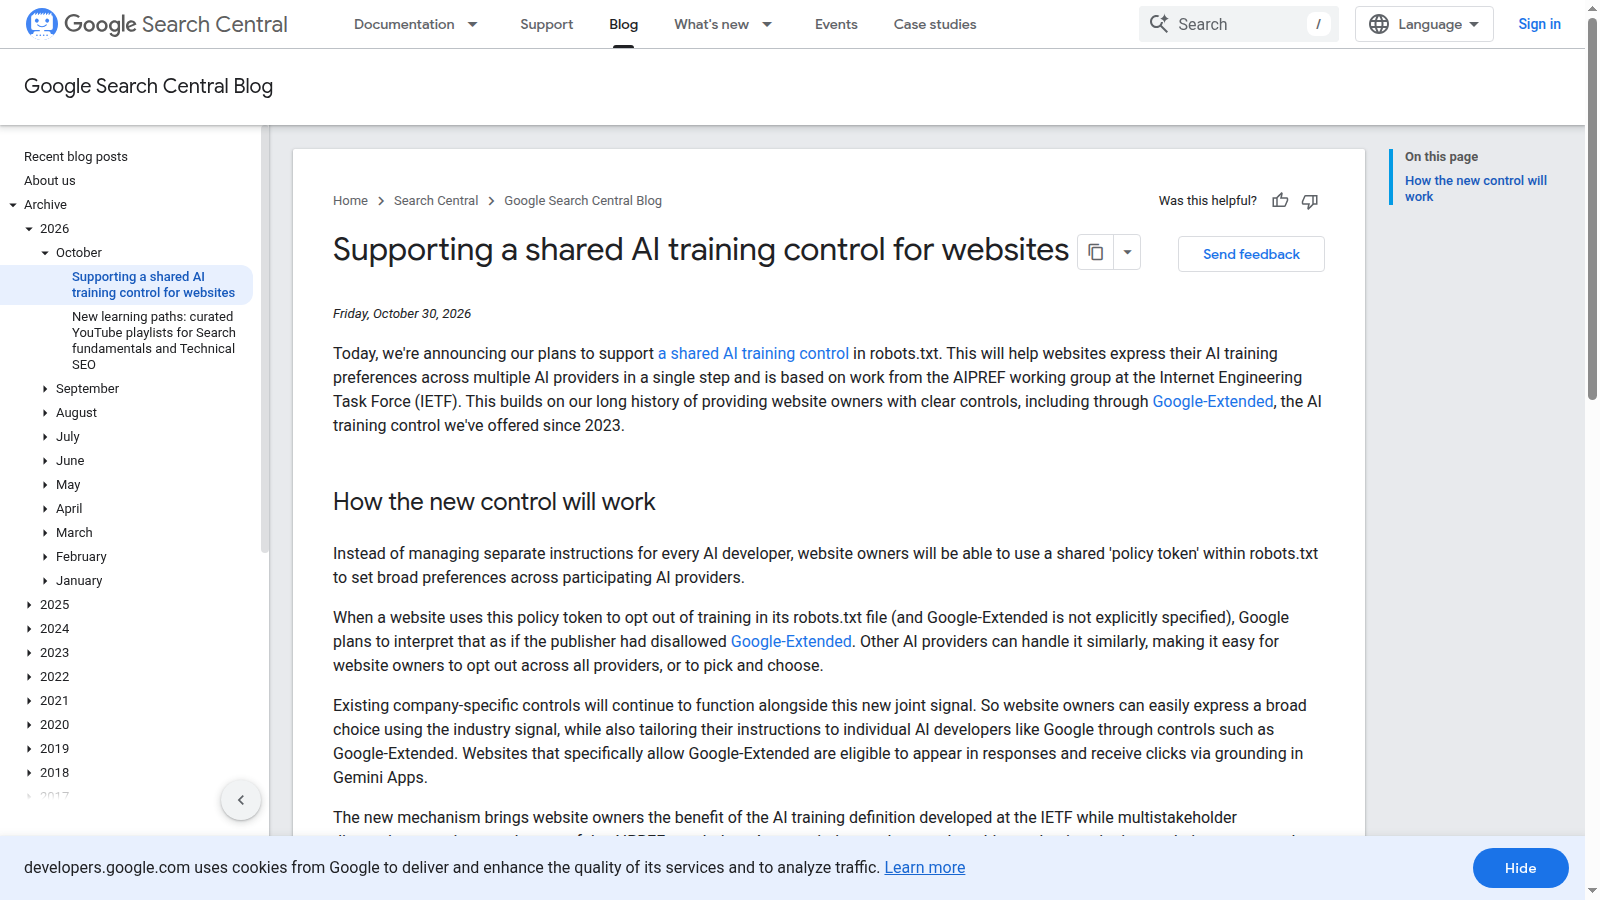
Accanto ai permessi degli agenti emerge un diverso confine: l’uso consentito dei contenuti. Le preferenze annunciate da Google e Microsoft hanno calendari futuri e non sono regole di accesso dei crawler; la scelta di training va tenuta distinta dal grounding.
Limiti da conoscere
Limite: Non è un blocco dei crawler né un parere legale. Applicazione, transizione e adozione richiedono verifiche specifiche per fornitore.
Alle correzioni dei client e ai permessi di delega si aggiunge un riscontro sul campo: GTIG e Mandiant descrivono agenti offensivi durante intrusioni reali. Le raffiche rapide non misurano l’intera compromissione; il confronto utile riguarda privilegi effettivi e tempi di contenimento, non una gara fra modelli.
Limiti da conoscere
Limite: Analisi del rapporto ufficiale, non riproduzione degli incidenti o test dei controlli. Mancano log grezzi e un denominatore per stimare la frequenza del fenomeno. L’autonomia completa resta distinta dalle attività osservate. Data editoriale della fonte: 30 ottobre; alcuni metadati riportano il 31.
Dopo il rapporto generale GTIG sugli agenti offensivi, Chainalysis fornisce una comunicazione riferita ai propri sistemi e a categorie precise di dati. La conferma dell'incidente è distinta dalla spiegazione tecnica dell'attacco, ancora incompleta nel documento pubblico.
Limiti da conoscere
Limite: È la ricostruzione dell'azienda al 30 ottobre, non una verifica forense indipendente. Nessuna evidenza di accesso a una categoria non significa prova definitiva di assenza; il documento non identifica il framework usato né dimostra un attacco interamente autonomo.
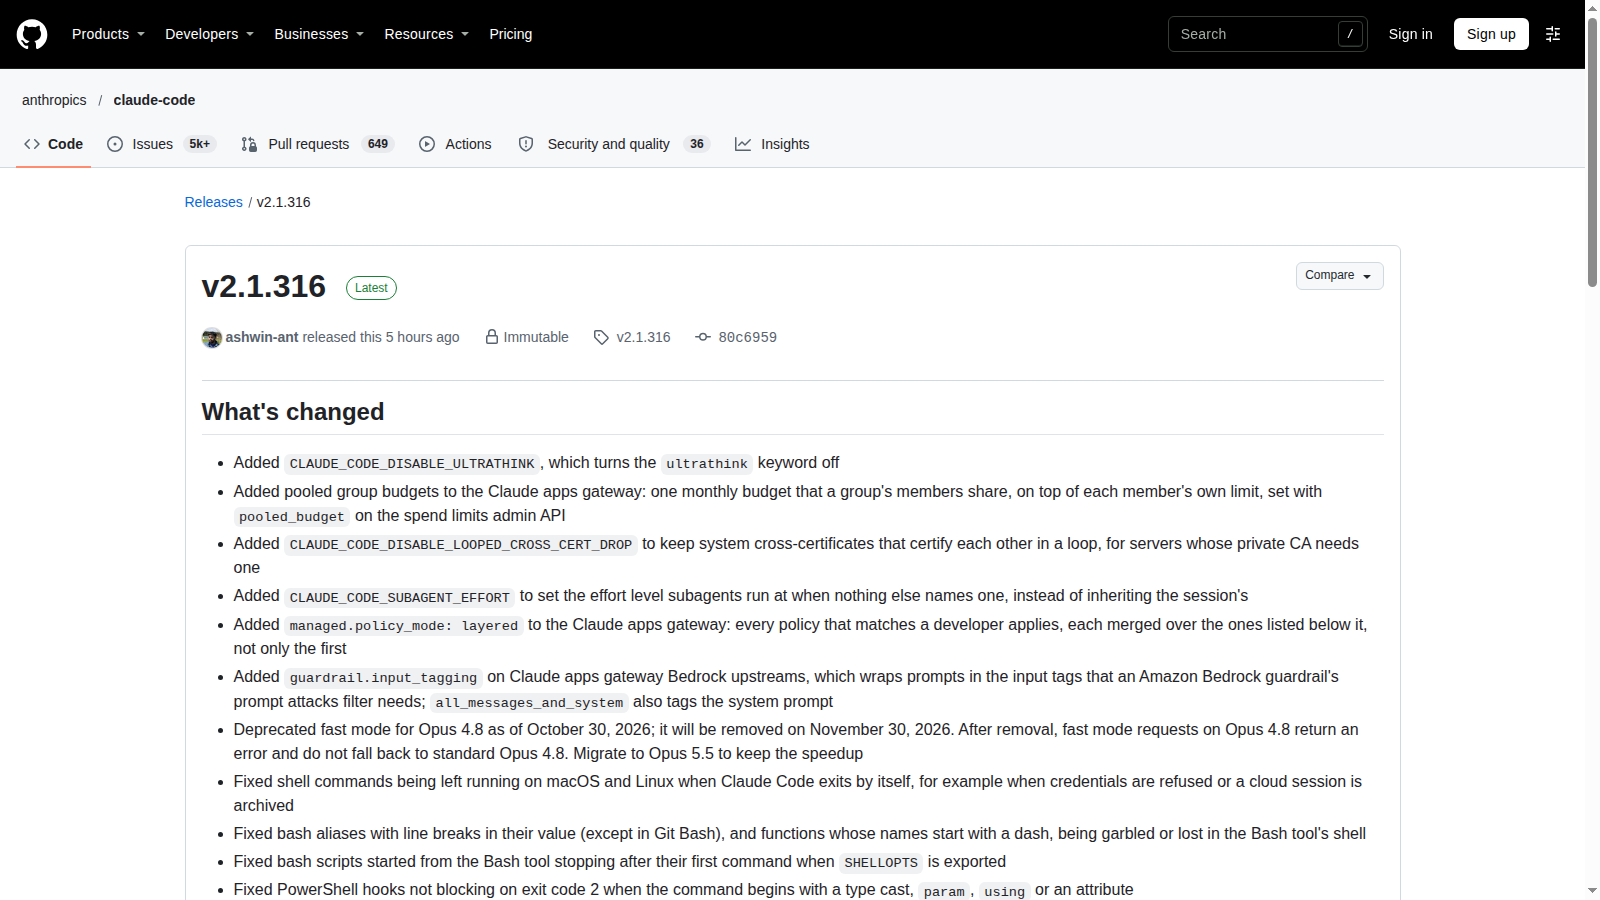
La correzione dichiarata da Anthropic in Claude Code 2.1.316 mette al centro un problema operativo degli agenti: una regola di lettura permissiva non dovrebbe allargare il confine di una sessione --restricted. La scelta utile è abbinare l'aggiornamento a un inventario di directory e configurazioni, senza scambiare un changelog per una prova indipendente di isolamento.
Limiti da conoscere
Limite: La fonte è il changelog del produttore, non una verifica indipendente del client. La voce non specifica tutte le versioni coinvolte, destinazione degli upload o abusi osservati; non costituisce una disclosure CVE.
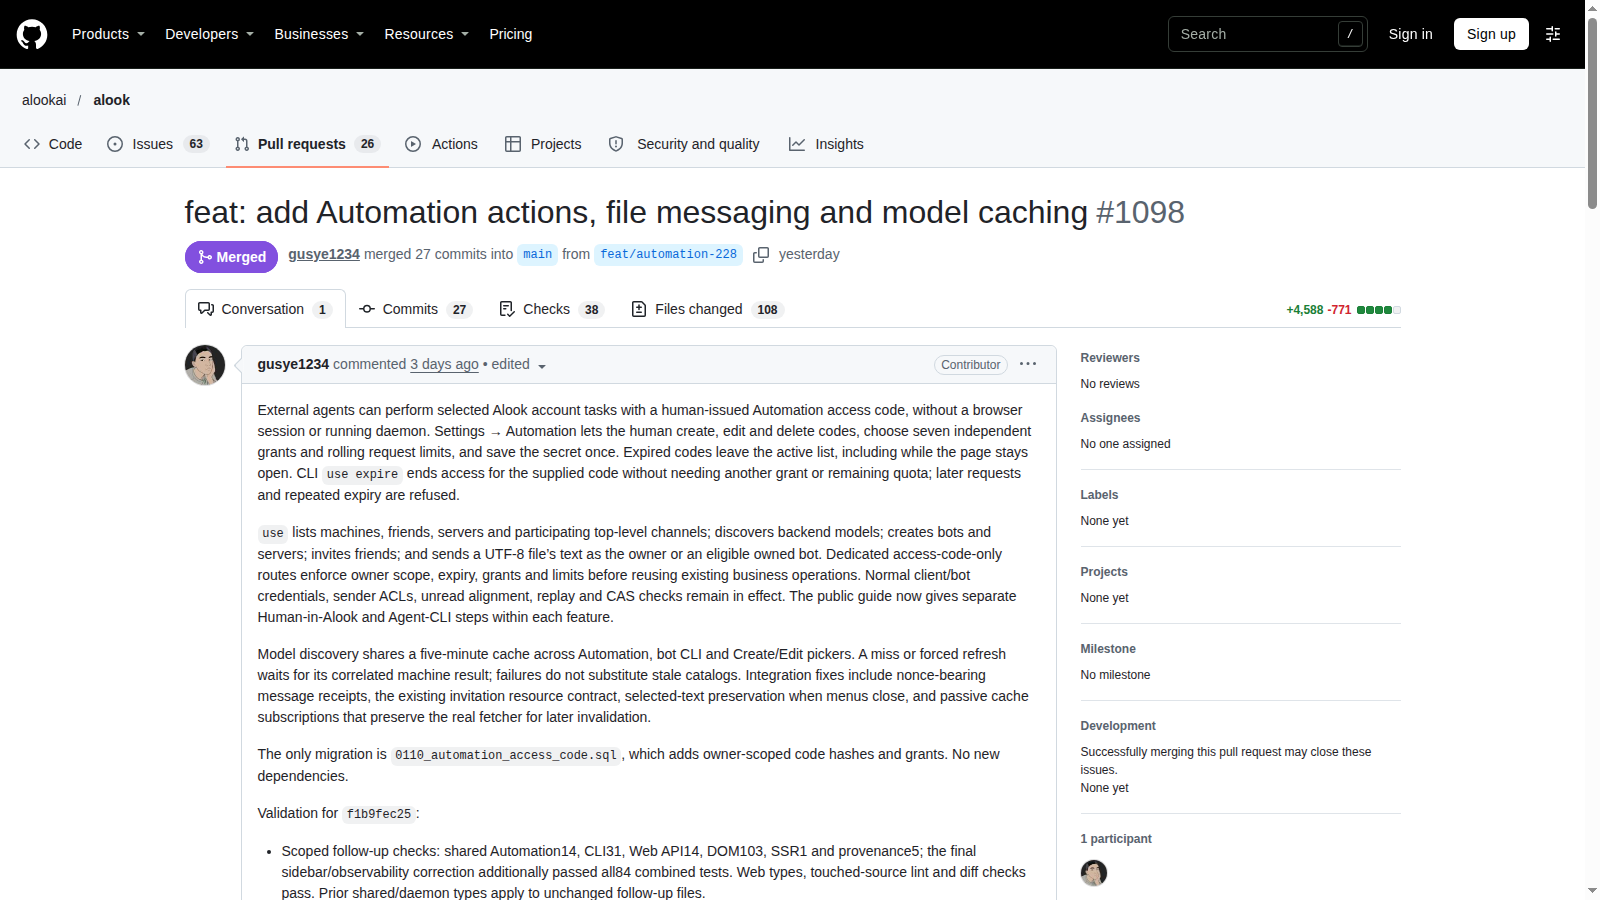
Al fix di Claude Code sul confine dei file si affianca una diversa scelta di autorizzazione: Alook aggiunge codici per azioni account selezionate. I sette permessi aiutano a restringere la delega, ma non sostituiscono il controllo del testo inviato; i filtri PII locali del bot non si applicano agli invii Automation. Sono confini documentati, non test indipendenti di sicurezza.
Limiti da conoscere
Limite: Verifica della release, della guida e dello schema al commit del tag, non prova su un account. L’assenza di browser o daemon riguarda le azioni account previste; creare e far lavorare un bot richiede comunque macchina e backend pronti. Nessuna garanzia generale di isolamento.
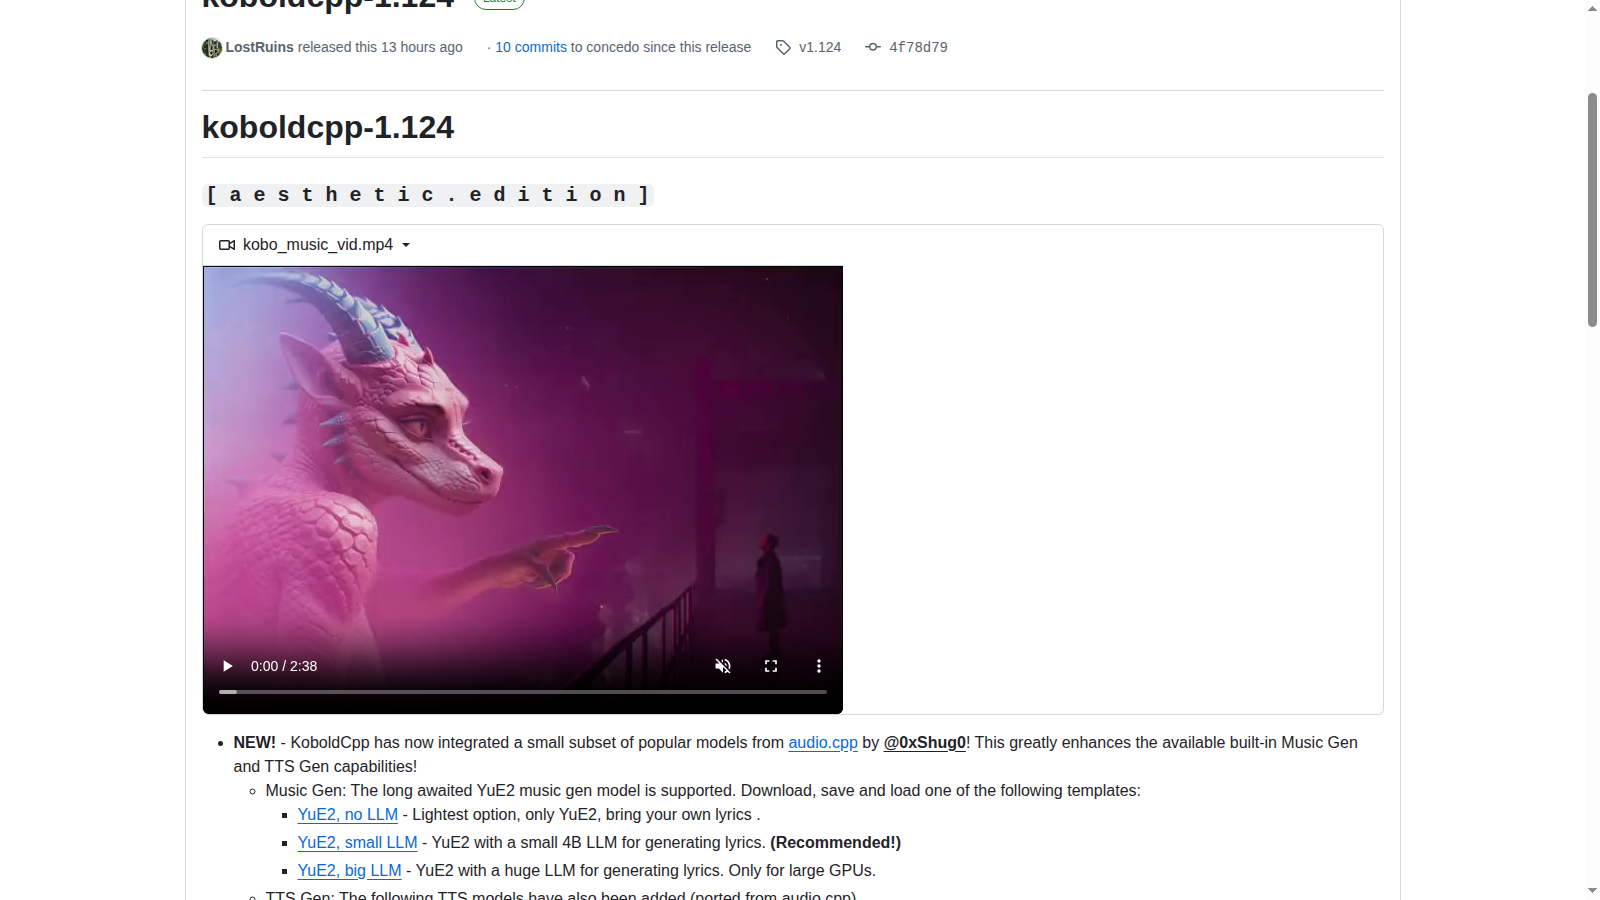
Dopo l'audio LFM3 di Ollama, KoboldCpp amplia una strada diversa: musica, TTS e trascrizione nella stessa interfaccia locale, con configurazione MCP separata. Il supporto aggiunto non stabilisce quale combinazione sia più veloce o adatta alla propria GPU.
Limiti da conoscere
Limite: Verificate le note della release e un file di configurazione ufficiale, non eseguita un'inferenza audio. Supporto software, memoria richiesta e licenza dei singoli modelli restano verifiche distinte; MCP non rende affidabile un server esterno.
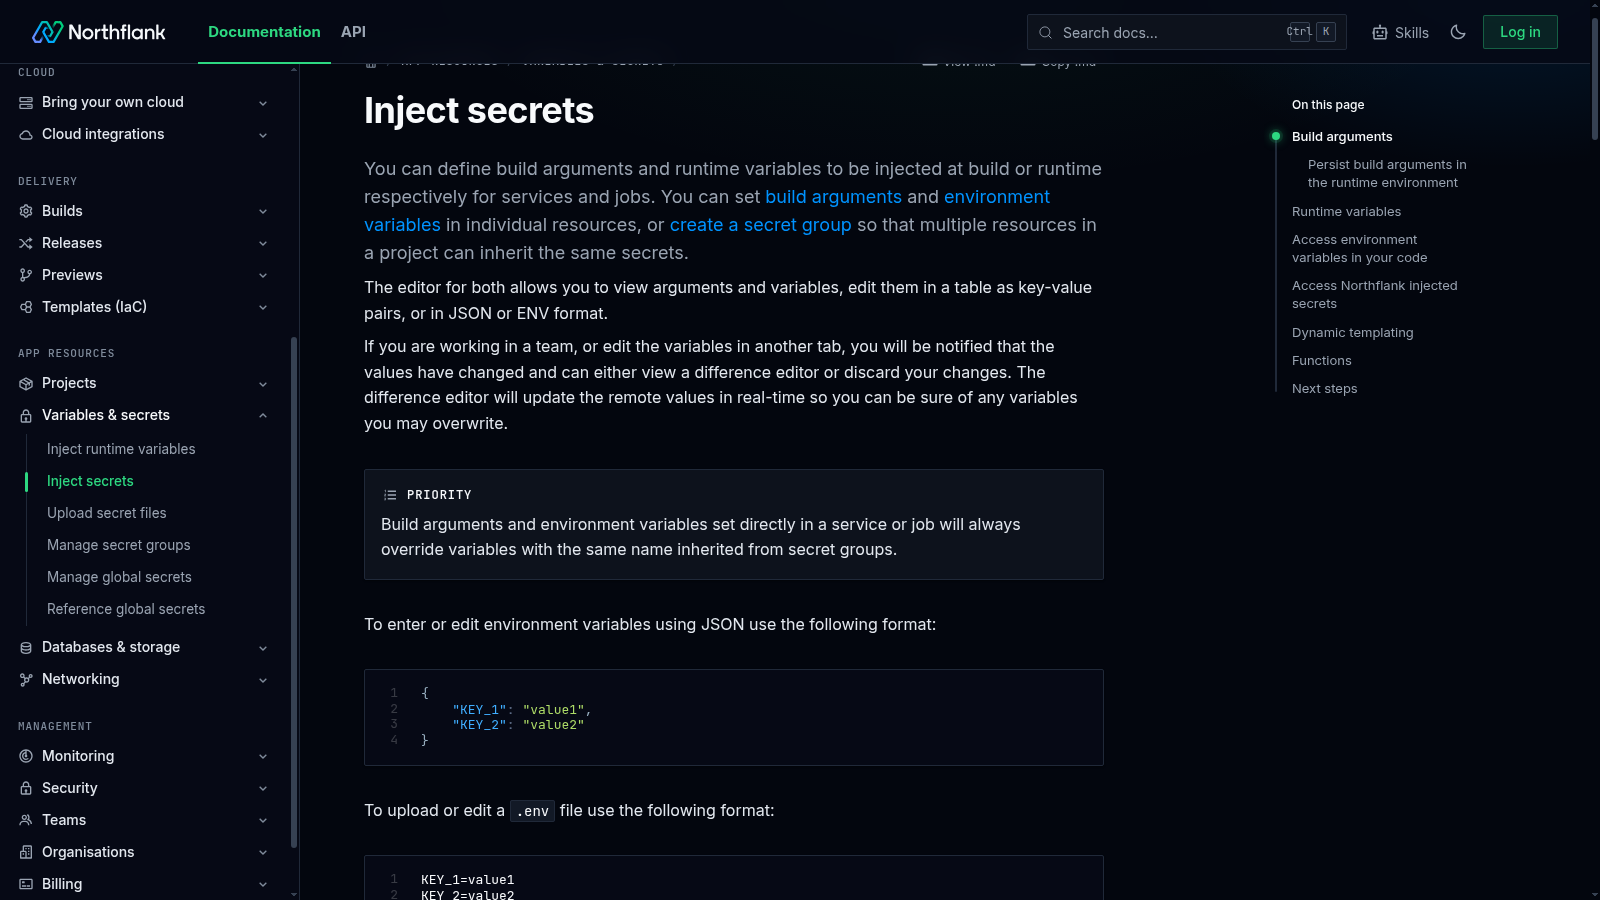
Il caso Northflank distingue il rischio concreto dalle etichette sugli attaccanti: le chiavi AI possono generare uso e costi presso un altro provider. L'aggiornamento su audit log e rotazione dei database aggiunge strumenti di risposta, non dimostra che l'incidente sia chiuso.
Limiti da conoscere
Limite: Fonte: aggiornamenti ufficiali di stato, non un rapporto forense completo. La causa definitiva, il perimetro per singolo account e l'assenza di usi ulteriori non sono dimostrati. Gli audit log appena abilitati non garantiscono da soli una cronologia retroattiva completa.
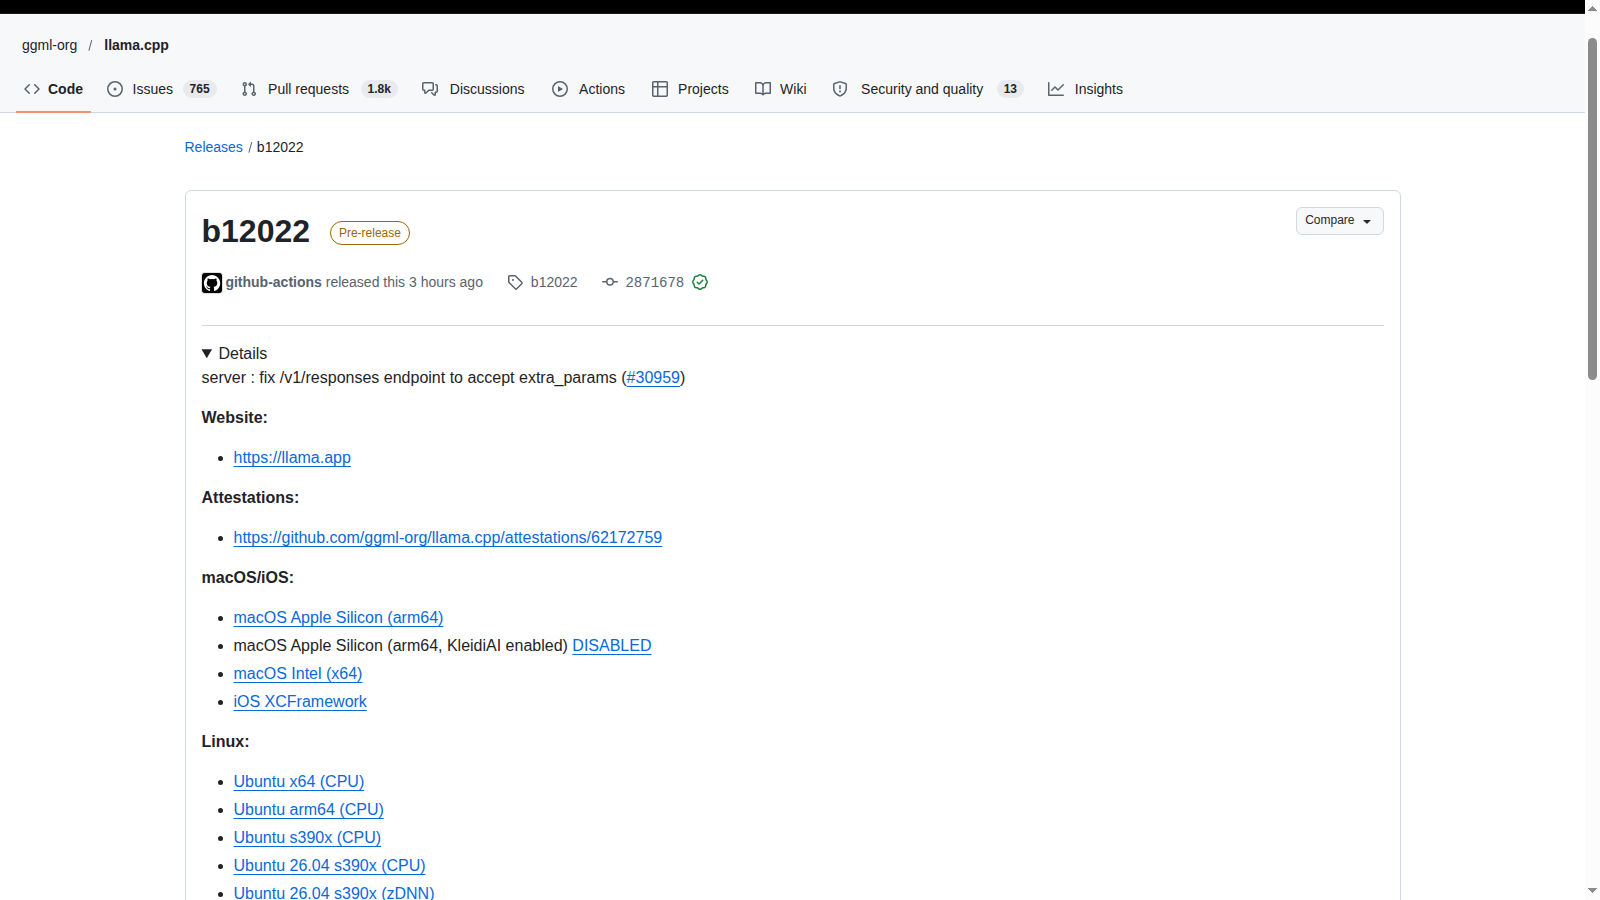
b12022 interviene sulla traduzione delle richieste Responses nei parametri del server locale. Non amplia i pesi disponibili e non dimostra un guadagno di velocità; rende esplicito dove passare seed e min_p.
Limiti da conoscere
Limite: Verificati release, documentazione fissata al tag e diff della PR, non eseguita un'inferenza end-to-end. La PR non aggiunge test automatici; il supporto ai parametri non garantisce output identici fra hardware, build o configurazioni diverse. La build è una prerelease, non una release stabile.
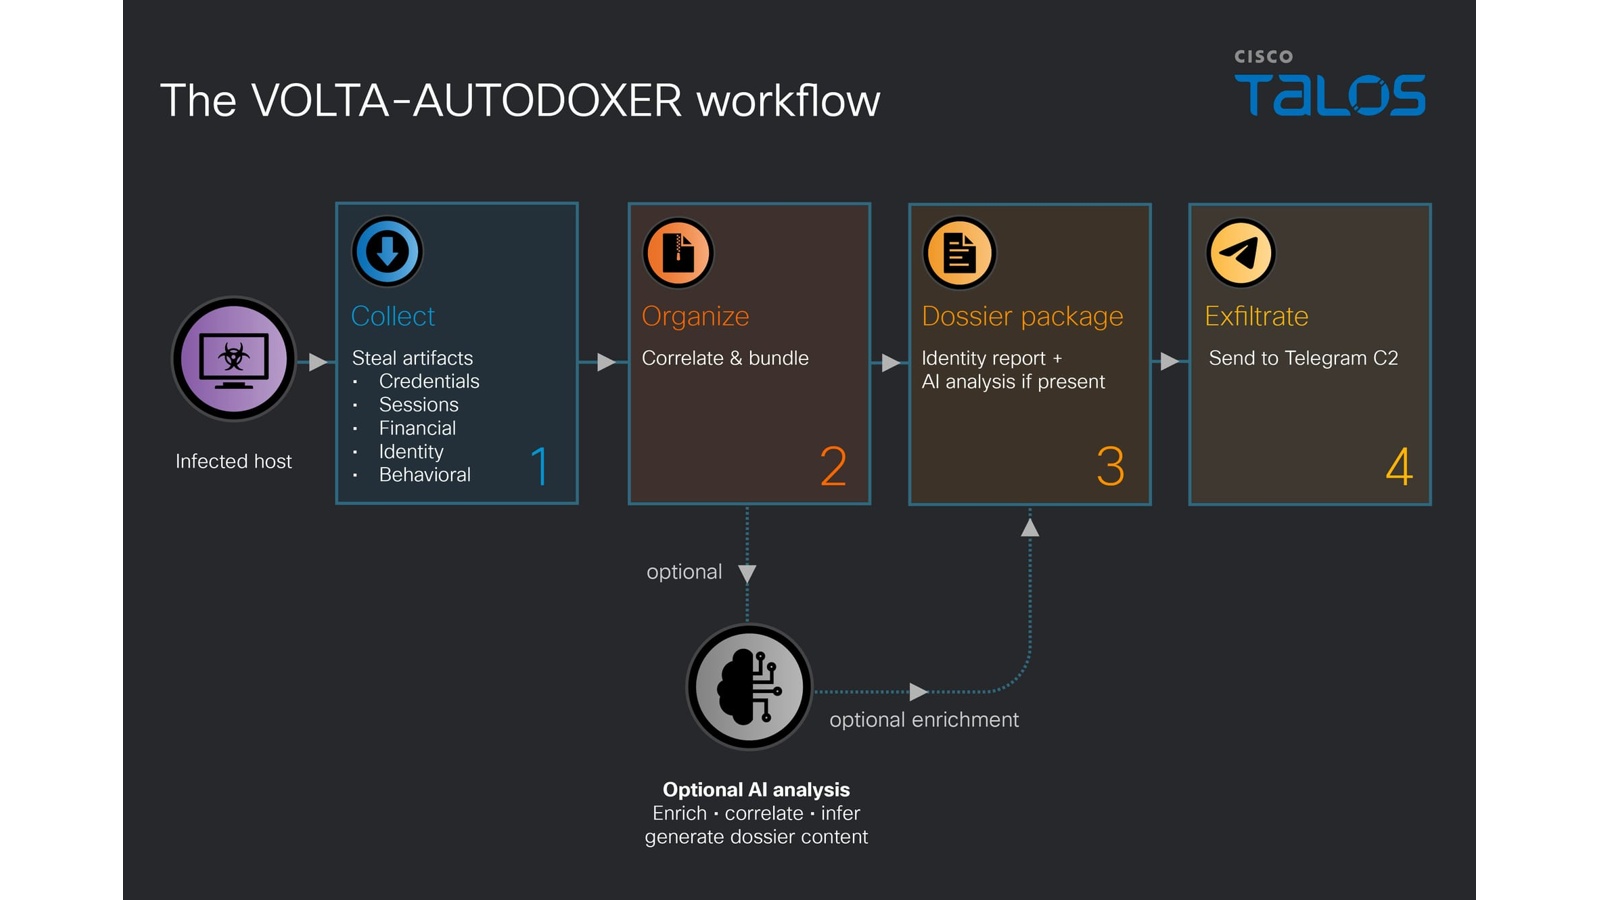
Il rapporto VOLTA aggiunge una distinzione al tema sicurezza: un LLM può ridurre il lavoro di analisi dopo il furto senza eseguire l'intrusione. Rispetto agli aggiornamenti su chiavi esposte e permessi dei tool, qui conta ricostruire quali credenziali e sessioni il dispositivo può aver perso, anche se la fase AI non riesce.
Limiti da conoscere
Limite: Analisi attribuita al campione esaminato da Cisco Talos, non una misura indipendente di diffusione o efficacia. Non sono stati scaricati né eseguiti campioni. Un rifiuto del modello non dimostra che la raccolta o l'esfiltrazione siano state fermate.
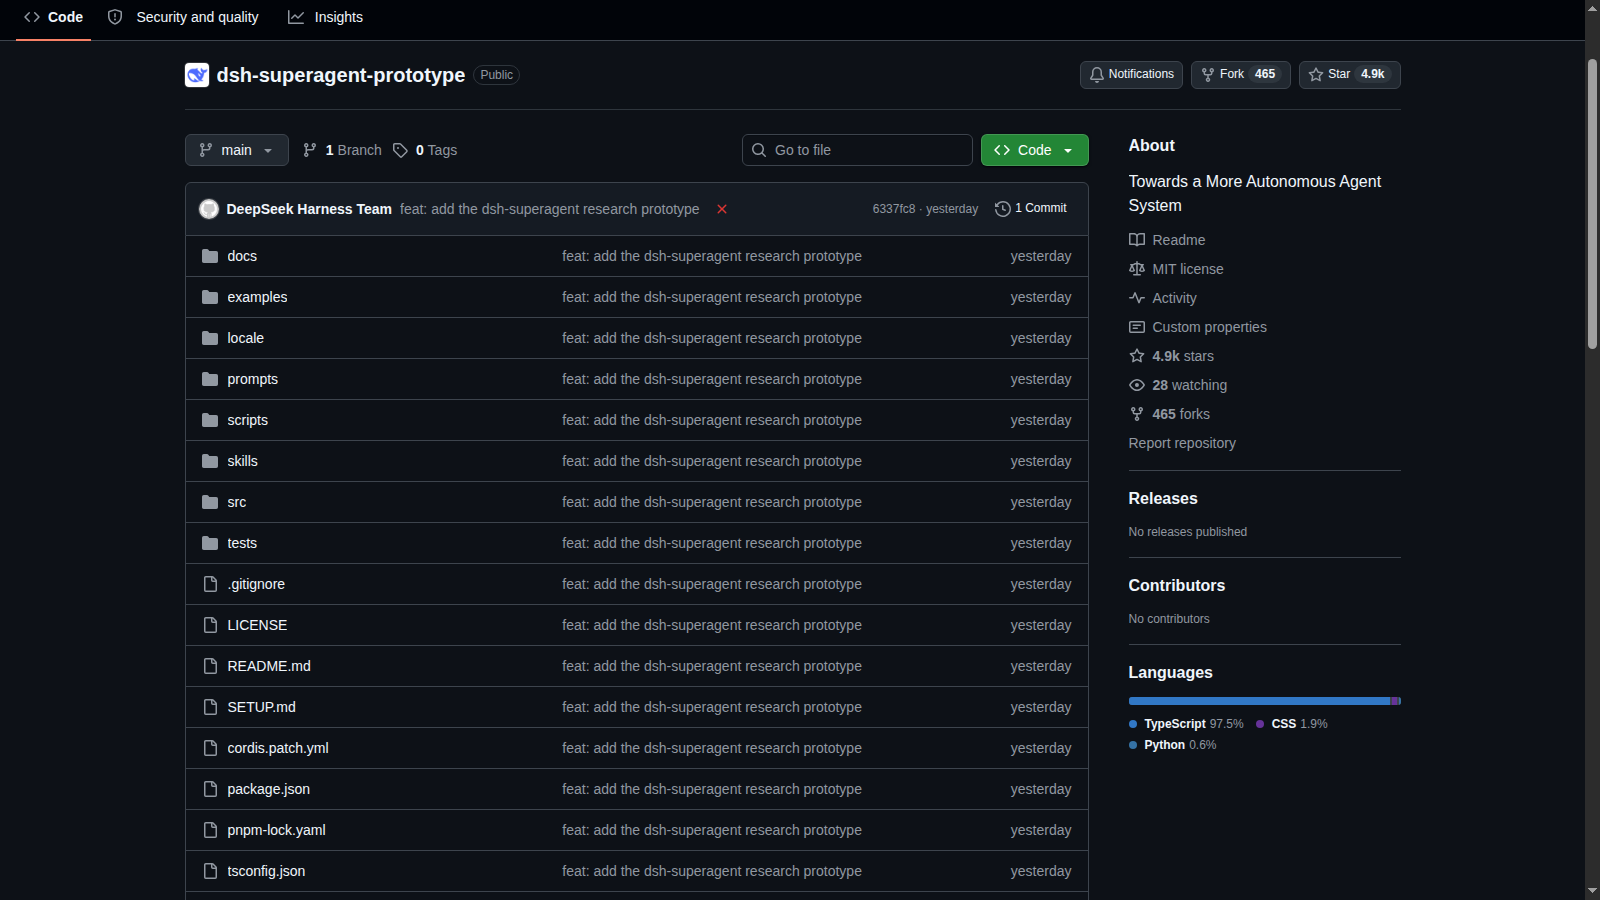
Il prototipo DeepSeek Super-Agent, pubblicato su GitHub il 31 ottobre, rende concreto un tema degli agenti proattivi: separare il permesso di iniziare un lavoro dai poteri disponibili durante l'esecuzione. Observe limita le accettazioni inferite, non le richieste esplicite ammesse; una sessione per Ticket non crea una sandbox del sistema operativo. È materiale di ricerca utile da esaminare, non un nuovo modello o una prova di autonomia affidabile. La lettura è documentale e non comprende un test E2E.
Limiti da conoscere
Limite: È codice di ricerca, non un prodotto ufficiale DeepSeek pronto per la produzione. Il README avverte che la versione pubblica differisce da quella interna e che alcune idee dell'articolo non sono implementate. Nessuna installazione, esecuzione del progetto o prova E2E è stata effettuata. Le garanzie documentate non sono state validate a runtime.
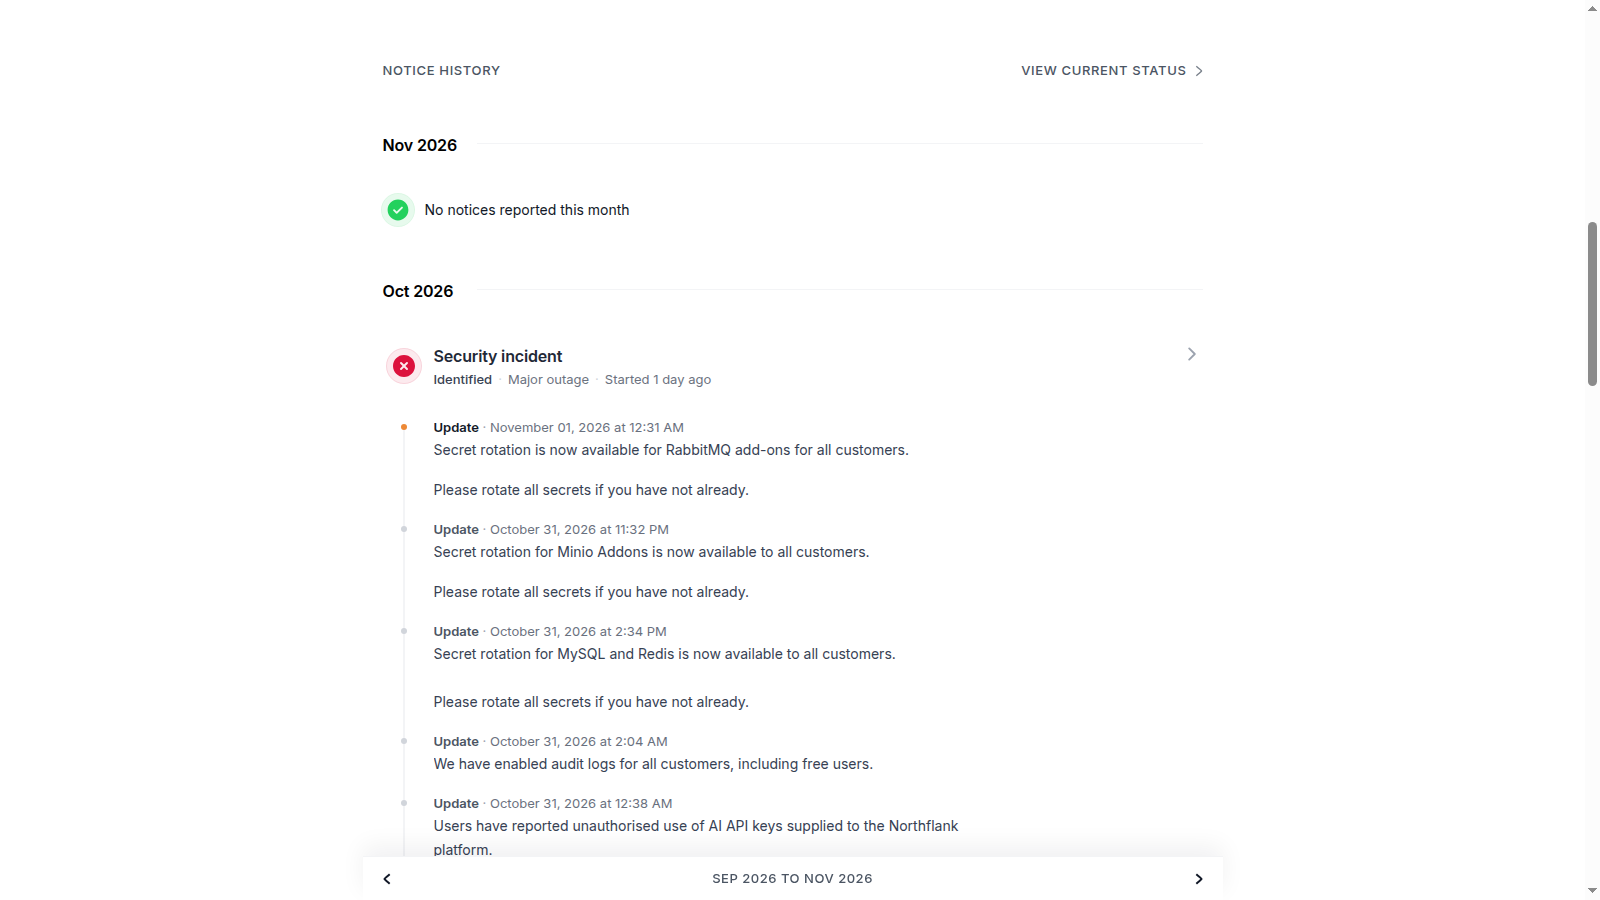
Il nuovo aggiornamento Northflank amplia a RabbitMQ gli strumenti di rotazione già estesi ad altri add-on. Rispetto alle nuove API e ai runtime locali della settimana, qui la decisione viene prima del modello: revocare le credenziali coinvolte e ricostruire gli accessi, non limitarsi a cambiare una variabile.
Limiti da conoscere
Limite: La comunicazione del fornitore non dichiara risolto l'incidente. Causa finale, perimetro completo e impatto su ciascun cliente restano da accertare. Non sono stati verificati account di Francesco né eseguita una rotazione reale.
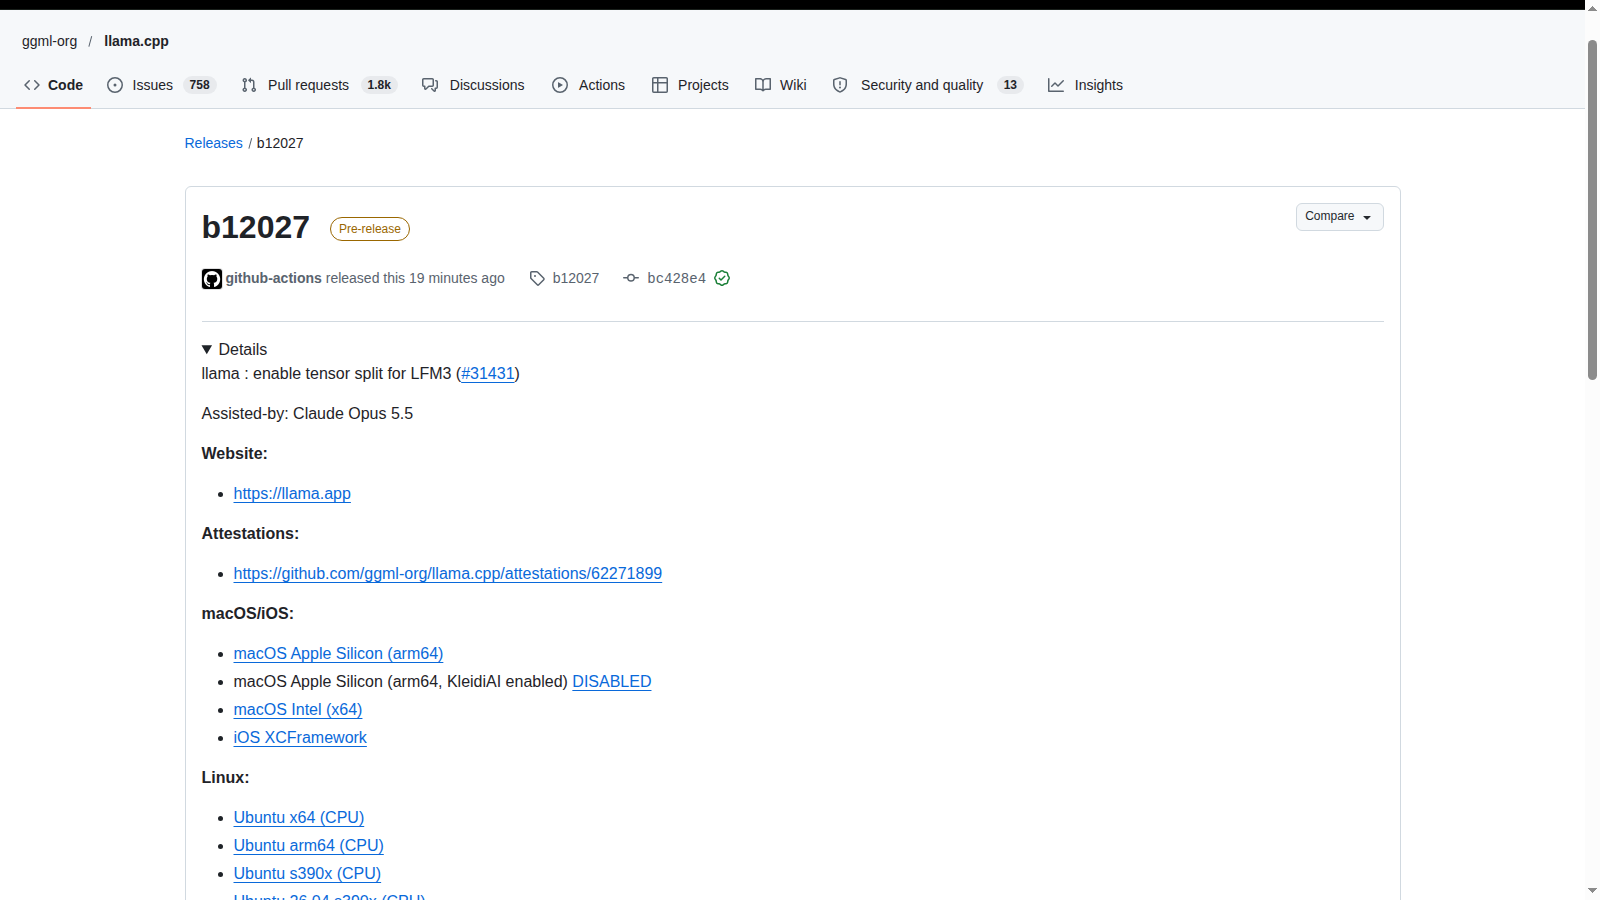
Dopo il fix ai parametri Responses, b12027 interviene su un altro livello di llama.cpp: distribuire LFM3 tra dispositivi. I dati della PR mostrano perché supporto multi-dispositivo e miglioramento uniforme delle prestazioni non sono sinonimi. La scelta richiede una misura sul proprio carico.
Limiti da conoscere
Limite: GitHub classifica b12027 come prerelease. I dati sono quelli dell'autore della PR su Qualcomm SA8797P con LFM3-1.7B Q4_0; non dimostrano lo stesso risultato su altre NPU, GPU, quantizzazioni o modelli. Nessuna inferenza o benchmark è stato eseguito in questo ciclo.
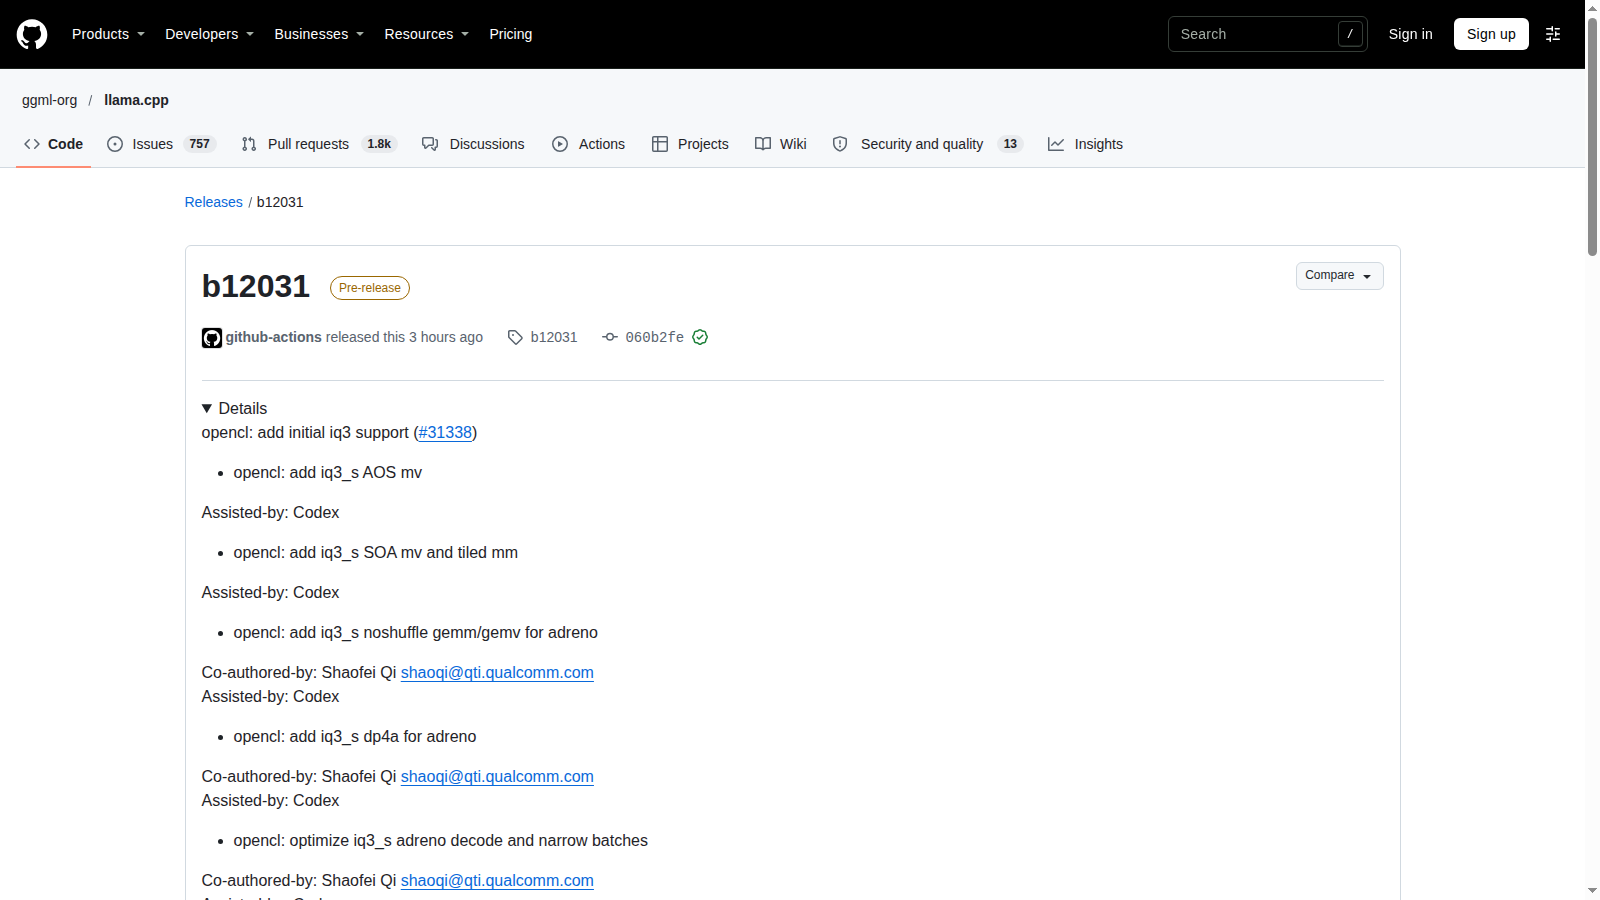
Dopo il tensor split LFM3, llama.cpp amplia un altro percorso del deployment locale: IQ3 arriva inizialmente in OpenCL e Hexagon corregge l'indirizzamento DMA per stride molto grandi. I due delta riguardano compatibilità e correttezza di backend specifici, non una corsa al numero di versione. Per scegliere un aggiornamento servono GGUF, driver e prove identiche; le due pubblicazioni del 1 novembre restano prerelease.
Limiti da conoscere
Limite: Entrambe sono marcate prerelease nell'API GitHub. Compatibilità, correttezza e prestazioni dipendono da modello, formato GGUF, backend, driver e dispositivo. Nessuna build o prova su hardware locale è stata eseguita: i test citati sono quelli dichiarati dal progetto, non una nostra validazione.
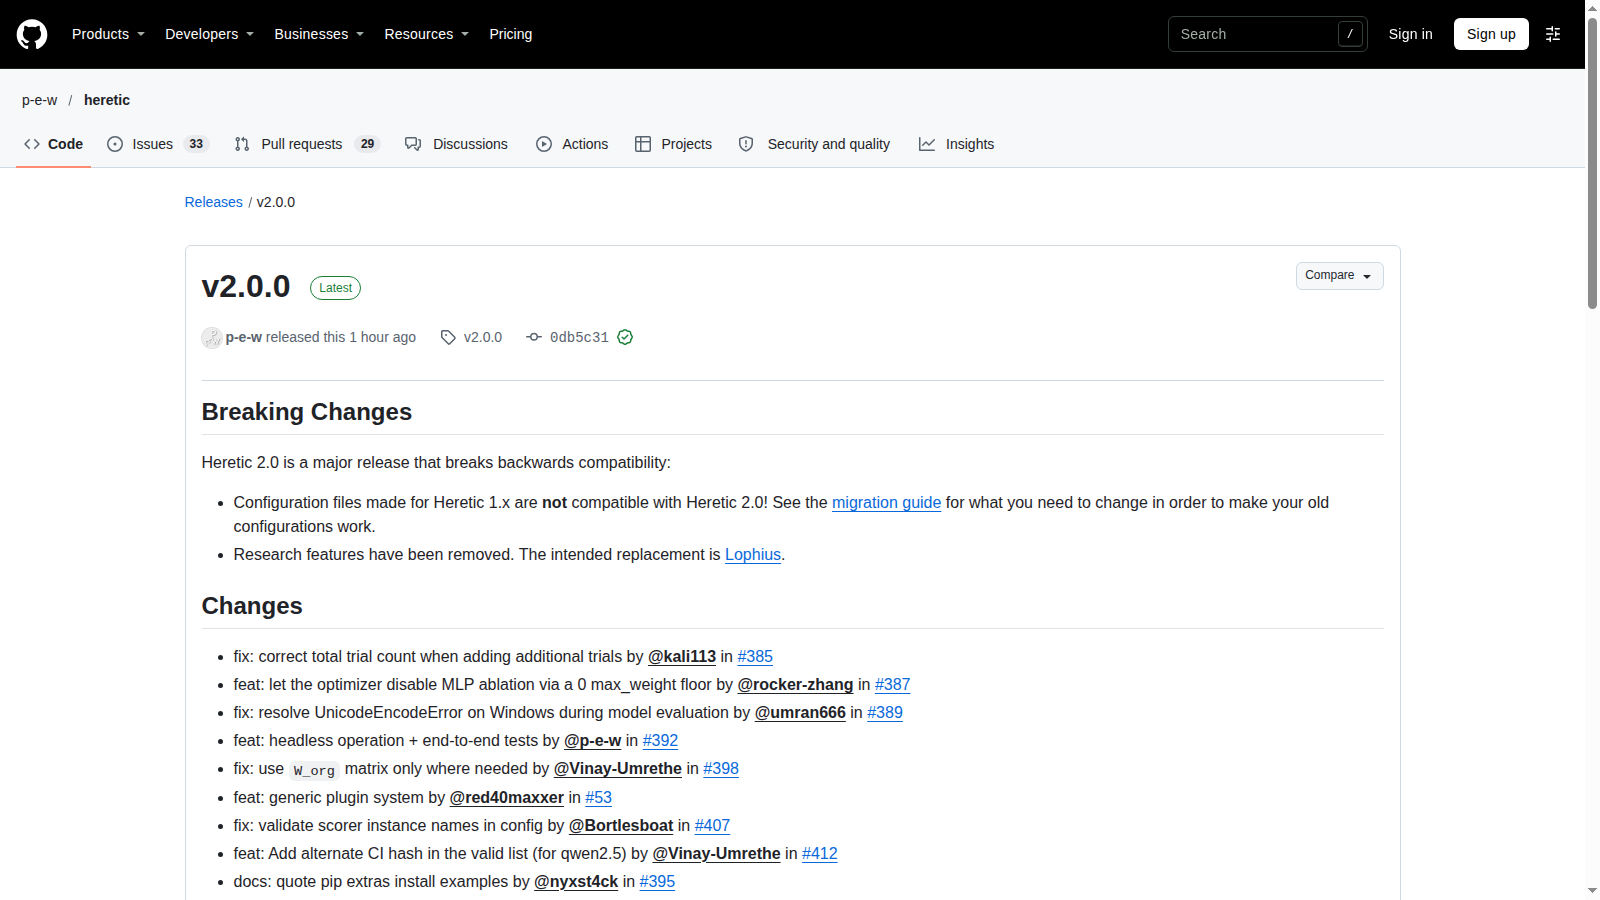
Heretic 2.0 amplia il software con plugin e modalità headless, ma richiede di migrare le configurazioni 1.x. A differenza degli aggiornamenti di inferenza, cambia come si modifica e si valuta un modello.
Limiti da conoscere
Limite: Analisi della release e dei documenti della versione 2.0.0, non prova eseguita. Plugin, test upstream e minori rifiuti non dimostrano qualità, sicurezza o compatibilità sul proprio hardware.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.