
L’ANALISI
DynaRev: valutare gli agenti web quando l’utente cambia obiettivo
DynaRev valuta gli agenti web con obiettivi che cambiano: 181 compiti, limiti dei giudici LLM e una prova per confrontare riscrittura e riavvio.
In breve: Per un agente che riceve correzioni, il successo del primo piano non basta. DynaRev suggerisce una prova concreta: aggiornare esplicitamente i requisiti attivi, conservare il lavoro ancora valido e controllare il risultato finale. La reazione a una correzione va misurata separatamente dal rispetto di tutte le richieste.
Tre cambiamenti diversi richiedono controlli diversi
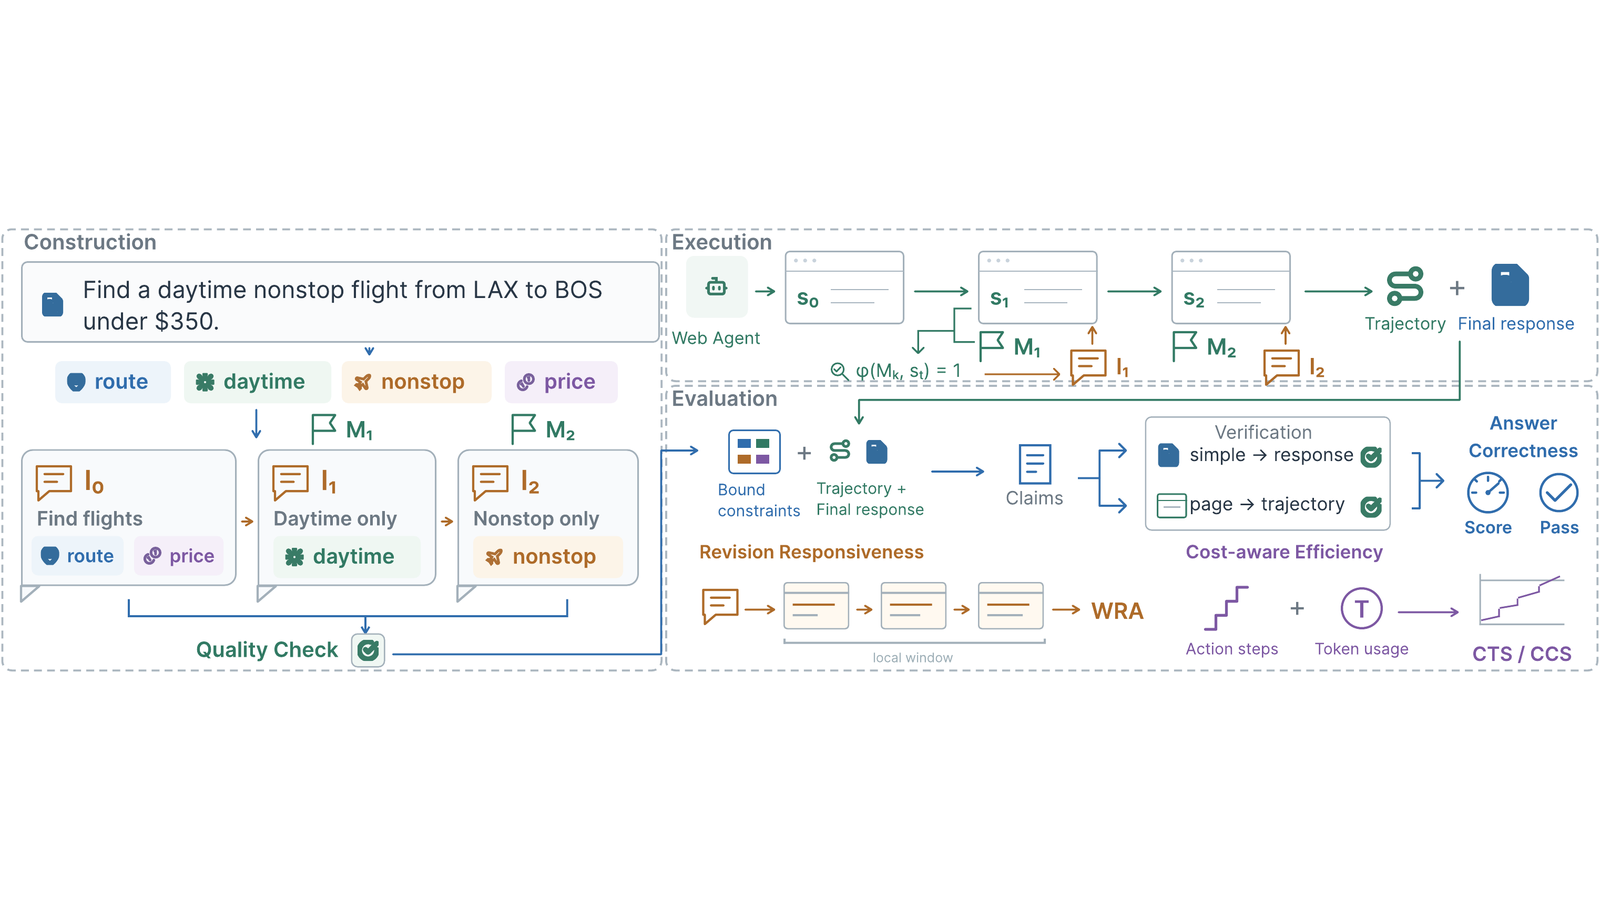
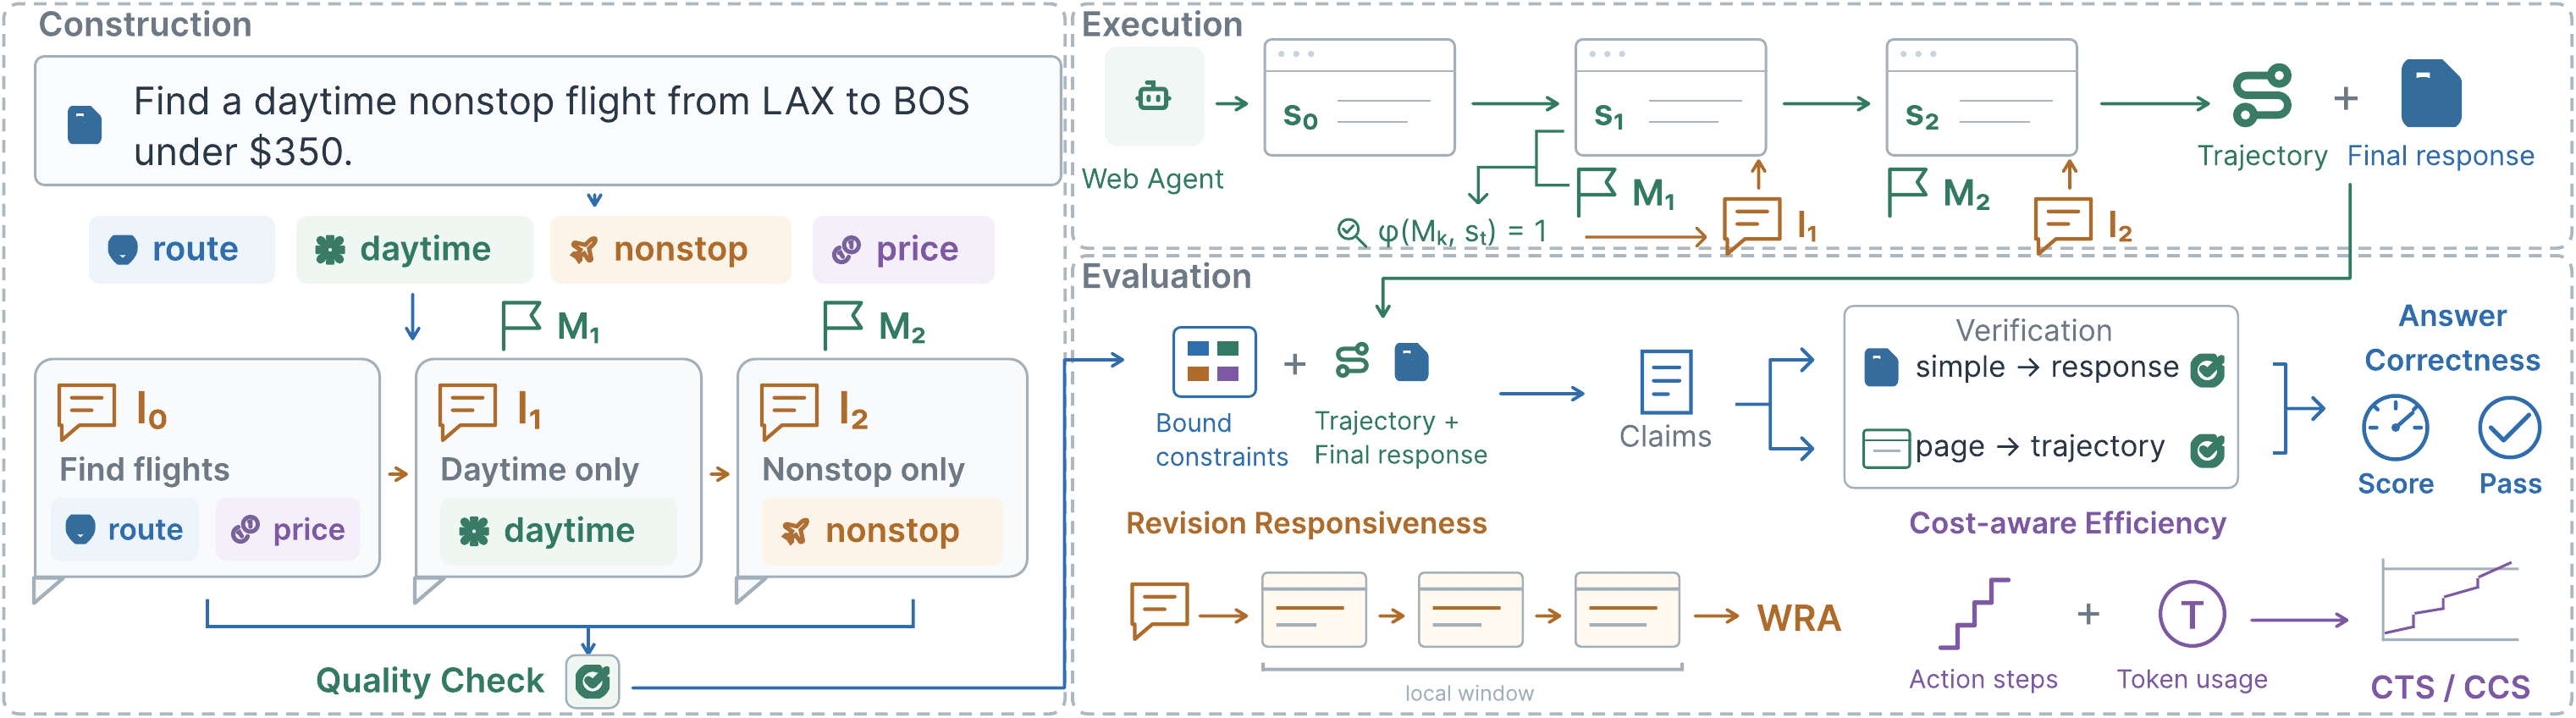
Il benchmark distingue aggiunte, sostituzioni e sostituzioni condizionali dei requisiti; le revisioni arrivano in corrispondenza di tappe semantiche del compito. Nella propria suite proposta, non chiamare tutto genericamente cambio di prompt. Per un’aggiunta controllare che i vincoli precedenti restino validi; per una sostituzione che quello superato smetta di guidare la scelta; per una condizione che sia documentata l’osservazione che attiva il ramo corretto.
Rispondere subito non significa avere concluso bene
DynaRev misura sia la soddisfazione finale dei vincoli sia la risposta comportamentale subito dopo una revisione; la seconda guarda al massimo tre azioni. Implicazione pratica proposta: mantenere due esiti nel rapporto di prova. Il primo risponde a ha recepito la correzione?, il secondo a il risultato soddisfa tutti i requisiti ancora attivi?. Una spiegazione plausibile o un clic pertinente non devono sostituire il controllo dell’output finale.
Riscrivere il compito non è azzerare il browser
Nel confronto della sezione 7.2, con DeepSeek-V4.1-Flash e un sottoinsieme comune, Rewrite porta il punteggio medio sui vincoli da 0,647 a 0,718 e i passi medi da 50,3 a 44,9. Il reset del browser peggiora il compromesso qualità-costo. Non è un incremento dimostrato per ogni modello. L’ipotesi da verificare sul proprio sistema è più precisa: ricostruire l’istruzione corrente senza buttare via selezioni, filtri e pagine ancora utili.
La riscrittura deve conservare anche le condizioni
Il compositore ufficiale chiede di preservare i requisiti attivi e di non risolvere durante la riscrittura un ramo condizionale. Controllo proposto: confrontare istruzione prima e dopo con una lista di vincoli attesi, includendo negazioni, soglie e requisiti sostituiti. Conservare nel registro sia la correzione originale sia la versione ricomposta. Se una soglia cambia significato, una frase più compatta non è una sintesi corretta del compito.
Codice presente non equivale a riproduzione completata
Nei file ufficiali sono stati contati 76 compiti additivi, 62 sostituzioni e 43 casi condizionali. Il README corrente richiede Python 3.12, browser e un endpoint compatibile con OpenAI; runner e valutazione sono passaggi distinti. I dati e il runner compaiono già nella revisione del 28 ottobre, mentre README e figura qui verificati sono fissati a una revisione del 30. Prima del riuso proposto, verificare dipendenze e condizioni di licenza: la presenza pubblica del repository non sostituisce questa verifica.
Una prova locale piccola può essere più utile di una classifica
Protocollo proposto, non eseguito da Radar: scegliere un compito autorizzato con risposta controllabile e preparare una revisione di ciascun tipo. Ripetere con identici dati e budget le varianti continuazione, riscrittura con stato conservato e riavvio. Registrare requisiti soddisfatti, azioni, consumo e motivo del fallimento. Revisionare a mano un campione dei giudizi, perché gli autori riconoscono limiti nelle valutazioni semantiche automatiche. Usare un ambiente di prova senza acquisti, invii o modifiche a dati reali.
Condizioni e limitazioni
È un preprint con valutatori LLM e compiti derivati da benchmark statici. Il confronto tra strategie usa un modello e un sottoinsieme di compiti. Il repository è stato letto, non installato o eseguito; le istruzioni correnti del 30 ottobre non sono retrodatate alla submission del 29.
Checklist pratica
- Fissare il paper 2610.40133v1 e la revisione del repository usata nella valutazione.
- Separare aggiunta, sostituzione e revisione condizionale nelle prove.
- Conservare elenco dei requisiti attivi e correzioni originali dopo ogni turno.
- Verificare che la riscrittura non elimini condizioni, negazioni o vincoli non sostituiti.
- Misurare separatamente reazione immediata, correttezza finale e consumo.
- Confrontare le strategie sullo stesso compito senza attribuire universalità al risultato di un solo modello.
- Controllare dipendenze e licenza prima del riuso; usare soltanto ambienti e dati autorizzati.