
L’ANALISI
llama.cpp b12027: tensor split per i modelli LFM3
llama.cpp b12027 abilita il tensor split per LFM3. La PR confronta 1, 2 e 4 NPU Qualcomm: più dispositivi non migliorano ogni misura.
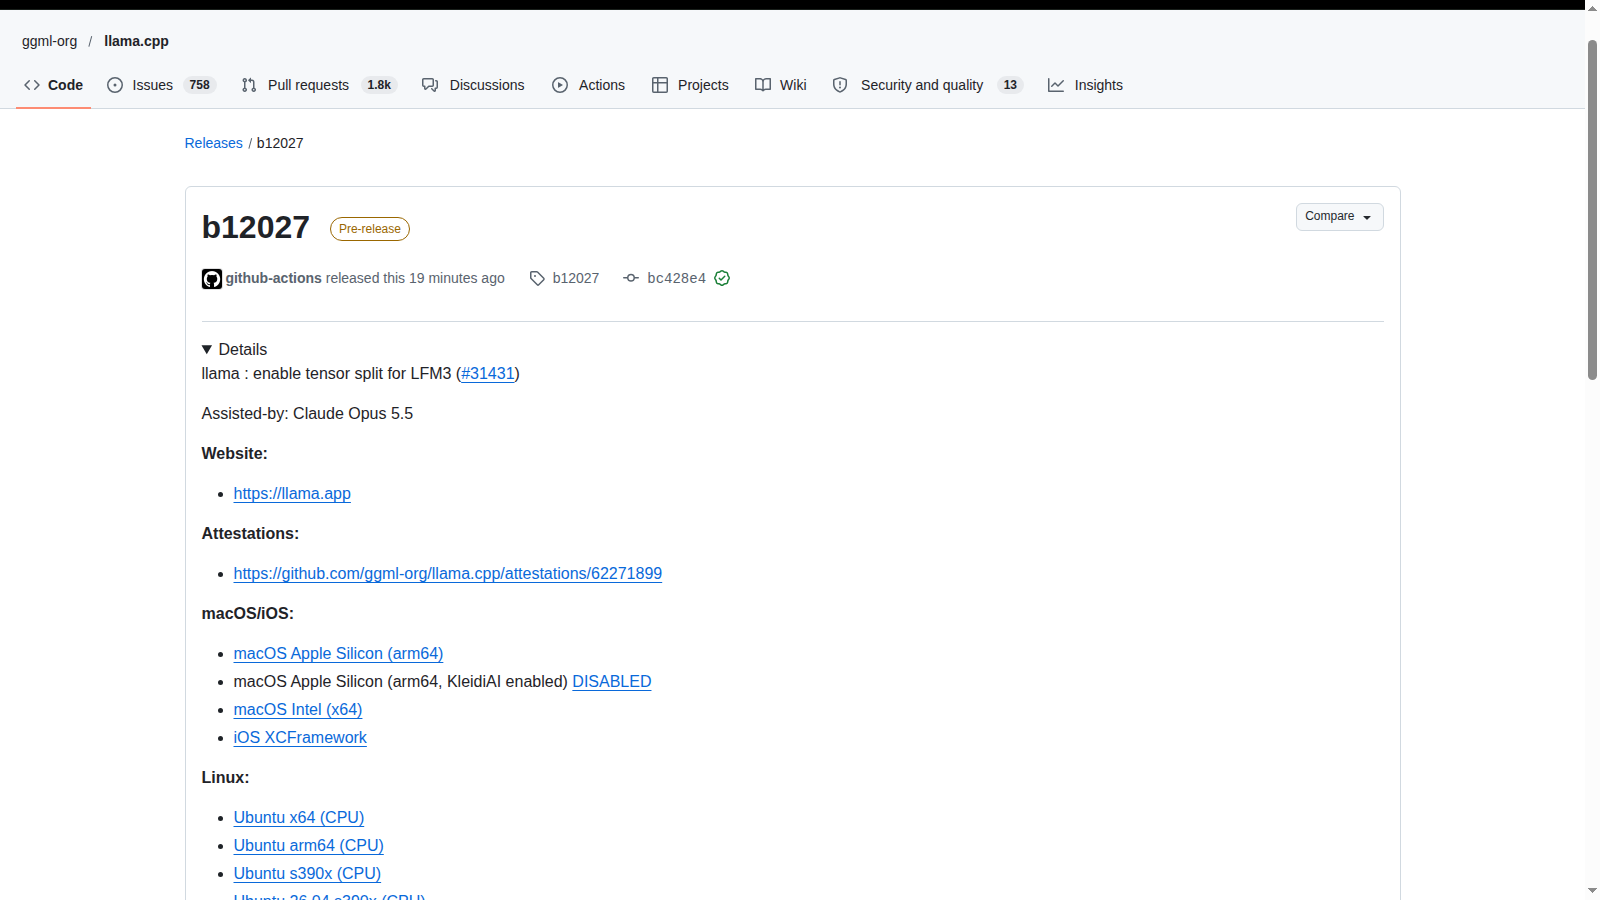
In breve: llama.cpp b12027 abilita il tensor split per l'architettura LFM3. Il cambiamento interessa il runtime e la gestione dei tensori, non i pesi scaricabili. Le prove pubblicate nella PR non migliorano allo stesso modo aumentando i dispositivi: prima di migrare serve confrontare caricamento, qualità e velocità nella configurazione effettiva.
Letti la release API ufficiale, la PR 31431 e il diff dei due file modificati. I risultati numerici appartengono all'autore della PR; la checklist è un protocollo di verifica proposto, non un test end-to-end eseguito qui.
Che cosa abilita questa build?
La release b12027 include la modifica enable tensor split for LFM3. L'API GitHub ne colloca la pubblicazione al 1 novembre 2026 alle 07:19:25 italiane e la marca come prerelease. Il merge della PR risale invece al 31 ottobre. Separare questi eventi evita di scambiare la data del feed o del merge con quella in cui la release è stata resa disponibile. Non è un nuovo modello LFM3. API GitHub: data e classificazione prerelease di b12027.
Che cosa cambia nei due file?
Il diff rimuove LFM3 dall'elenco di architetture escluse dal supporto tensor split in llama-arch.cpp. In llama-model.cpp aggiunge LFM3 al trattamento che mantiene specchiato lo stato della convoluzione breve. La dimensione ridotta del diff rende leggibile il perimetro della modifica, ma non ne misura tutte le conseguenze. Il supporto dichiarato va verificato insieme al backend e al file del modello, non dedotto dal solo numero della build. Diff ufficiale dei due file modificati.
Che cosa mostrano le prove Qualcomm?
L'autore della PR indica Qualcomm SA8797P e LFM3-1.7B Q4_0, confrontando CPU e configurazioni da una, due e quattro NPU. Le colonne di prefill e generazione non seguono lo stesso andamento: pp1024 aumenta da due a quattro NPU, mentre tg32 scende da 60,5 a 56,4. Questo è un esempio utile di compromesso, non una classifica universale. Non si trasferiscono quei valori a una GPU o a un altro carico senza una nuova misura. PR 31431: tensor split LFM3 e prove su Qualcomm SA8797P.
Come impostare un confronto utile?
Fissare il tag b12027, il commit della build, il GGUF e il backend. Confrontare una sola variabile per volta, usando lo stesso prompt non sensibile e gli stessi parametri. Separare il tempo di caricamento dalla fase di prefill e dalla generazione; annotare errori, memoria e risultati di qualità, non soltanto il dato più favorevole. La prova qui proposta deve poter mostrare anche un peggioramento o l'impossibilità di usare la configurazione desiderata. PR 31431: tensor split LFM3 e prove su Qualcomm SA8797P.
Quando conviene aggiornare il runtime?
Questo delta è pertinente a chi usa LFM3 e deve verificare una configurazione tensor split. Non dimostra un vantaggio per un'integrazione che resta su un solo dispositivo o usa un'altra architettura. L'adozione prudente passa da un ambiente di prova, una build precedente conservata e criteri di successo definiti prima del confronto. La disponibilità dei binari nella release facilita l'acquisizione, ma non sostituisce una verifica di compatibilità. llama.cpp b12027: release ufficiale e binari.
Condizioni e limitazioni
GitHub classifica b12027 come prerelease. I dati sono quelli dell'autore della PR su Qualcomm SA8797P con LFM3-1.7B Q4_0; non dimostrano lo stesso risultato su altre NPU, GPU, quantizzazioni o modelli. Nessuna inferenza o benchmark è stato eseguito in questo ciclo.
Checklist pratica
- Verificare che modello e backend richiedano davvero il supporto tensor split per LFM3.
- Registrare tag b12027, commit, file GGUF e relativa quantizzazione.
- Conservare una build precedente e isolare la prova da carichi di produzione.
- Confrontare lo stesso input separando caricamento, prefill e generazione.
- Annotare memoria, errori e controllo di qualità oltre alle prestazioni.
- Non trasferire i dati Qualcomm della PR a GPU o hardware diversi senza misurarli.
- Tenere distinto il supporto del runtime dalla licenza e dalla disponibilità dei pesi.