
L’ANALISI
MiniCPM-V 4.7: checkpoint DSpark per la decodifica speculativa
Analisi dei checkpoint DSpark per MiniCPM-V 4.7: abbinamento ai modelli 1B e 35B-A3B, vLLM, llama.cpp, acceptance length, limiti e checklist di prova.
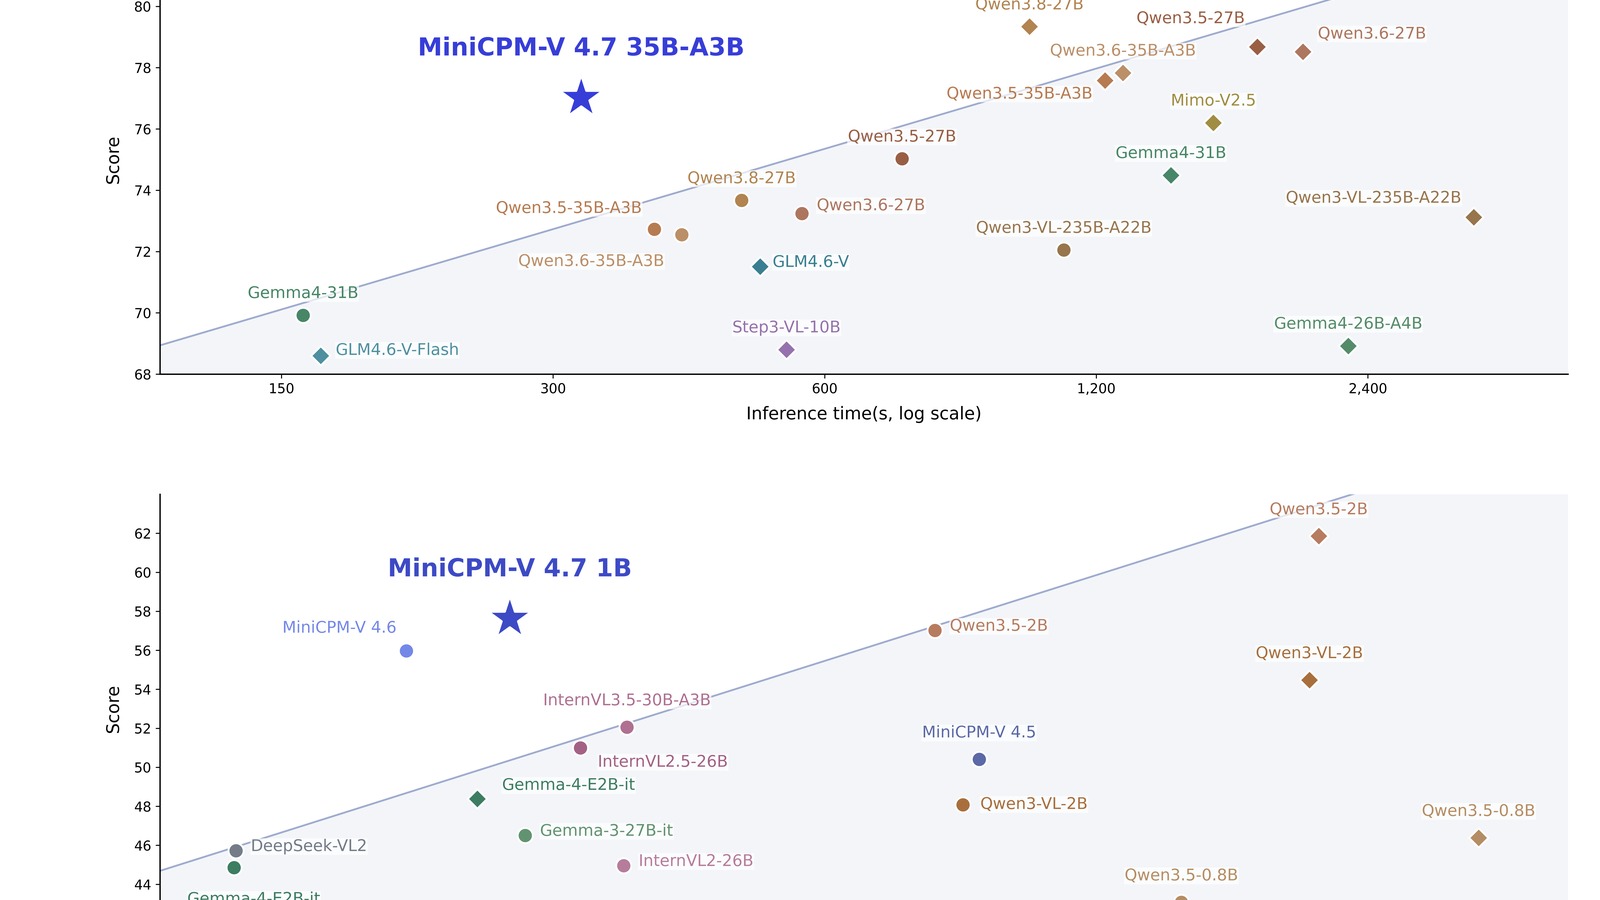
In breve: Il delta pratico è la disponibilità dei draft model DSpark ufficiali per entrambe le taglie MiniCPM-V 4.7. Possono proporre fino a 15 token prima della verifica del modello target e ora esistono ricette operative per vLLM e, sul 35B-A3B, llama.cpp; il beneficio reale va però misurato su hardware e carichi propri.
Che cosa è stato pubblicato
OpenBMB ha aggiunto due checkpoint BF16 dedicati, uno da circa 214 milioni di parametri per MiniCPM-V 4.7 1B e uno da circa 389 milioni per il 35B-A3B. Non sono modelli autonomi: ciascun draft è addestrato per una coppia esatta di modello target e tokenizer.
Come funziona il percorso DSpark
Il draft propone fino a 15 token per passaggio, mentre il modello principale li verifica. La scheda misura l’acceptance length come token completati divisi per i passaggi di verifica speculativa: è un indicatore utile del lavoro accettato, ma non sostituisce latenza e throughput end-to-end.
vLLM e configurazione riproducibile
Entrambe le schede forniscono una configurazione vLLM con metodo dspark, 15 token speculativi e verifica adattiva disattivata. Il 35B-A3B richiede inoltre tensor parallel a due vie nella ricetta pubblicata; versione del runtime, attenzione, contesto e compressione visuale devono restare fissi nel confronto.
Il percorso llama.cpp
Il repository GGUF del draft 35B-A3B include quantizzazioni da Q4 a F16 e comandi per llama-cli e llama-server. Occorrono modello target, proiettore visivo e draft della stessa famiglia, insieme a una build con architettura dflash e DSpark Markov head.
Che cosa misurare prima di adottarlo
Un test utile confronta lo stesso target con e senza draft su prompt testuali e multimodali. Vanno registrati acceptance length, tempo al primo token, token al secondo, memoria, consumo e stabilità, senza attribuire al draft eventuali differenze introdotte da quantizzazione o runtime.
Condizioni e limitazioni
I valori di acceptance length sono misure dichiarate da OpenBMB, non benchmark indipendenti, e non equivalgono direttamente a un aumento di token al secondo. Ogni draft funziona solo con il target MiniCPM-V corrispondente; il percorso llama.cpp richiede una build con architettura dflash e DSpark Markov head.
Checklist pratica
- Fissare revisione del target, del draft e del runtime.
- Verificare che draft e tokenizer corrispondano esattamente al modello target.
- Preparare lo stesso set di prompt testuali, immagini e documenti.
- Eseguire una baseline senza speculative decoding.
- Ripetere con DSpark mantenendo invariati contesto, batch e quantizzazione.
- Registrare acceptance length, latenza, throughput, memoria e consumo.
- Per llama.cpp, verificare dflash, Markov head, mmproj e file GGUF abbinati.