
L’ANALISI
LFM2.5-24B-A2B: cosa offre agli agenti locali
Analisi pratica di LFM2.5-24B-A2B: pesi aperti, 2B parametri attivi, supporto llama.cpp e MLX, benchmark dichiarati, limiti e checklist per testare agenti locali.
In breve: Il rilascio rende scaricabile un modello MoE da 24B totali ma 2B attivi, pensato per agenti locali e già accompagnato da supporto nei principali runtime. È un candidato concreto per Apple Silicon e AMD Ryzen AI, ma i numeri di velocità e qualità provengono da Liquid AI: prima di adottarlo servono prove riproducibili con gli stessi task, quantizzazione e contesto del proprio ambiente.
Che cosa è disponibile
Liquid AI pubblica sia il modello base sia quello post-trained su Hugging Face. LFM2.5-24B-A2B mantiene 40 layer e 64 esperti per blocco MoE con routing top-4, ma attiva circa 2 miliardi di parametri per token. Il contesto sale da 32.768 a 131.072 token e il vocabolario da 65K a 128K.
Runtime e requisiti pratici
Il produttore dichiara supporto iniziale per llama.cpp con checkpoint GGUF, MLX su Apple Silicon, vLLM e SGLang per serving GPU e ONNX per acceleratori diversi. La memoria dichiarata con Q4_K_M è 15 GB su Apple M5 Max e 16 GB sul sistema AMD Ryzen AI Max+ 395: valori utili come punto di partenza, non come garanzia per contesti lunghi o agent loop complessi.
Che cosa misurano i benchmark
Liquid AI confronta il modello su tool use, agenti, istruzioni, conoscenza e coding. LFM2.5 guida o pareggia cinque degli otto benchmark agentici selezionati, ma Qwen3.6-35B-A3B resta avanti in WebArena Verified, GPQA Diamond, SWE-Bench Verified e SciCode. I risultati sono vendor benchmark con configurazioni pubblicate, non una replica indipendente.
Post-training dentro agent harness
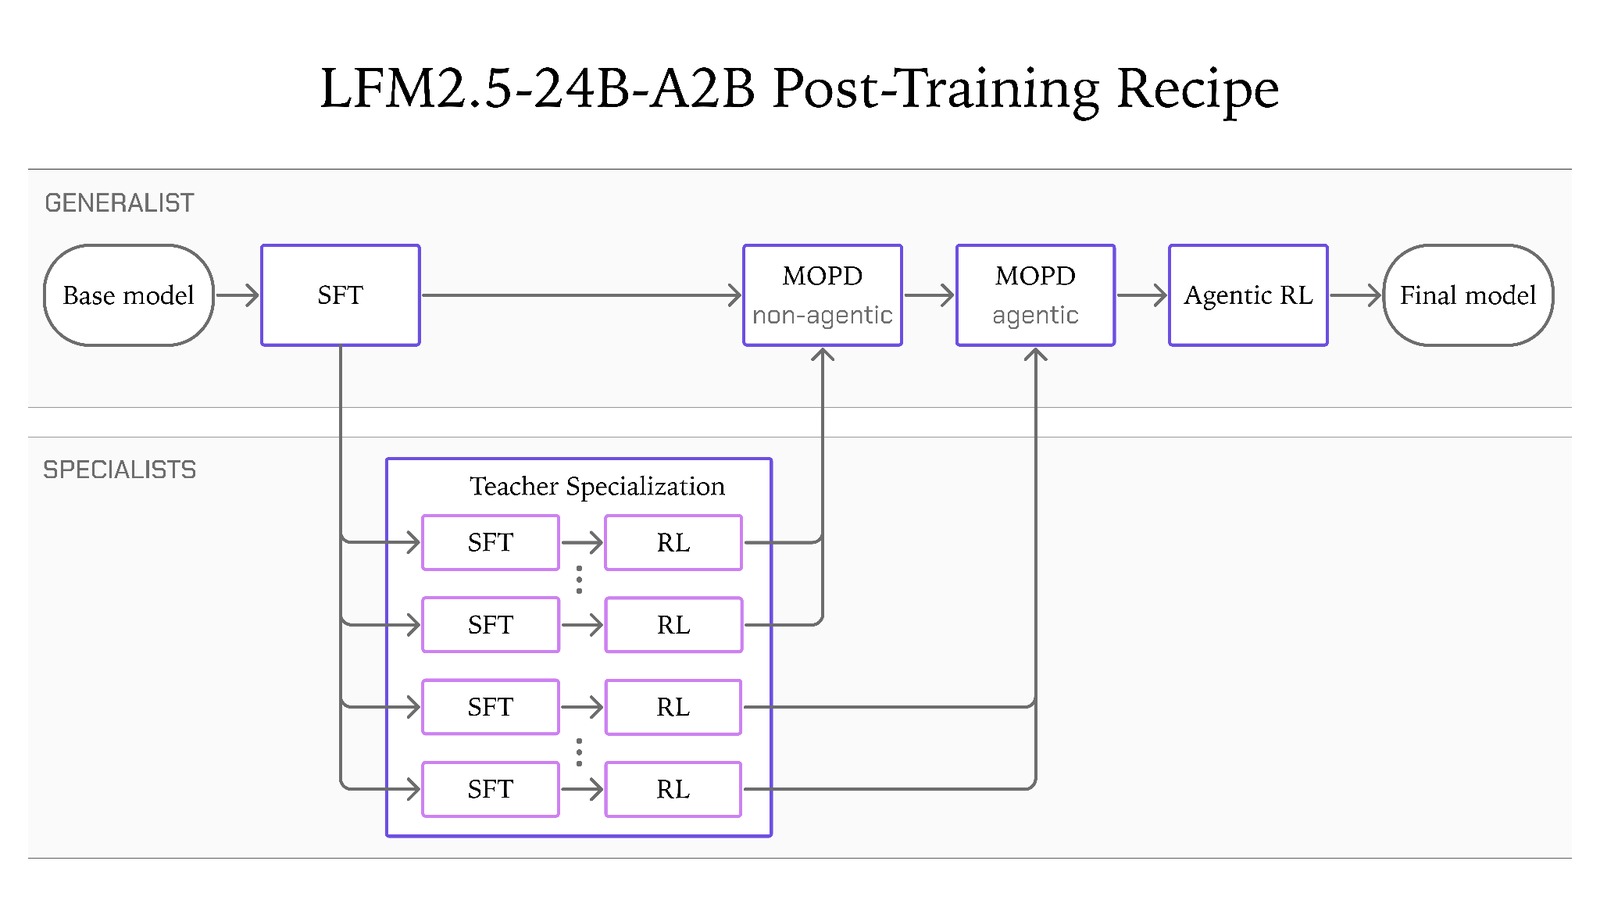
La pipeline include supervised fine-tuning, specializzazione del teacher, distillazione on-policy e reinforcement learning agentico. Liquid AI indica training in OpenClaw, Hermes Agent, Pi e OpenCode e descrive comportamenti di reward hacking rilevati nei sandbox. Questo rende il modello interessante per tool use, ma non dimostra affidabilità su permessi, prompt injection o strumenti reali.
Condizioni e limiti
Open-weight non equivale a software senza vincoli: bisogna leggere la LFM License, fissare revisione e quantizzazione e isolare gli strumenti concessi al modello. Le prestazioni pubblicate usano hardware, runtime e contesti specifici; contesto lungo, memoria persistente e chiamate a strumenti possono cambiare drasticamente latenza, memoria e tasso di completamento.
Condizioni e limitazioni
Velocità e benchmark sono misure del produttore, non test indipendenti. I 184 token/s su Apple M5 Max e 114 token/s su AMD Ryzen AI Max+ 395 usano quantizzazione Q4_K_M e contesto di input da 4K; sul coding dichiarato il modello resta sotto Qwen3.6-35B-A3B in SWE-Bench Verified. La licenza LFM va verificata per il proprio uso.
Checklist pratica
- Leggere e archiviare model card, LFM License e revisione dei pesi.
- Scegliere una quantizzazione GGUF o MLX compatibile con la memoria disponibile.
- Fissare versione di runtime, template chat e parametri di generazione.
- Preparare lo stesso task agentico con una tool call consentita e output verificabile.
- Eseguire almeno tre run annotando completamento, latenza, RAM o VRAM ed errori.
- Confrontare una baseline senza agent loop e un modello alternativo della stessa classe.
- Tenere rete, filesystem e comandi distruttivi disabilitati finché il protocollo non passa.