
L’ANALISI
llama.cpp b11408: Q8_0 passa al kernel IME1 su SpacemiT X60
Che cosa cambia in llama.cpp b11408 per Q8_0 su SpacemiT X60, come leggere il benchmark dichiarato e come ripetere una prova controllata.
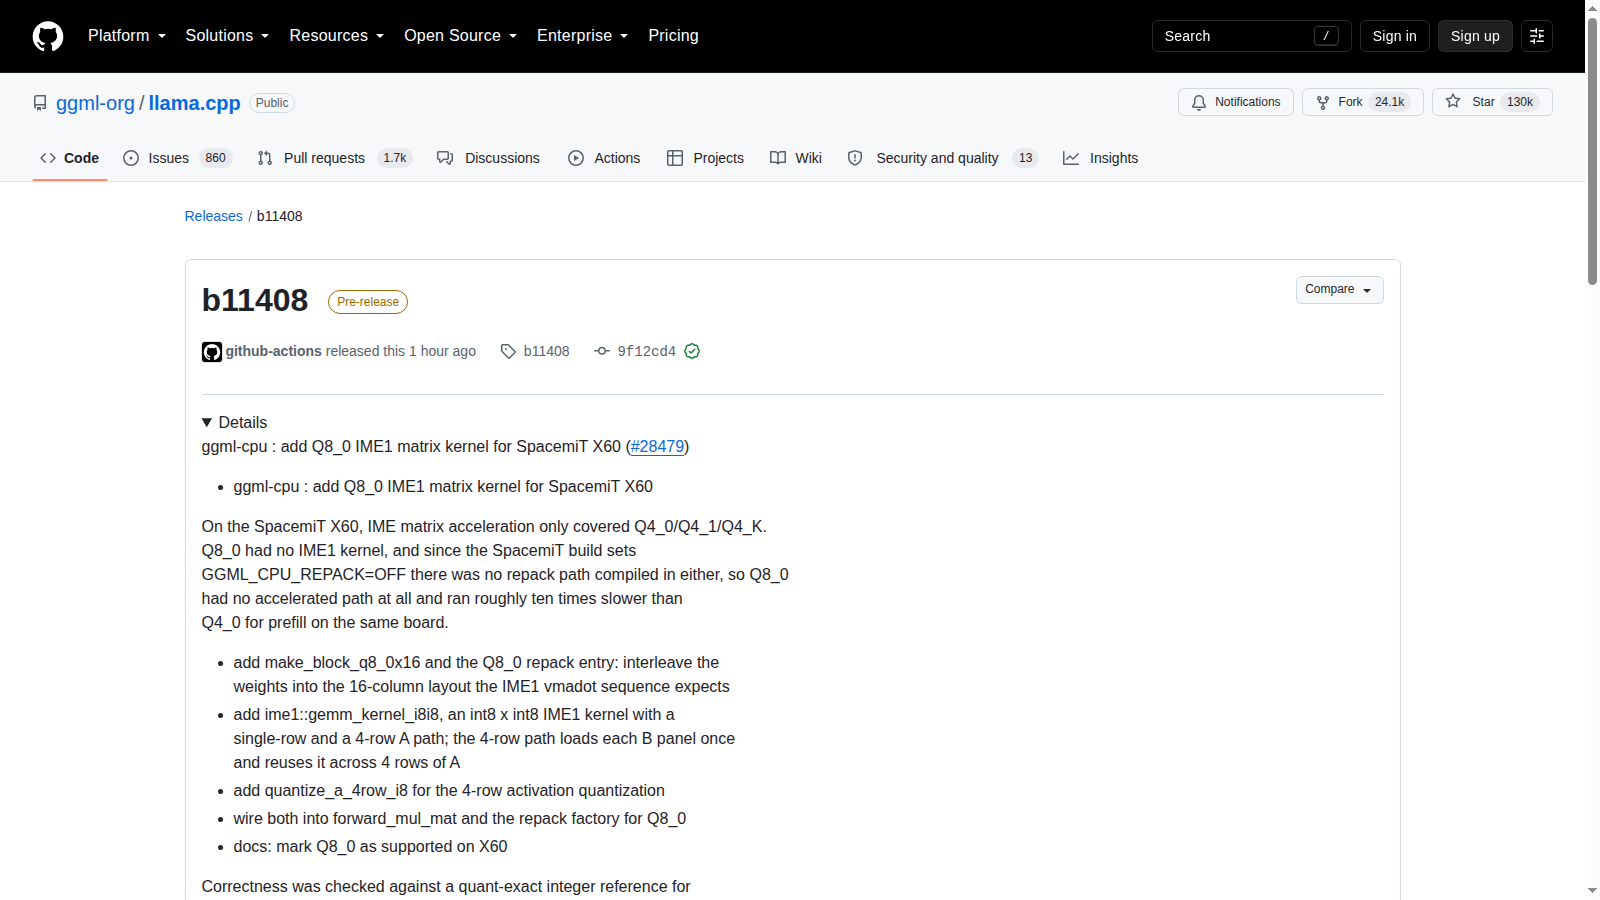
In breve: b11408 colma il percorso accelerato mancante per Q8_0 sullo SpacemiT X60. Il benchmark del progetto mostra un forte recupero nel prefill, ma non autorizza a estendere il risultato alla generazione o ad altri SoC RISC-V.
Il delta verificato
La release aggiunge il repack Q8_0 in blocchi da 16 colonne, un kernel IME1 int8 per la moltiplicazione di matrici e percorsi distinti per una o quattro righe di attivazioni.
Perché Q8_0 restava indietro
Sul build SpacemiT X60 la matrice IME copriva Q4_0, Q4_1 e Q4_K. Q8_0 non aveva né kernel IME1 né il percorso repack e ricadeva su un percorso molto più lento.
Come leggere il benchmark
Su Milk-V Jupiter con Bianbu 2.1.1, GCC 14.2 e Qwen2.5-0.5B-Instruct Q8_0, llama-bench con quattro thread e cinque ripetizioni porta pp128 da 10,70 a 93,87 token/s. Q4_0 passa da 106,40 a 107,51 token/s.
Correttezza e implementazione
Il progetto dichiara verifiche contro un riferimento intero quantizzato per K da 32 a 4096, errore relativo massimo di circa 1e-6 e generazione coerente su più prompt.
Che cosa non dimostra la release
La misura riguarda pp128 su un modello piccolo e una scheda precisa. Non riporta token generation, memoria, consumo energetico o confronto con altri runtime.
Condizioni e limitazioni
È una pre-release e il dato proviene da un solo progetto, una sola scheda, un modello da 0,5B e cinque ripetizioni. Non dimostra lo stesso guadagno in generazione, su contesti diversi, con altri modelli o su hardware RISC-V differente.
Checklist per una prova controllata
- Conservare la build precedente come rollback.
- Usare la stessa scheda X60, governor CPU, affinità dei core e temperatura iniziale.
- Fissare modello GGUF Q8_0, prompt, contesto, thread e batch.
- Eseguire warm-up separati prima delle misure.
- Ripetere almeno cinque run di pp128 e token generation.
- Confrontare mediana, dispersione, memoria e consumo se disponibile.
- Verificare gli output e provare almeno un modello più grande.