
IL PUNTO SULL’AI
5 ottobre 2026
IBM pubblica una ricetta aperta per combinare quattro modelli time-series, mentre OpenAI introduce textGrain e sperimenta annunci visuali in ChatGPT.
In questa edizione 7 notizie
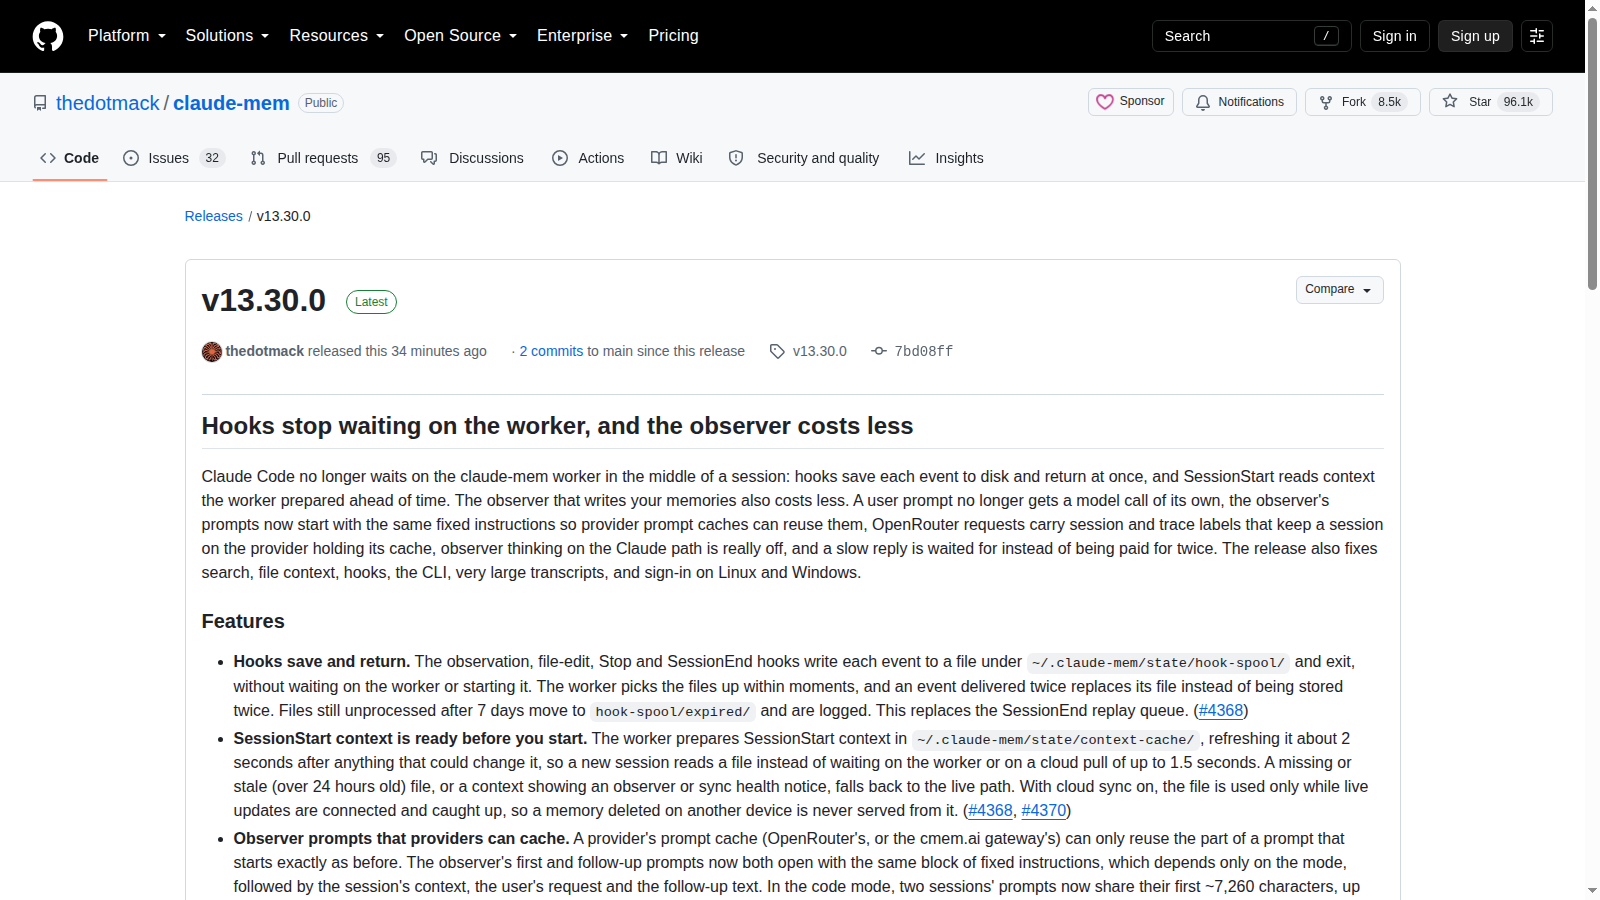
Claude-Mem 13.30 salva gli eventi degli hook su disco e restituisce subito il controllo, prepara in anticipo il contesto di SessionStart e rimuove una chiamata al modello per ogni prompt. La release aggiunge anche prompt più riutilizzabili dalle cache provider e gestione streaming delle risposte lente.
Limiti da conoscere
Limite: I miglioramenti sono descritti e testati dal progetto, non misurati qui end-to-end. La coda locale scade dopo sette giorni, la cache del contesto ha fallback live e la sincronizzazione cloud resta un confine esterno da valutare separatamente.
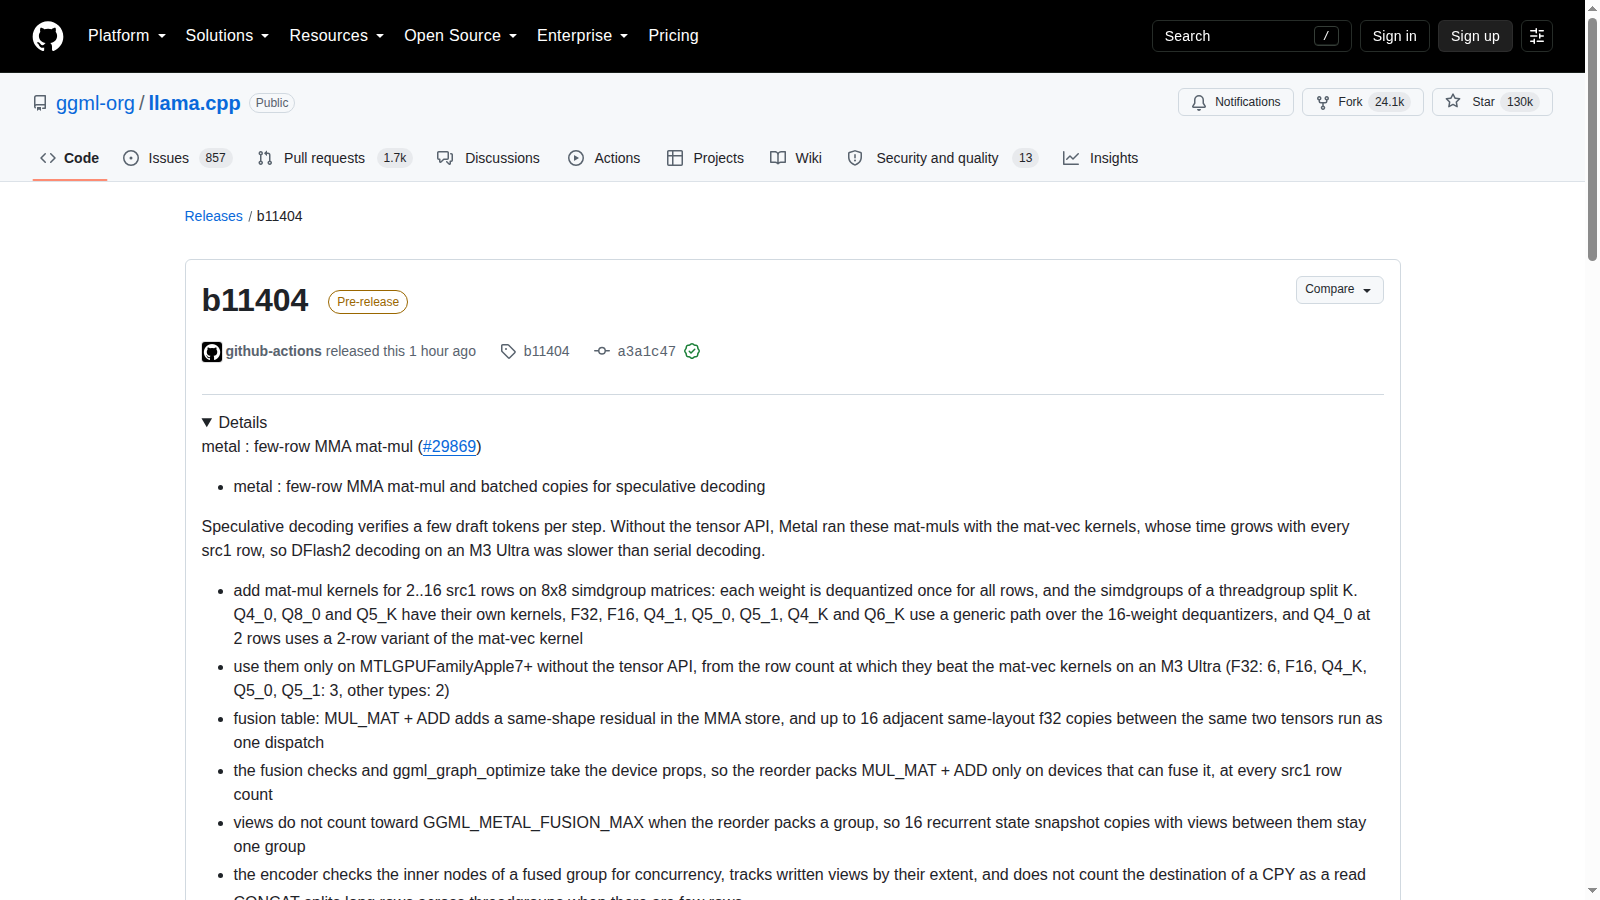
La pre-release b11404 aggiunge kernel Metal MMA per moltiplicazioni con 2-16 righe, il caso tipico della verifica di pochi token nella speculative decoding. Il progetto segnala che, senza Tensor API, DFlash2 su M3 Ultra risultava più lento della decodifica seriale; la nuova selezione usa i kernel solo da Apple GPU family 7 e oltre, in base al tipo e al numero di righe.
Limiti da conoscere
Limite: È una pre-release e la soglia dei kernel deriva da misure del progetto su M3 Ultra. Non sono pubblicati risultati completi end-to-end né un vantaggio garantito per ogni Mac, modello, quantizzazione o configurazione speculative.
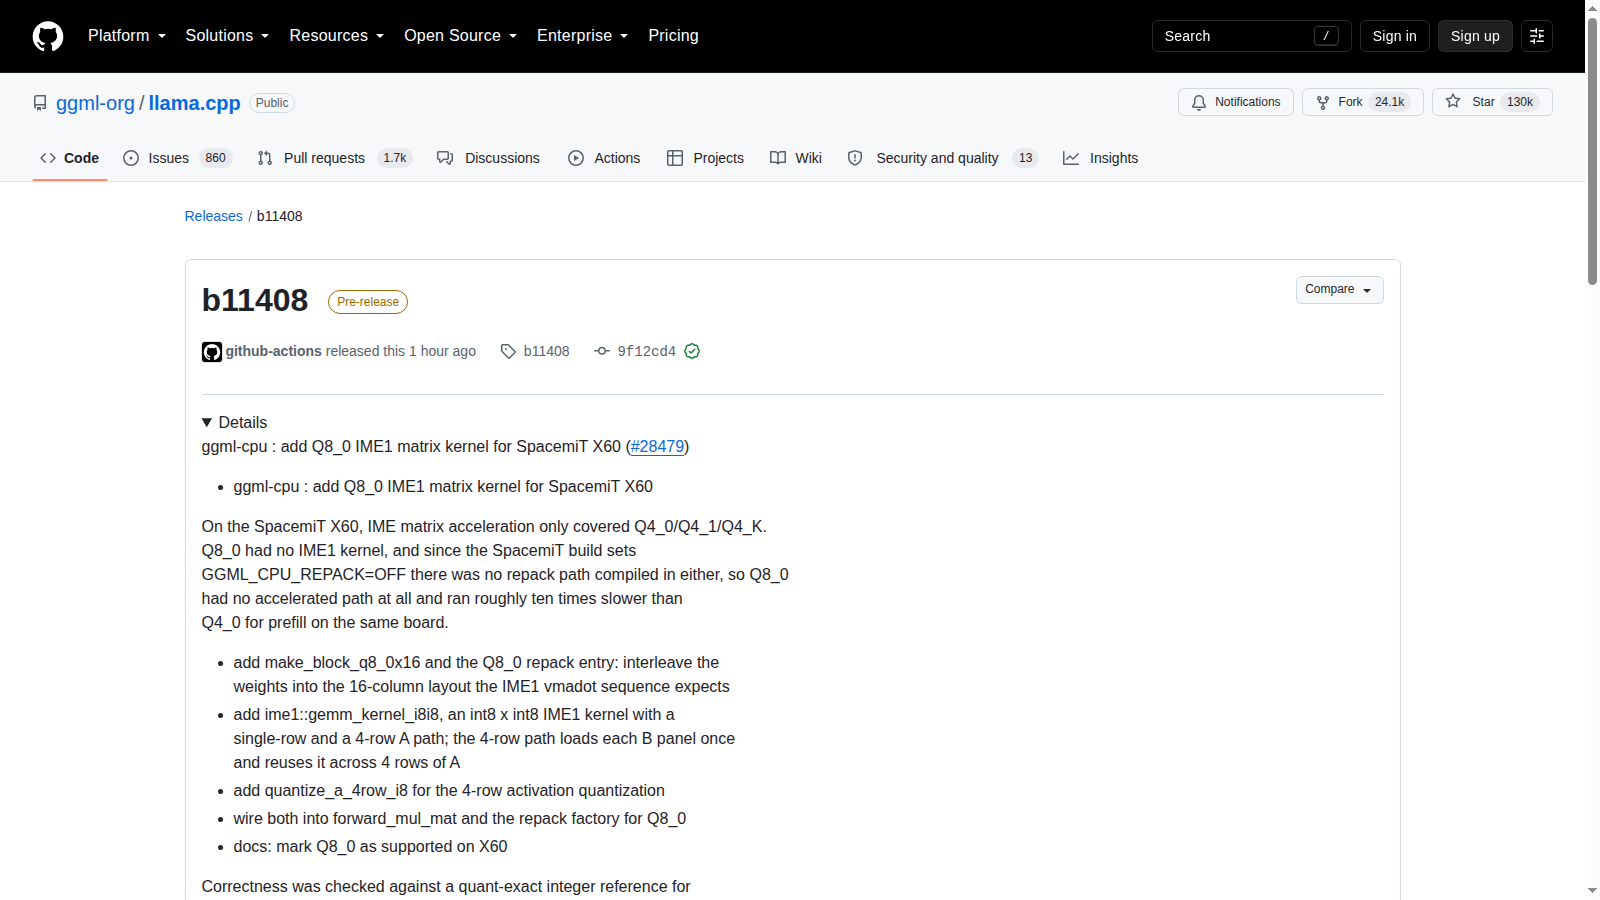
La pre-release b11408 aggiunge un kernel IME1 int8 per Q8_0 sul SoC RISC-V SpacemiT X60. Nel test dichiarato dal progetto su Milk-V Jupiter con Qwen2.5-0.5B-Instruct, il prefill pp128 passa da 10,70 a 93,87 token/s; Q4_0 resta sostanzialmente invariato.
Limiti da conoscere
Limite: È una pre-release e il dato proviene da un solo progetto, una sola scheda, un modello da 0,5B e cinque ripetizioni. Non dimostra lo stesso guadagno in generazione, su contesti diversi, con altri modelli o su hardware RISC-V differente.
Dal 1 ottobre Google non accetta temporaneamente nuove segnalazioni di vulnerabilità prodotto nel programma OSS VRP: indica un forte aumento di invii automatici, in larga parte non validi. Restano aperti i report sulla supply chain, le pratiche già inviate e percorsi alternativi come Cloud VRP e Patch Rewards; un aggiornamento è previsto nel primo trimestre 2027.
Limiti da conoscere
Limite: La pausa riguarda uno specifico canale di segnalazione, non l’intero programma open source. Google non ha pubblicato volumi, tasso preciso di invalidità o il nuovo meccanismo di ammissione, quindi non è possibile misurare l’impatto complessivo né attribuirlo a un singolo strumento AI.
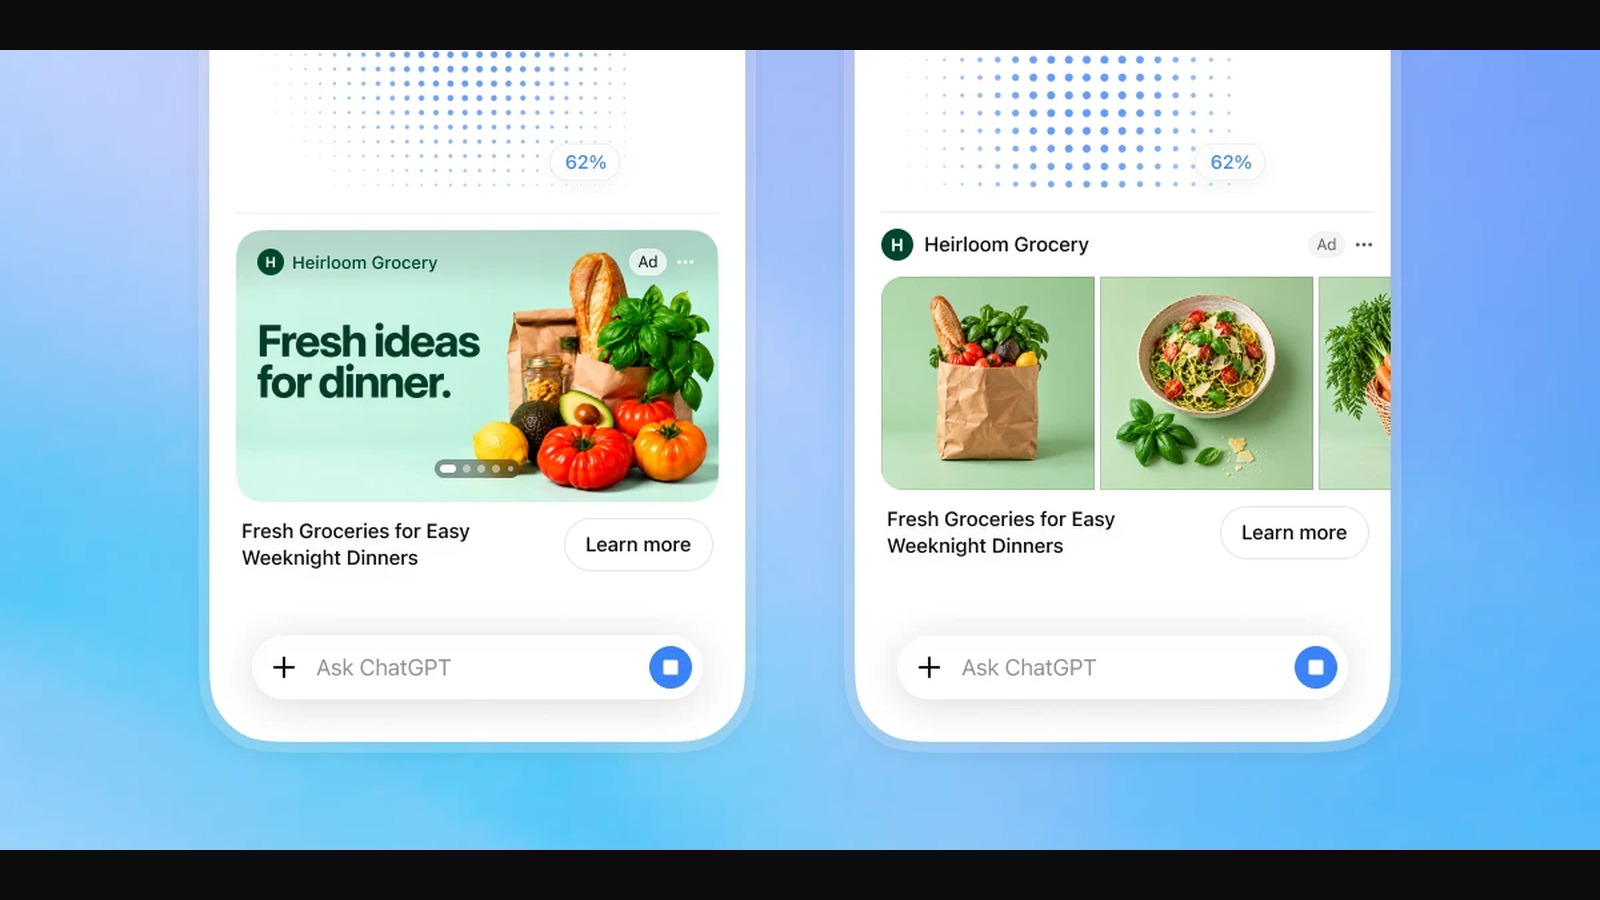
OpenAI avvierà entro ottobre negli Stati Uniti un test con un primo gruppo di inserzionisti: durante la generazione di immagini in ChatGPT appariranno annunci visuali etichettati e separati dall’immagine prodotta. In parallelo amplia integrazioni per conversioni, attribuzione, incrementality e brand suitability.
Limiti da conoscere
Limite: È un test iniziale negli Stati Uniti, non un rollout globale. I risultati di performance citati da OpenAI provengono da partner e singoli inserzionisti: non sono ancora un benchmark indipendente e generalizzabile.
OpenAI rende opzionale da subito il watermark testuale textGrain per alcuni modelli API e prevede di applicarlo nelle prossime settimane agli output idonei di ChatGPT e Codex nell’Unione europea. Il rilevatore sarà inizialmente accessibile su richiesta a ricercatori e organizzazioni esperte.
Limiti da conoscere
Limite: Il segnale statistico può indebolirsi con modifiche, traduzioni o testi brevi. Un watermark non misura il contributo umano, non prova proprietà, responsabilità o accuratezza e la sua assenza non dimostra che un testo sia umano.
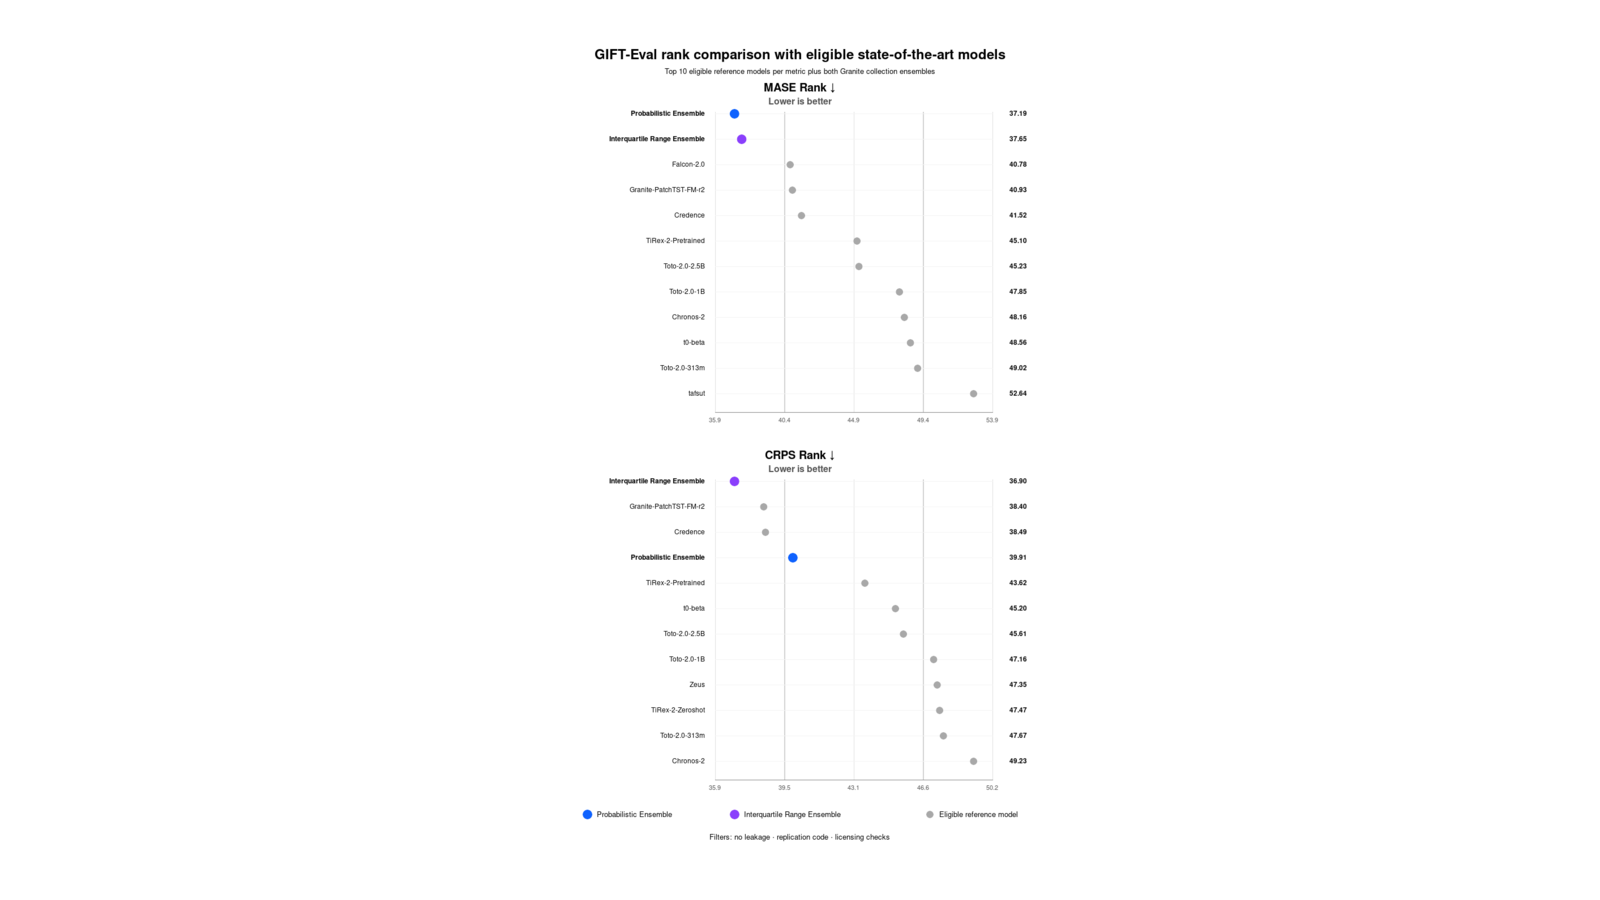
IBM rende scaricabile una ricetta Apache 2.0 che combina quattro checkpoint Granite per produrre previsioni quantili zero-shot. Il default usa un pooling uniforme e il repository include anche una variante pesata sull’intervallo interquartile.
Limiti da conoscere
Limite: Non è un nuovo peso fuso: i quattro checkpoint vengono scaricati dai rispettivi repository, aumentando memoria e latenza. I risultati GIFT-Eval sono dichiarati nel model card e vanno verificati sui dati reali, soprattutto sotto cambio di distribuzione.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.