
L’ANALISI
llama.cpp b11404: nuovi kernel Metal per la speculative decoding
Che cosa cambia in llama.cpp b11404 per la speculative decoding su Metal, quali Mac e quantizzazioni coinvolge e come misurare il vantaggio reale.
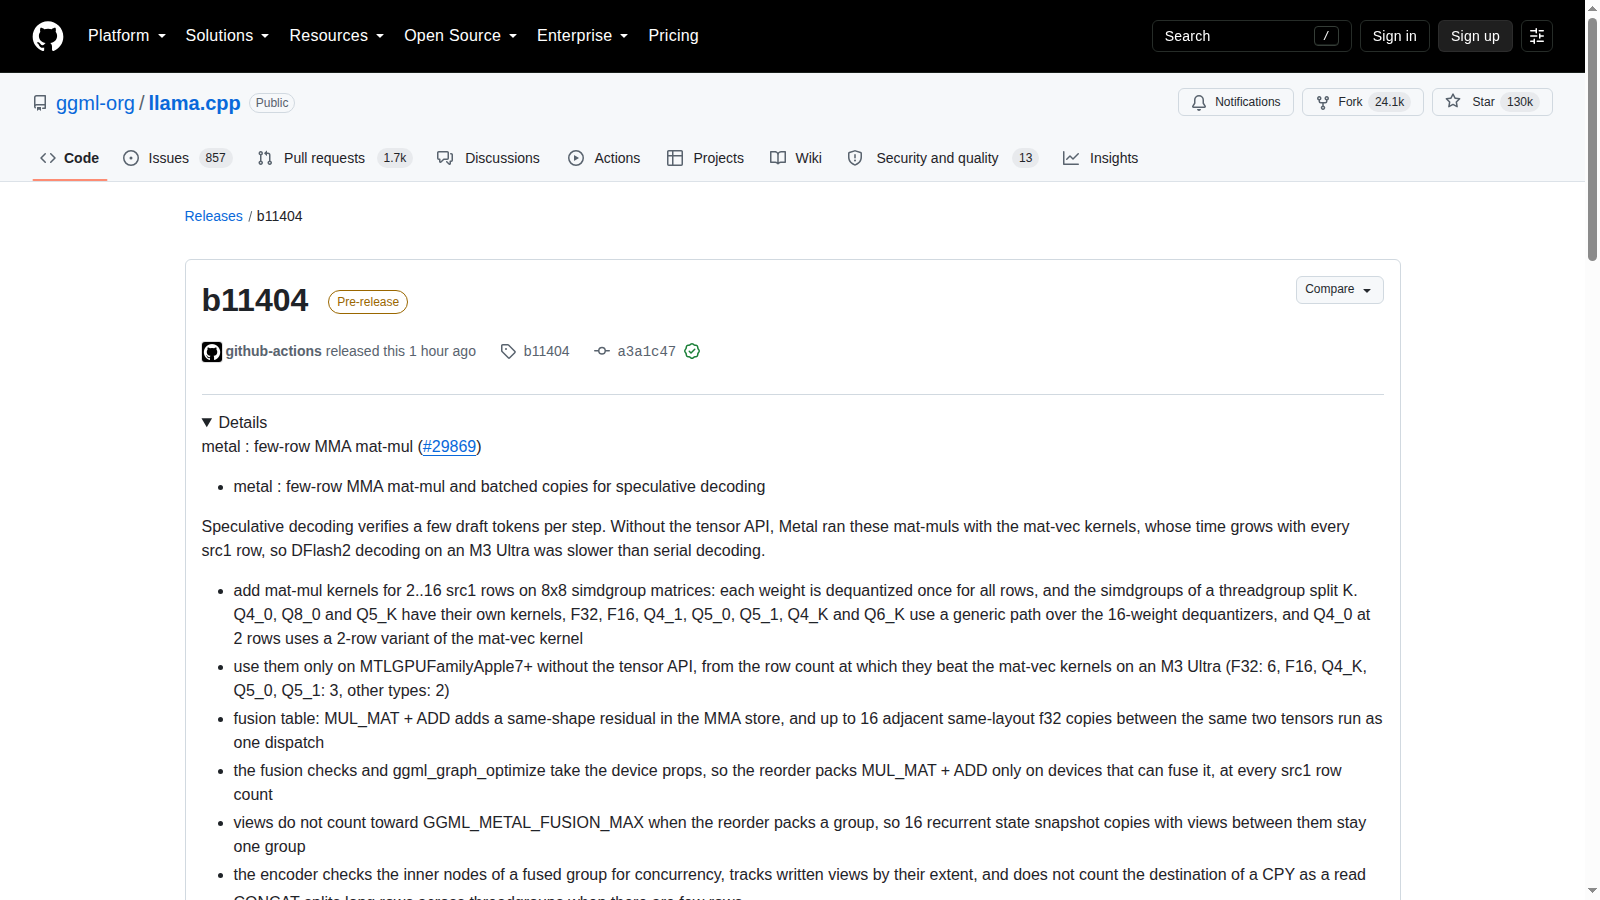
In breve: b11404 introduce kernel Metal specializzati per verificare piccoli gruppi di token speculativi sui Mac Apple Silicon senza Tensor API. È un miglioramento eseguibile, ma il vantaggio va misurato contro la decodifica seriale sullo stesso modello e hardware.
Il delta verificato
La release implementa moltiplicazioni MMA per input da 2 a 16 righe. Sono proprio le forme usate quando il modello principale verifica pochi token prodotti dal draft model in uno step di speculative decoding.
Perché il percorso precedente era lento
Senza Tensor API, Metal usava kernel matrice-vettore il cui costo cresceva con ogni riga del secondo operando. Il changelog indica che DFlash2 su M3 Ultra poteva così risultare più lento della decodifica seriale.
Hardware e quantizzazioni coinvolti
Il selettore abilita il percorso sulle GPU Apple family 7 e successive. Q4_0, Q8_0 e Q5_K hanno kernel dedicati; F32, F16, Q4_1, Q5_0, Q5_1, Q4_K e Q6_K passano da un percorso generico con dequantizzazione condivisa.
Quando viene scelto il nuovo kernel
Le soglie cambiano per tipo: F32 da sei righe, F16, Q4_K, Q5_0 e Q5_1 da tre, gli altri tipi supportati da due. La logica serve a evitare il nuovo percorso quando il kernel precedente resta più conveniente.
Che cosa non dimostra la release
Il merge include test di operazioni e ottimizzazione del grafo, ma non una comparazione end-to-end su più Mac. Non permette quindi di stimare automaticamente accettazione dei draft token, latenza totale o risparmio energetico.
Condizioni e limitazioni
È una pre-release e la soglia dei kernel deriva da misure del progetto su M3 Ultra. Non sono pubblicati risultati completi end-to-end né un vantaggio garantito per ogni Mac, modello, quantizzazione o configurazione speculative.
Checklist per una prova controllata
- Conservare la build precedente come rollback.
- Registrare modello principale, draft model, quantizzazioni e numero massimo di token proposti.
- Usare lo stesso prompt e seed, dopo almeno un warm-up per build.
- Misurare latenza al primo token, token al secondo, memoria e tasso di accettazione dei draft.
- Ripetere almeno cinque run e confrontare mediana e dispersione.
- Controllare l’uguaglianza o l’equivalenza accettabile degli output.
- Provare almeno una sequenza lunga rappresentativa del carico reale.