
L’ANALISI
K2 Horizon MoVA 36B-A4B e 0.9B: pesi disponibili, due test molto diversi
IFM completa due estremi della famiglia: un MoE locale da 36B totali e 4B attivi, e un modello denso da 0.9B. I pesi sono reali, ma requisiti e promesse vanno verificati separatamente.
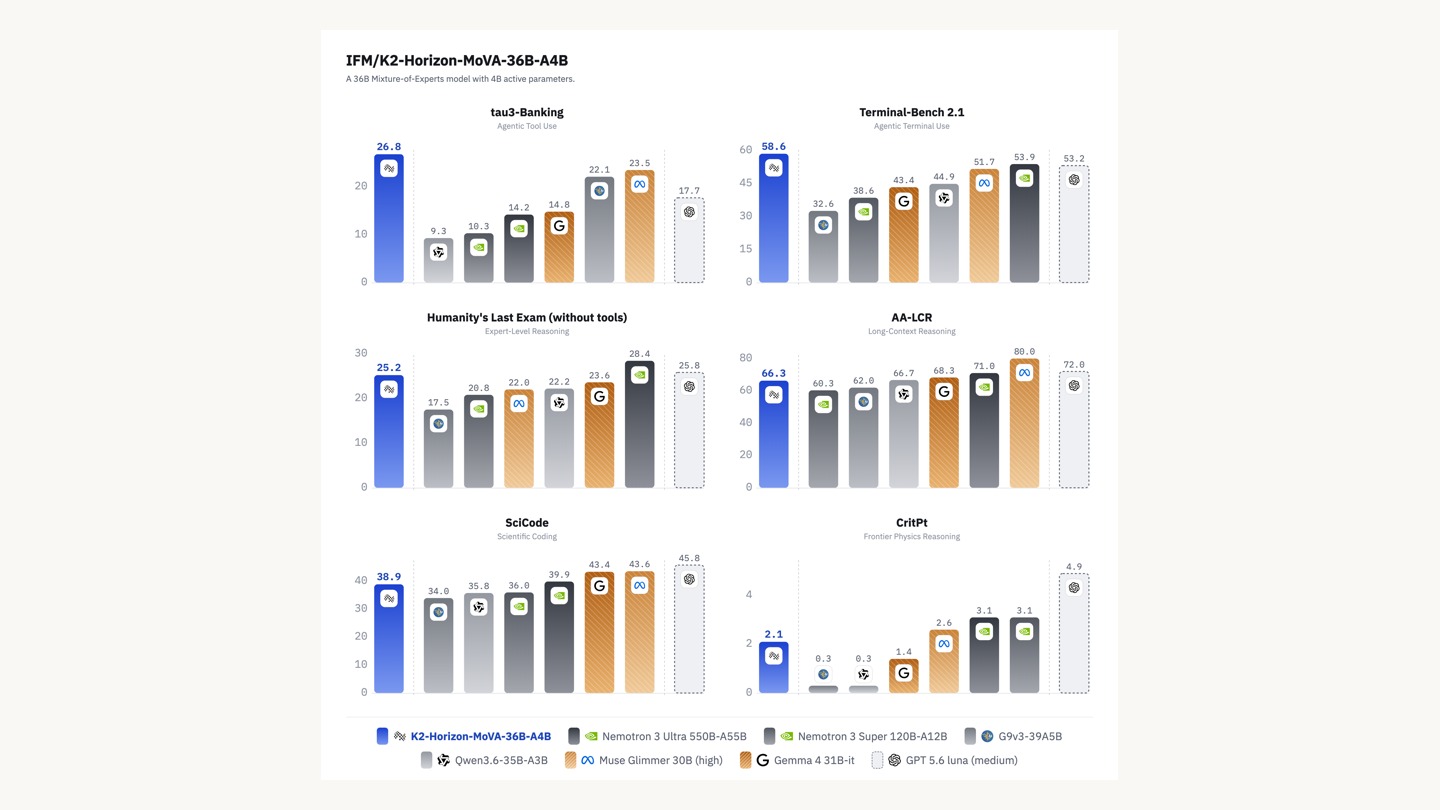
In breve: i repository contengono ora pesi, tokenizer, configurazioni e codice eseguibile per entrambi i modelli. Il 36B-A4B è il candidato per serving efficiente su più GPU; il 0.9B è il candidato per misurare quanto reasoning e tool use sopravvivano con memoria limitata.
Che cosa è diventato scaricabile
Il delta verificato è concreto: 48 shard safetensors e indice completo per MoVA 36B-A4B, un singolo shard per 0.9B, più codice del modello, tokenizer, template chat e configurazioni. Non è un semplice aggiornamento della scheda.
MoVA 36B-A4B: capacità e costo attivo
Il modello conserva 36B parametri ma ne attiva circa 4B per token combinando MoE e Mixture-of-Value Attention. La ricetta SGLang ufficiale usa tensor ed expert parallel su due H200: il numero di parametri attivi non equivale quindi a un requisito da 4B su una GPU consumer.
0.9B: piccolo, ma non automaticamente edge
Il modello denso dichiara 128K token e risultati competitivi su matematica e codice. La ricetta raccomanda reasoning high e fino a 32.768 token di output: latenza, energia e memoria KV possono dominare anche quando i pesi sono piccoli.
Serving e confine di fiducia
Entrambi richiedono trust_remote_code e parser specifici per reasoning e tool calling. Prima di collegare strumenti reali conviene fissare lo SHA, revisionare il Python remoto e isolare rete, filesystem e credenziali.
Condizioni e limitazioni
I confronti e i benchmark provengono da IFM. Il codice di training e il report tecnico risultano ancora in preparazione; per 0.9B alcuni checkpoint RL sono incompleti. Il contesto massimo dichiarato non prova qualità o sostenibilità al limite.
Checklist pratica
- Fissare lo SHA e revisionare modeling_k2_horizon.py prima di usare trust_remote_code.
- Misurare BF16 prima delle quantizzazioni, registrando VRAM, latenza e token al secondo.
- Per 36B-A4B confrontare una e due GPU, verificando router, tensor parallel ed expert parallel.
- Per 0.9B provare 8K, 32K e 128K con documenti a risposta nota e output limitati.
- Testare tool calling con argomenti errati, timeout e azioni negate.
- Conservare prompt, revisione, backend e risultati per una prova ripetibile.