
L’ANALISI
llama.cpp b10981: cosa cambia per Gemma 4 e OpenVINO
Il backend OpenVINO corregge output errati con Gemma 4, modifica il decode stateful e aggiunge leve esplicite per memoria e storage.
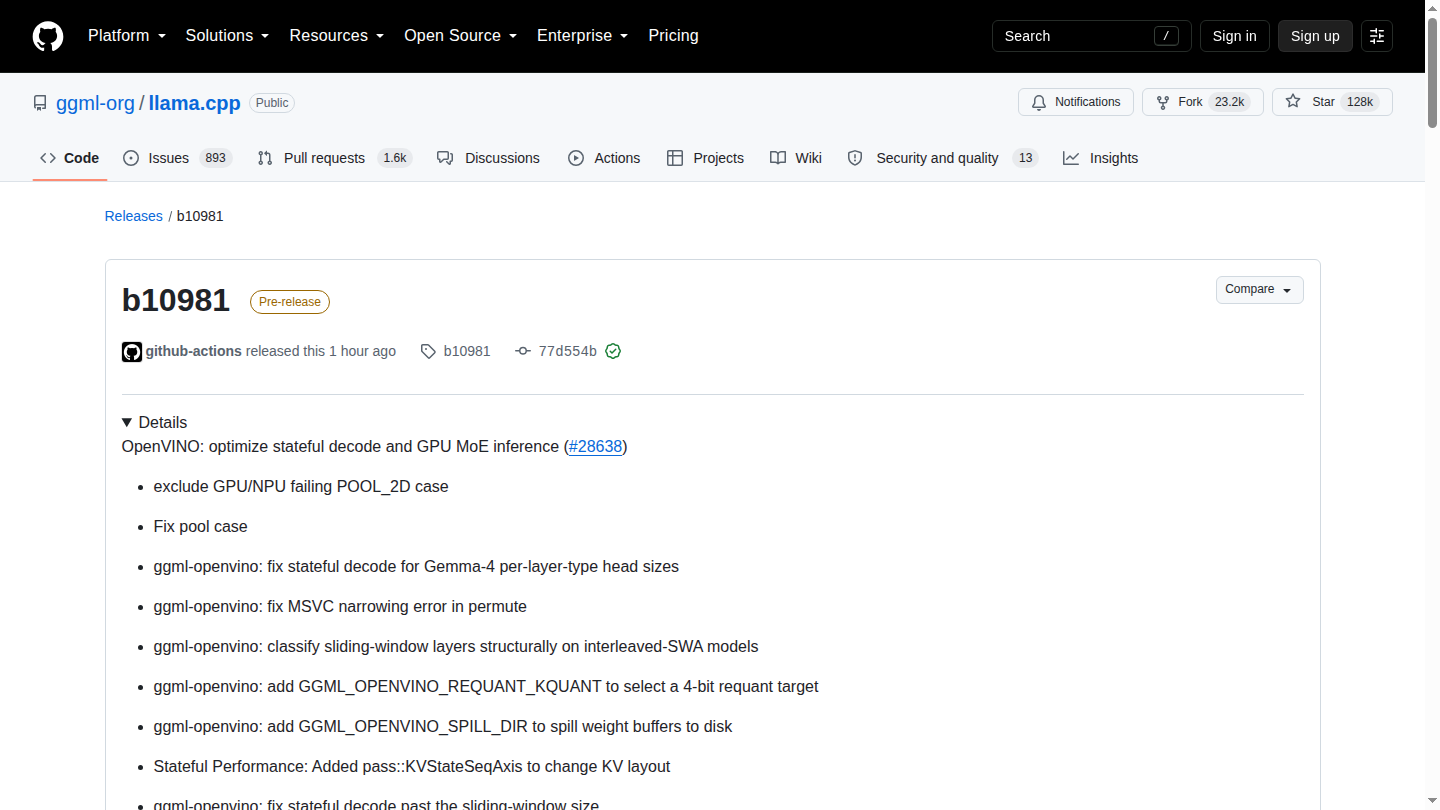
In breve: b10981 è rilevante soprattutto per chi usa llama.cpp con OpenVINO: corregge la struttura dello stato KV di Gemma 4, evita riprese non valide oltre la sliding window e introduce opzioni per requantizzare a 4 bit o scaricare buffer dei pesi su disco.
Il bug Gemma 4 corretto
Gemma 4 varia numero e dimensione delle KV head tra layer sliding e full attention. Il backend usava ancora un conteggio globale: secondo la release, molti layer venivano reinterpretati con lo split sbagliato e i modelli 12B e 31B producevano output corrotto su CPU e GPU.
Decode stateful e contesto lungo
Il nuovo percorso riorganizza lo stato KV per ridurre il costo delle trasposizioni quando il contesto cresce. Quando una sequenza sliding-window non può essere ricostruita dal prefisso disponibile, ora il backend rifiuta l’operazione con un messaggio esplicito invece di proseguire con stato errato.
Requantizzazione e spill su disco
GGML_OPENVINO_REQUANT_KQUANT seleziona un target di requantizzazione a 4 bit. GGML_OPENVINO_SPILL_DIR permette di spostare buffer dei pesi su disco. Sono leve operative, non garanzie: il primo può influire sulla qualità, il secondo aggiunge dipendenza dalle prestazioni dello storage.
Prestazioni dichiarate e cosa manca
Gli autori riportano miglioramenti GPU a profondità 8192 per Gemma 4 12B e Llama 3.2 1B. Sono misure interne su casi specifici: prima di generalizzare servono hardware, driver, modello, quantizzazione, profondità, warm-up e almeno tre ripetizioni identiche.
Condizioni e limitazioni
b10981 è una pre-release. OpenVINO nel repository è ancora indicato come backend in sviluppo; alcune operazioni restano escluse o deviate alla CPU e la CI serializza test GPU che in parallelo possono esaurire risorse OpenCL.
Checklist pratica
- Registrare CPU, GPU o NPU Intel, driver e versione OpenVINO.
- Conservare la build precedente e usare lo stesso GGUF e gli stessi parametri.
- Provare Gemma 4 con prompt e profondità che esercitino layer sliding e full attention.
- Misurare prompt processing, token al secondo, memoria di picco e correttezza dell’output per almeno tre run.
- Attivare requantizzazione e spill separatamente, annotando qualità, latenza e I/O.
- Mantenere un rollback finché la pre-release non supera il carico reale.