
L’ANALISI
K2 Horizon 7B: pesi scaricabili, 512K di contesto e costi reali da verificare
Il modello denso da 7B arriva con pesi, codice e ricette di serving. La novità pratica è il download completo; il contesto massimo e i benchmark restano da misurare sul proprio hardware.
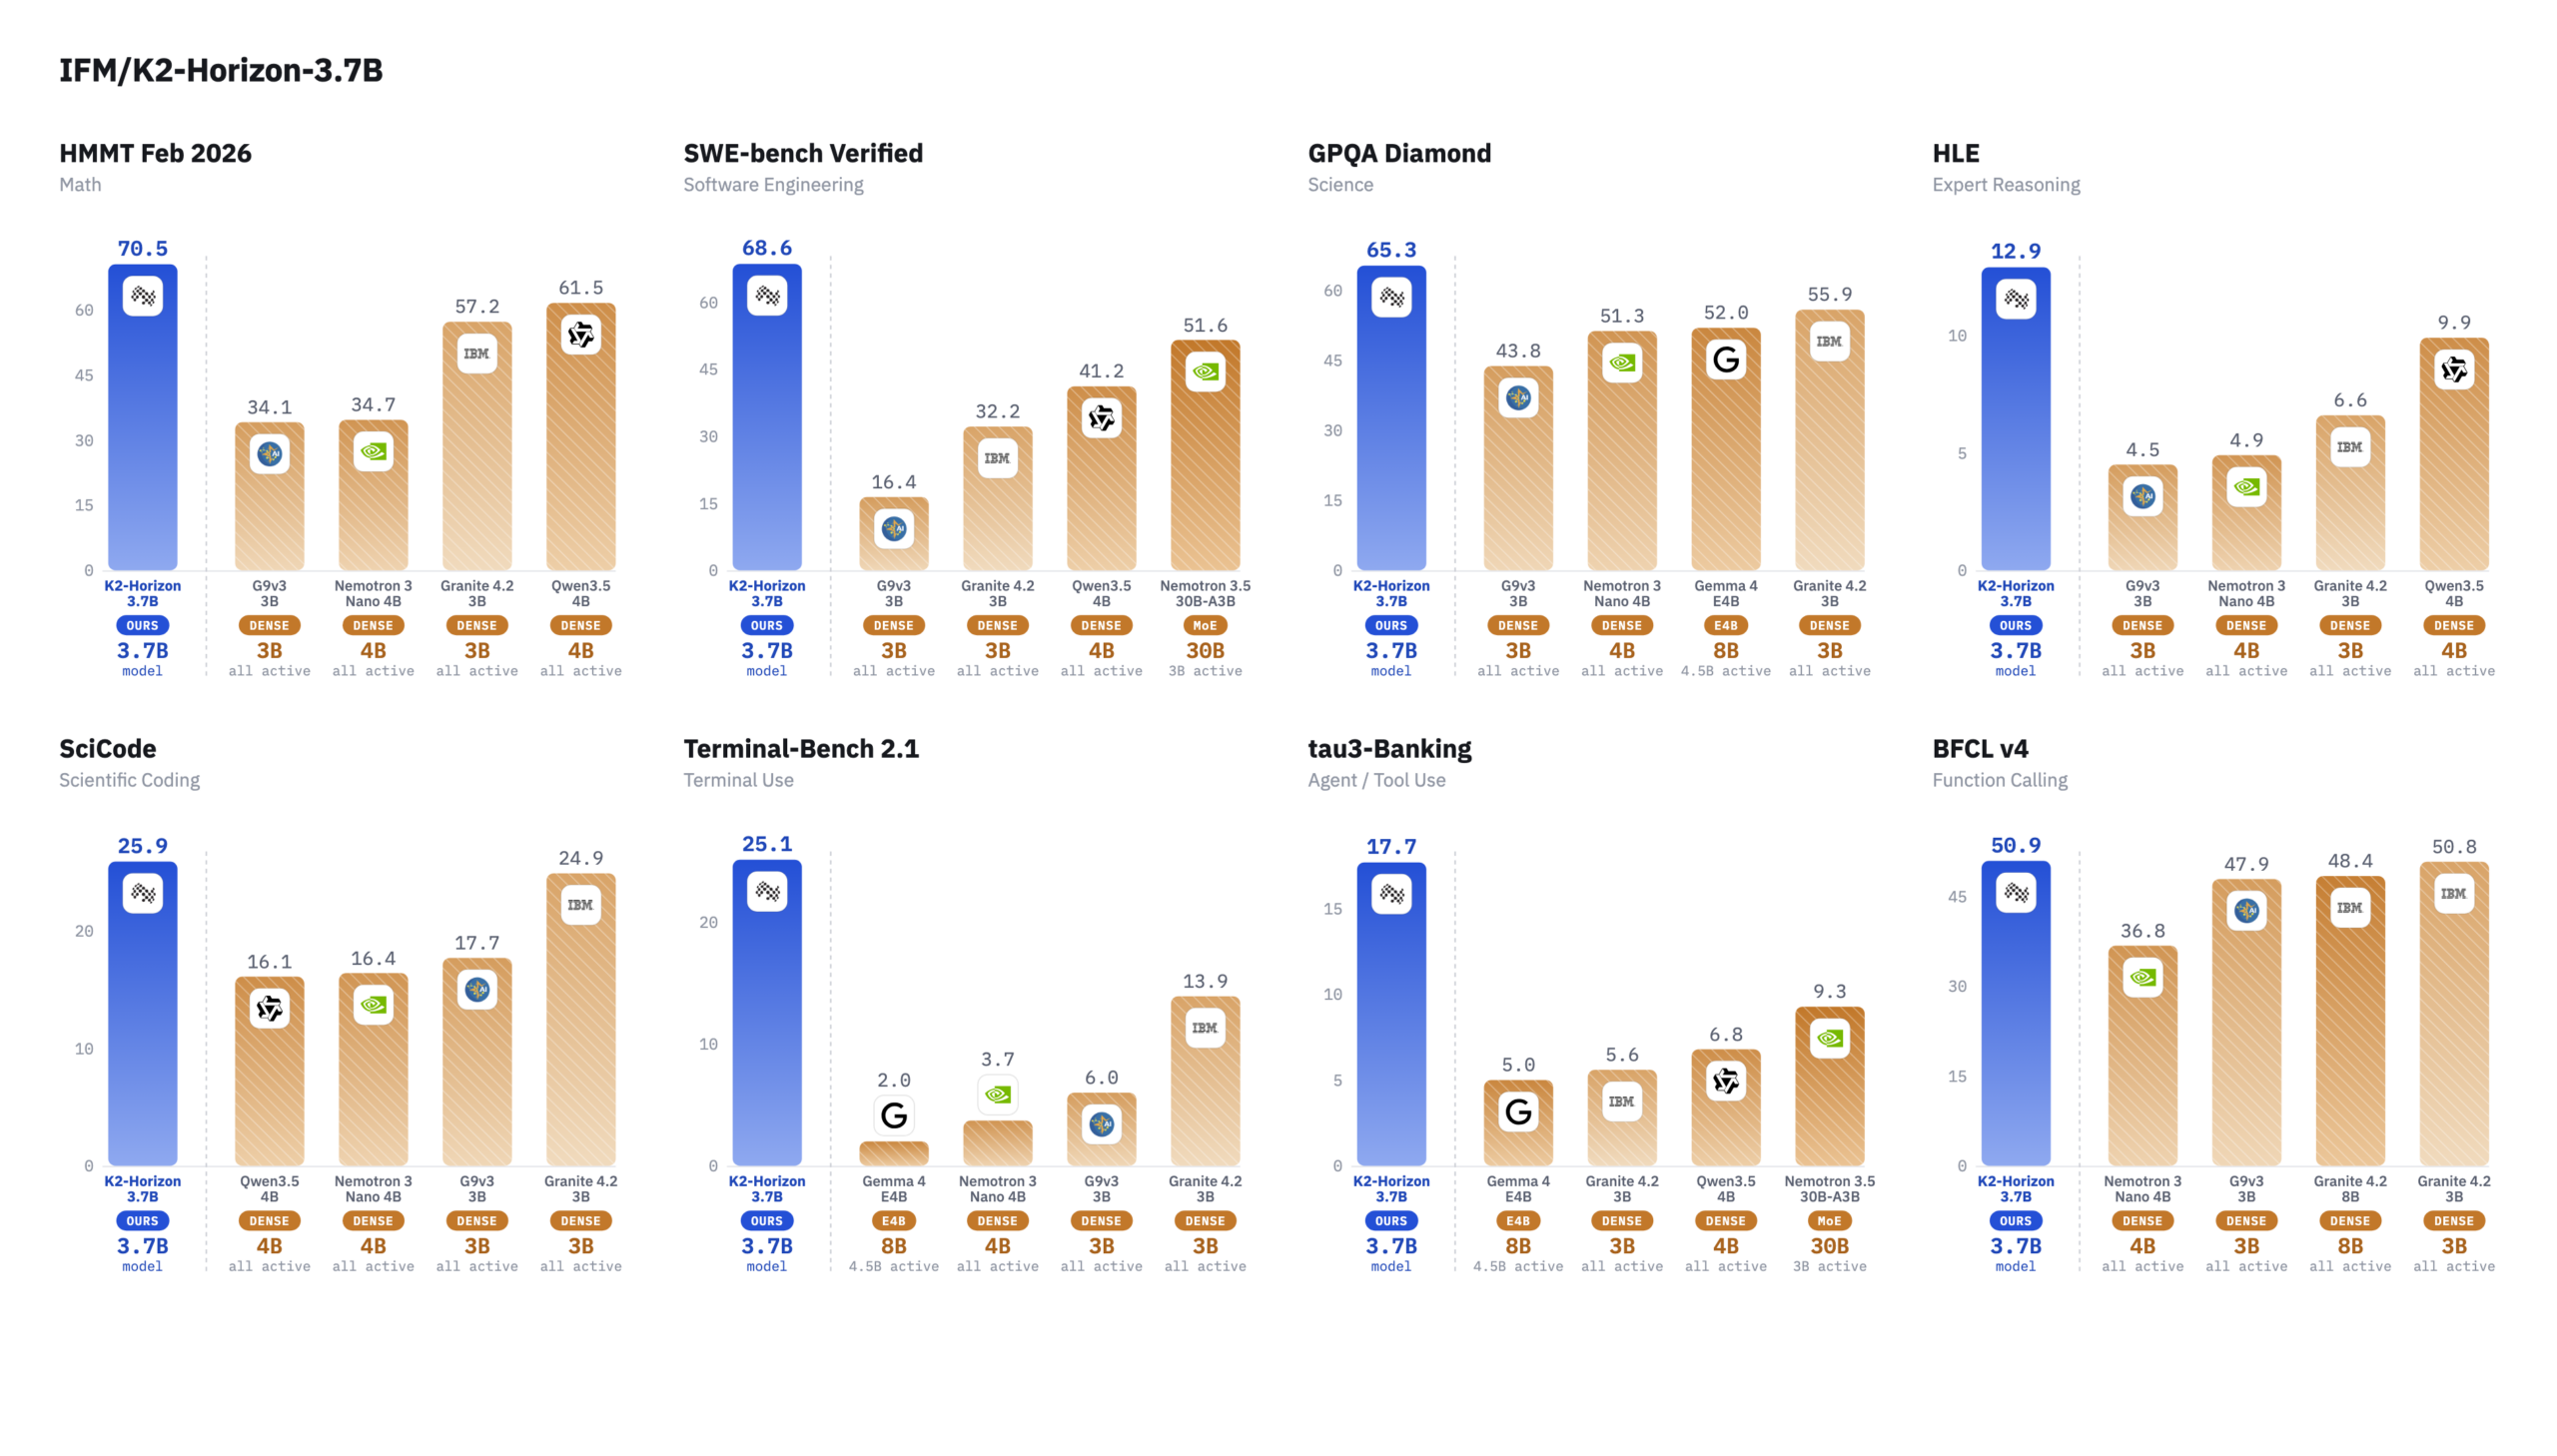
In breve: K2 Horizon 7B è ora un artefatto eseguibile, non solo una promessa: il repository include tutti i 36 shard safetensors, codice personalizzato e ricette di serving. Prima di adottarlo bisogna misurare memoria, velocità e qualità alle lunghezze realmente sostenibili.
Che cosa è diventato disponibile
Il delta verificato sul Hub è la pubblicazione del repository completo del modello 7B: pesi safetensors, indice, tokenizer, template chat, codice di configurazione e implementazione. Questo cambia ciò che uno sviluppatore può scaricare e provare oggi.
512K nativi non significano 512K economici
La model card dichiara 524.288 token nativi dalla fase di midtraining. Le ricette pubblicate per vLLM e SGLang impostano però 131.072 token: il limite teorico va separato dalla lunghezza sostenibile con memoria, latenza e accuratezza accettabili.
Serving e confine di fiducia
La ricetta vLLM usa trust_remote_code e parser specifici per reasoning e tool calling. Questo facilita l’avvio, ma esegue codice del repository: conviene fissare una revisione, ispezionare i file Python e isolare il processo prima di collegare strumenti reali.
Come leggere i benchmark
IFM riporta risultati su matematica, SWE-bench Verified, HLE, SciCode, long-context, Terminal-Bench, tau3-Banking e BrowseComp. I protocolli non sono uniformi: la stessa card segnala per BrowseComp un metodo di gestione del contesto che può differire dai confronti.
Condizioni e limitazioni
La licenza dichiarata è Apache 2.0 e la card propone output di ragionamento molto lunghi. Restano da verificare occupazione VRAM, supporto effettivo dei backend, robustezza delle chiamate agli strumenti e qualità oltre 128K sul proprio corpus.
Checklist pratica
- Fissare lo SHA del repository e revisionare il codice remoto prima dell’esecuzione.
- Partire da 8K, 32K e 128K token, registrando VRAM, token al secondo e latenza al primo token.
- Confrontare risposte corte e lunghe su documenti con soluzione nota, non solo needle-in-a-haystack.
- Testare chiamate agli strumenti con argomenti errati, timeout e conferme prima di azioni sensibili.
- Confrontare il modello base con una quantizzazione solo dopo aver misurato la baseline BF16.
- Conservare prompt, revisione, configurazione e risultati per rendere il benchmark ripetibile.