
IL PUNTO SULL’AI
16 settembre 2026
K2 Horizon aggiorna pesi e checkpoint, llama.cpp amplia sicurezza e inferenza locale, mentre Google Home espone controllo e telemetria domestica agli agenti via MCP.
In questa edizione 8 notizie
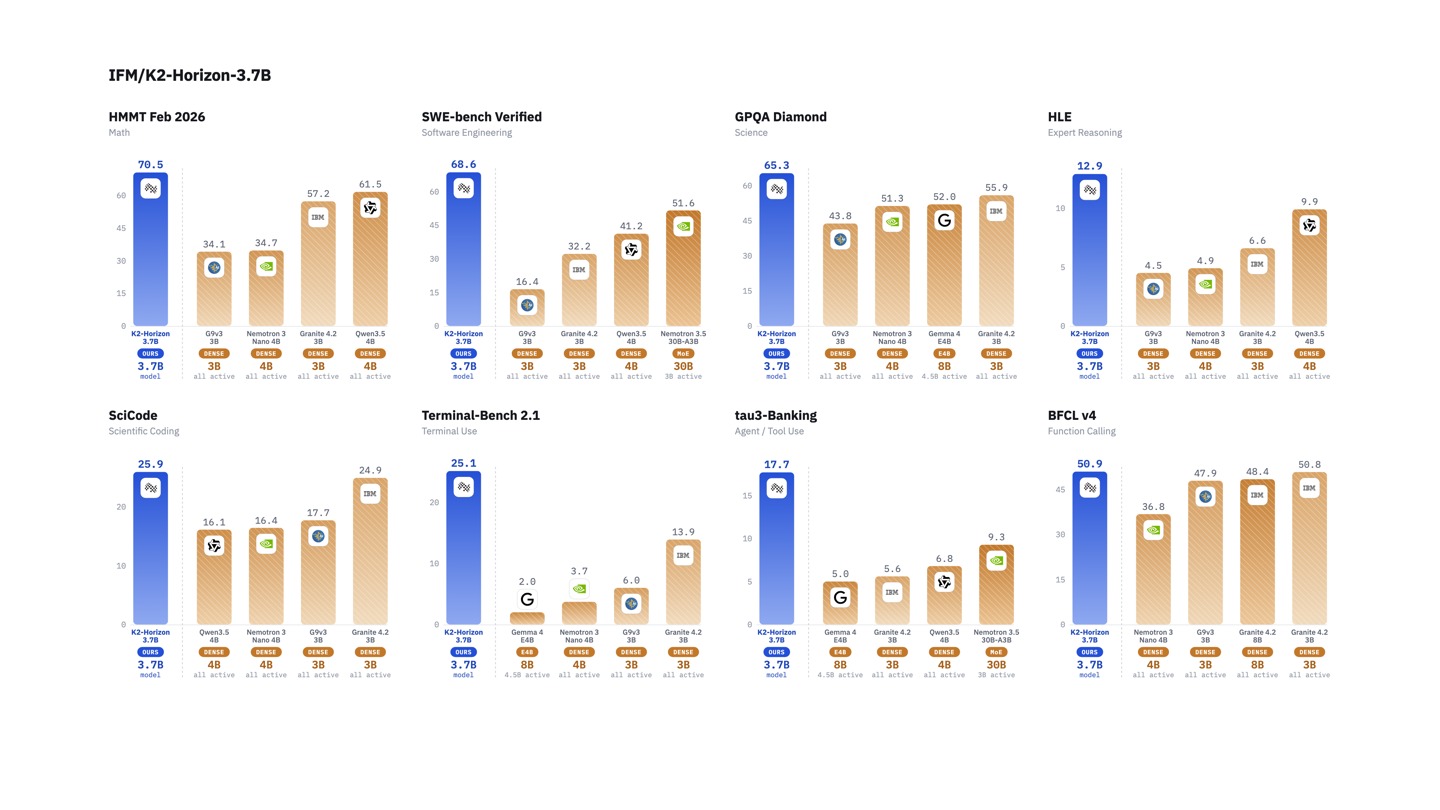
Il repository 32B ora espone 64 shard del checkpoint Stage 1 e l’inventario completo delle fasi di training. Il 3.7B pubblica 36 shard, codice remoto, tokenizer e checkpoint intermedi: due rilasci utilizzabili, non semplici model card.
Limiti da conoscere
Limite: il 32B è ancora Stage 1 e richiede due H200 nella ricetta SGLang validata; il 3.7B richiede trust_remote_code e output di ragionamento molto lunghi. I benchmark restano del produttore.
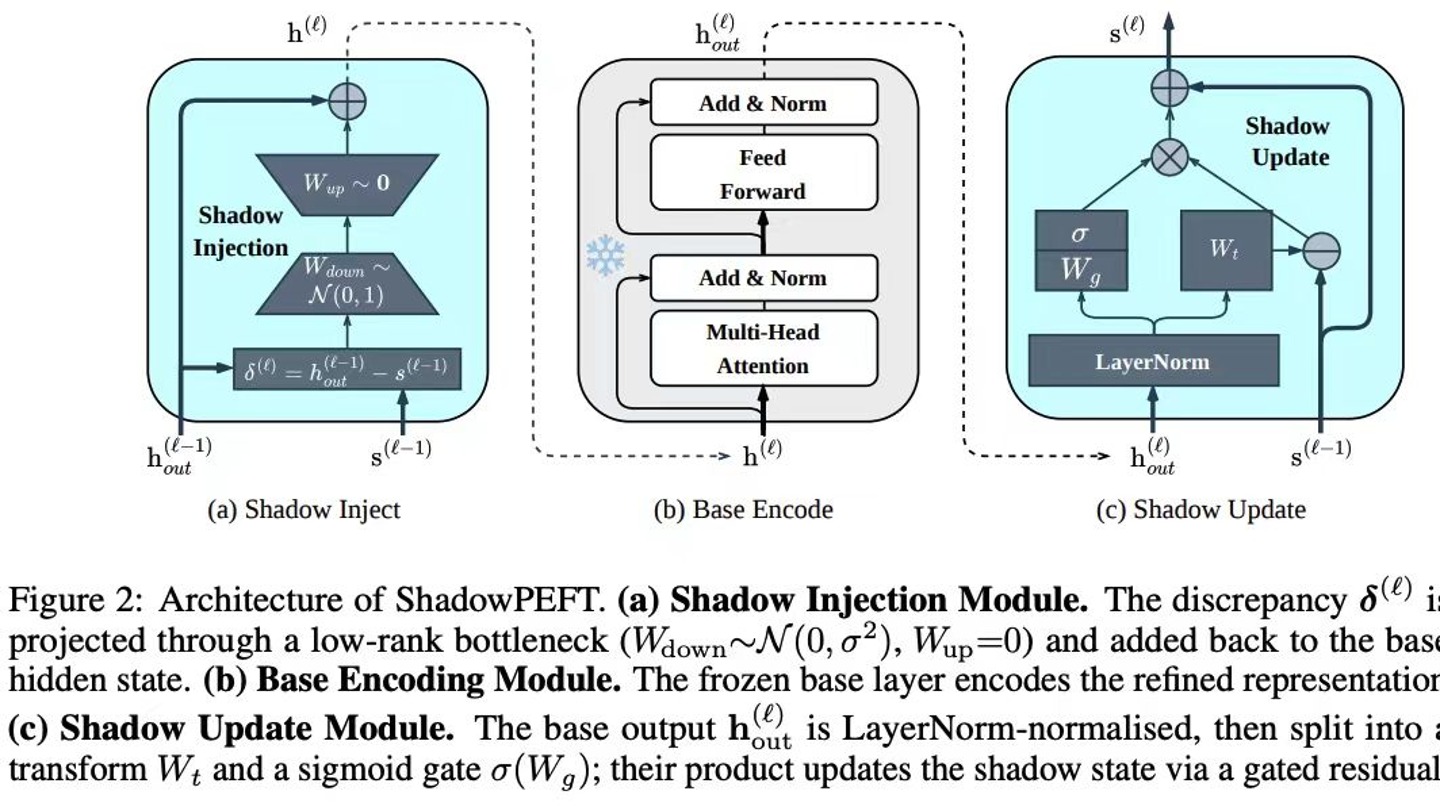
Il metodo è stato integrato nel ramo main di PEFT e usa la stessa interfaccia get_peft_model degli adapter esistenti. La differenza è una rete ombra addestrabile che conserva stato tra i layer e può anche eseguire inferenza separata dal backbone.
Limiti da conoscere
Limite: non è ancora in una release stabile di PEFT e i confronti con LoRA e DoRA provengono dagli autori. Per provarlo oggi serve installare il ramo di sviluppo e validare memoria, velocità e qualità sul proprio task.
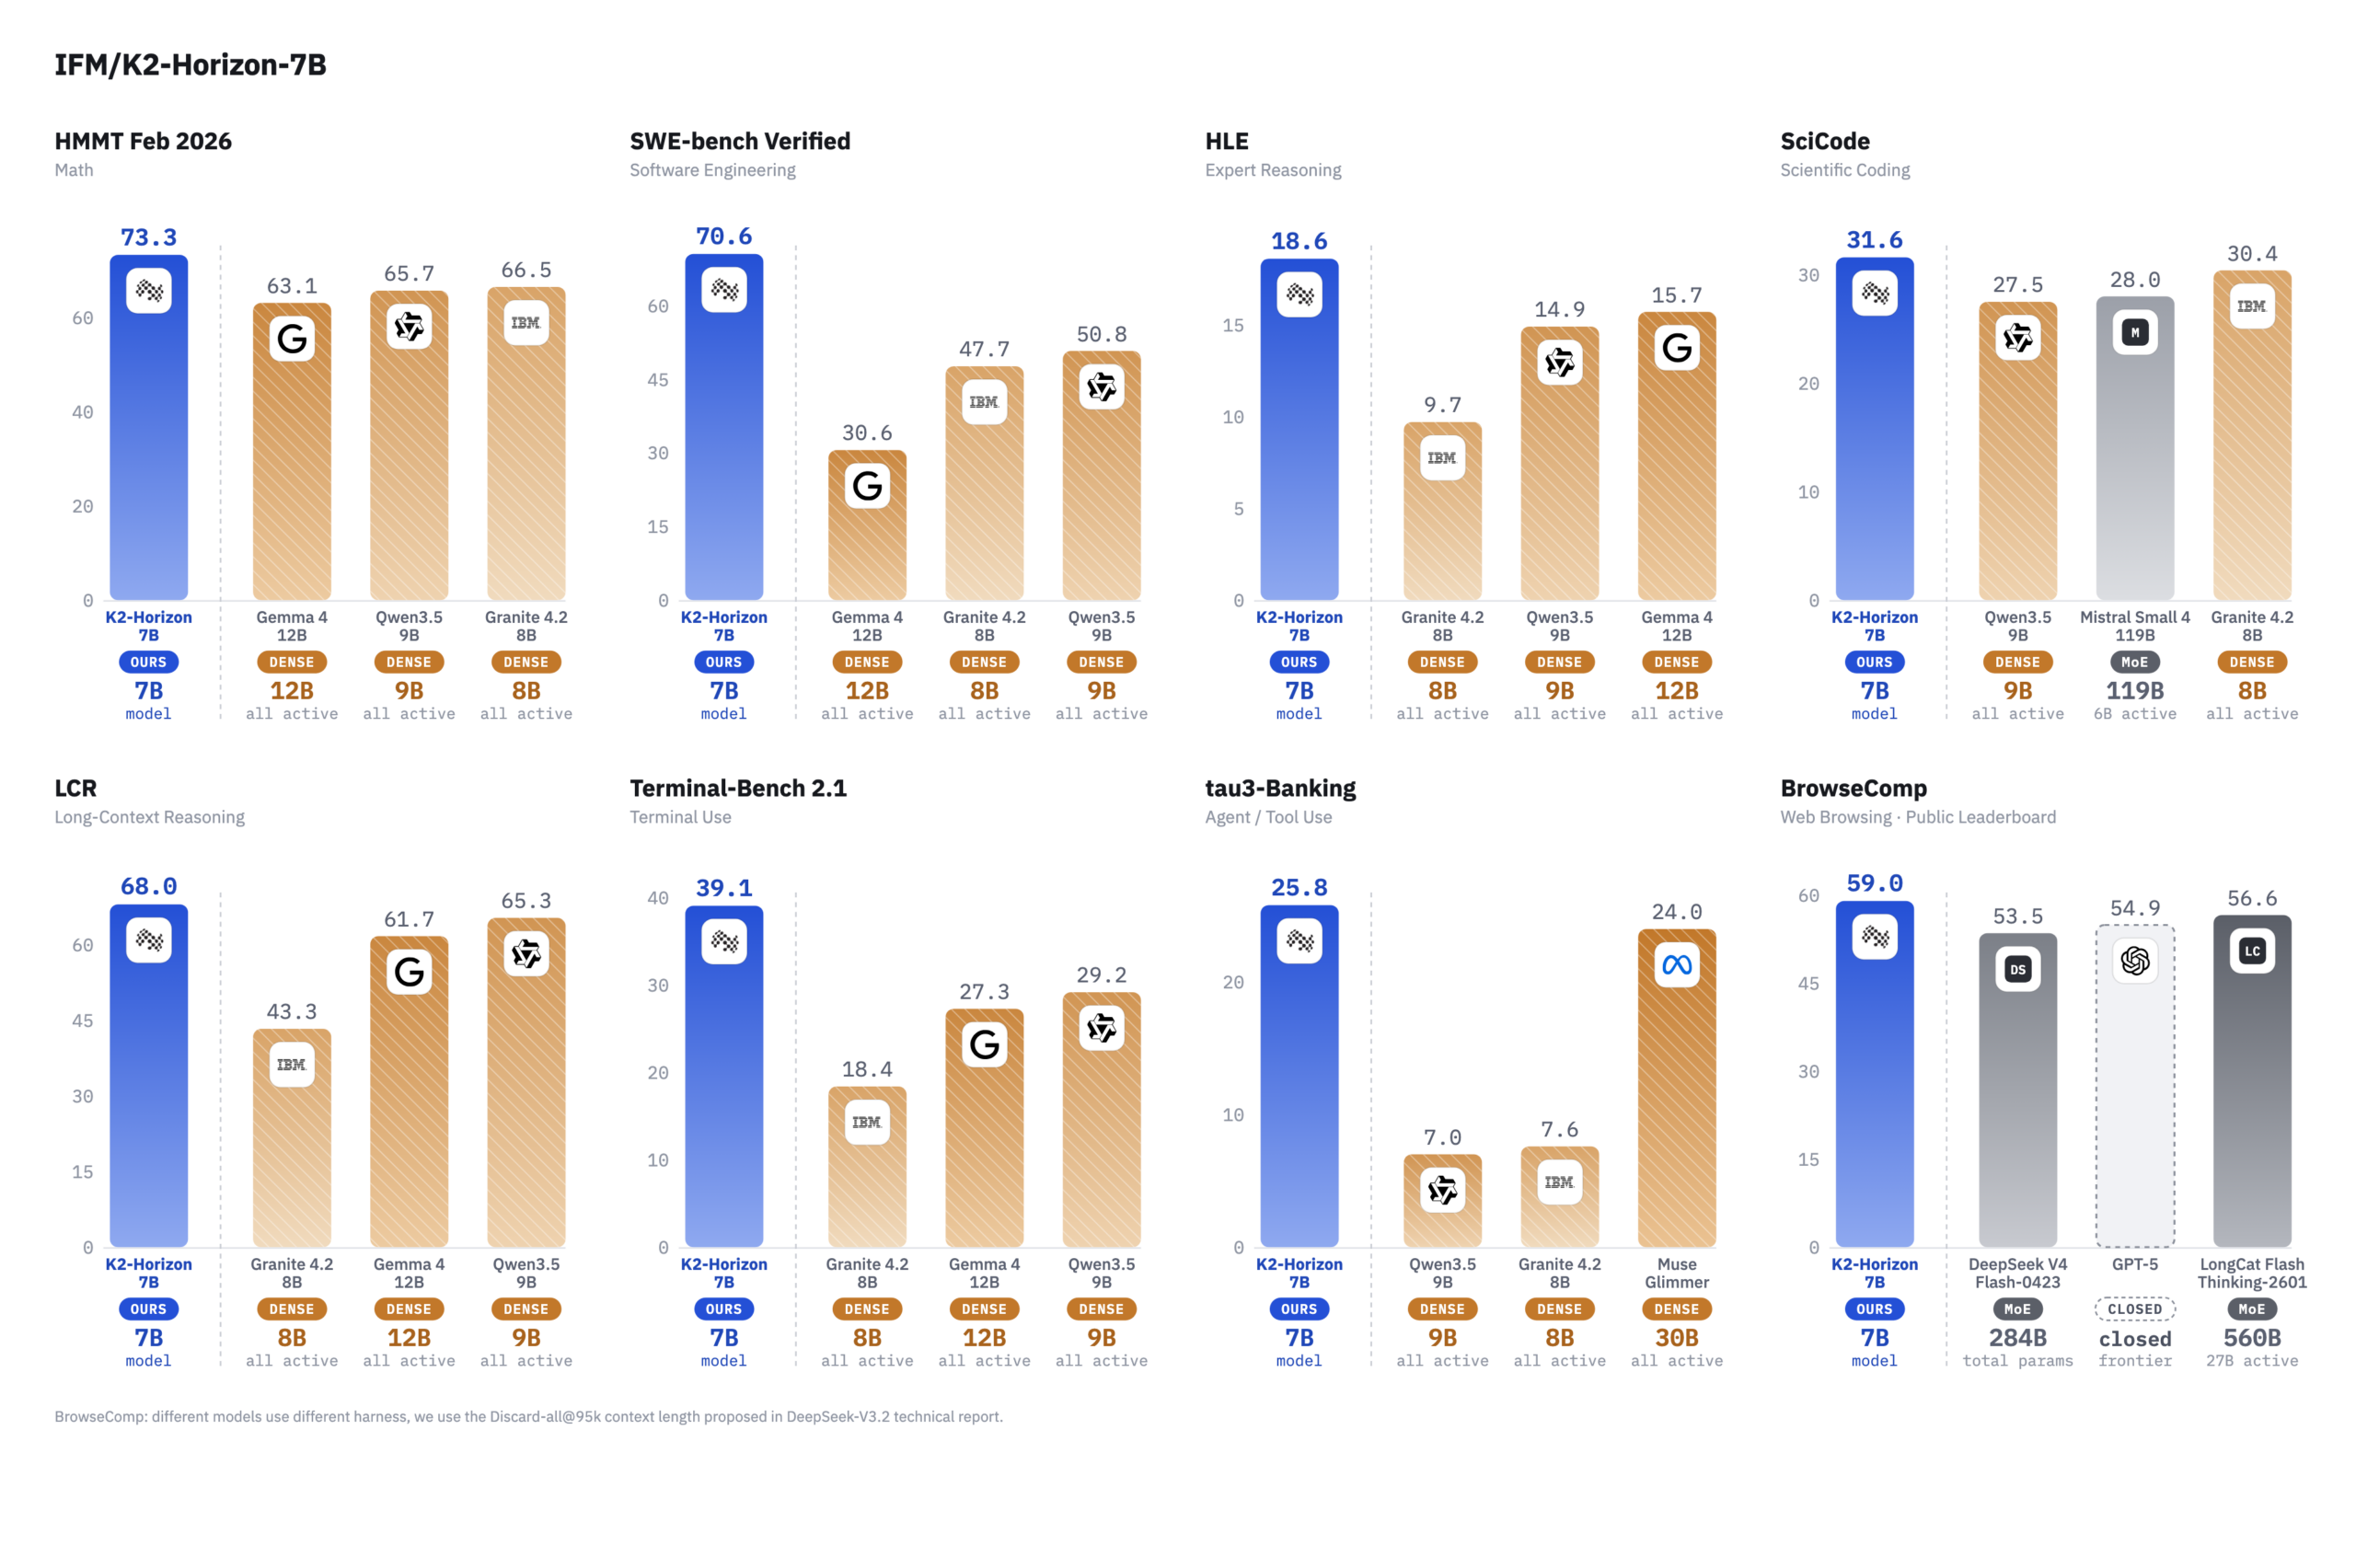
I due repository contengono ora pesi safetensors FP8: un file per il 7B e due shard per il 32B. IFM dichiara quantizzazione statica dei pesi per blocchi 128×128 e attivazioni dinamiche per gruppi 1×128, con minore memoria e accelerazione sull’hardware compatibile.
Limiti da conoscere
Limite: le misure di qualità sono del produttore e le ricette rapide nelle schede puntano ancora ai repository BF16. Il 32B è inoltre uno Stage 1, non il checkpoint finale.
Exein annuncia un round da 270 milioni di dollari a una valutazione di 1,7 miliardi. Oltre all’espansione in USA e APAC, dichiara di addestrare un foundation model proprietario su telemetria macchina, con architettura agentica prevista entro fine 2026 e primi modelli nel primo trimestre 2027.
Limiti da conoscere
Limite: il modello non è ancora disponibile e non esistono benchmark pubblici. Volumi di attacchi, scala della telemetria ed efficacia futura sono dichiarazioni dell’azienda, non misure indipendenti.
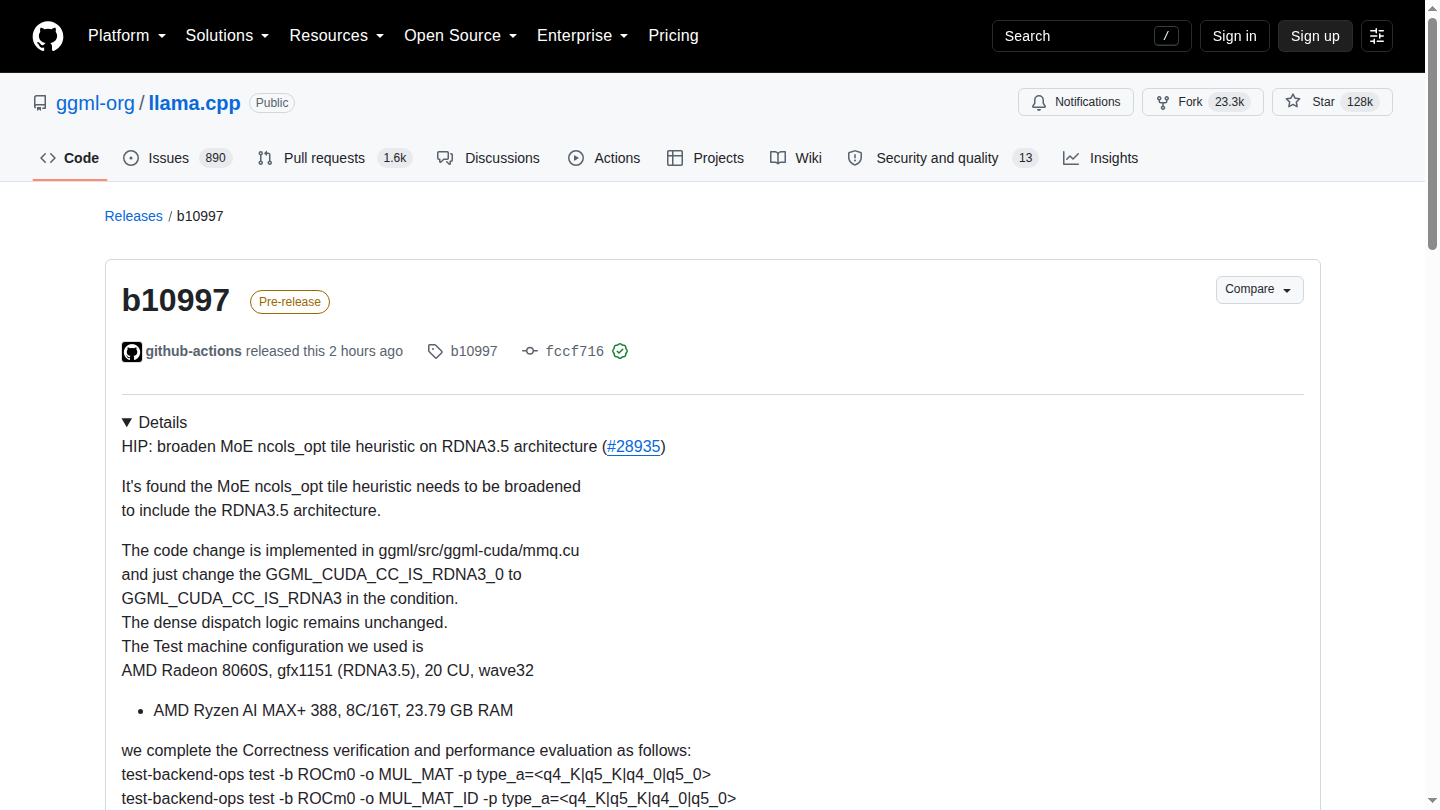
La pre-release b10997 amplia l’euristica ncols_opt del backend HIP alle GPU RDNA 3.5. Sulla Radeon 8060S, il contributore misura guadagni medi dichiarati dell’11,1% su 16 coppie di test MoE, con picchi del 16,2% su LFM2.5-8B-A1B Q4_K_M.
Limiti da conoscere
Limite: sono benchmark del contributore su una sola Radeon 8060S e build specifiche. Il percorso dense non cambia e il vantaggio non è dimostrato su altri modelli, quantizzazioni o carichi.
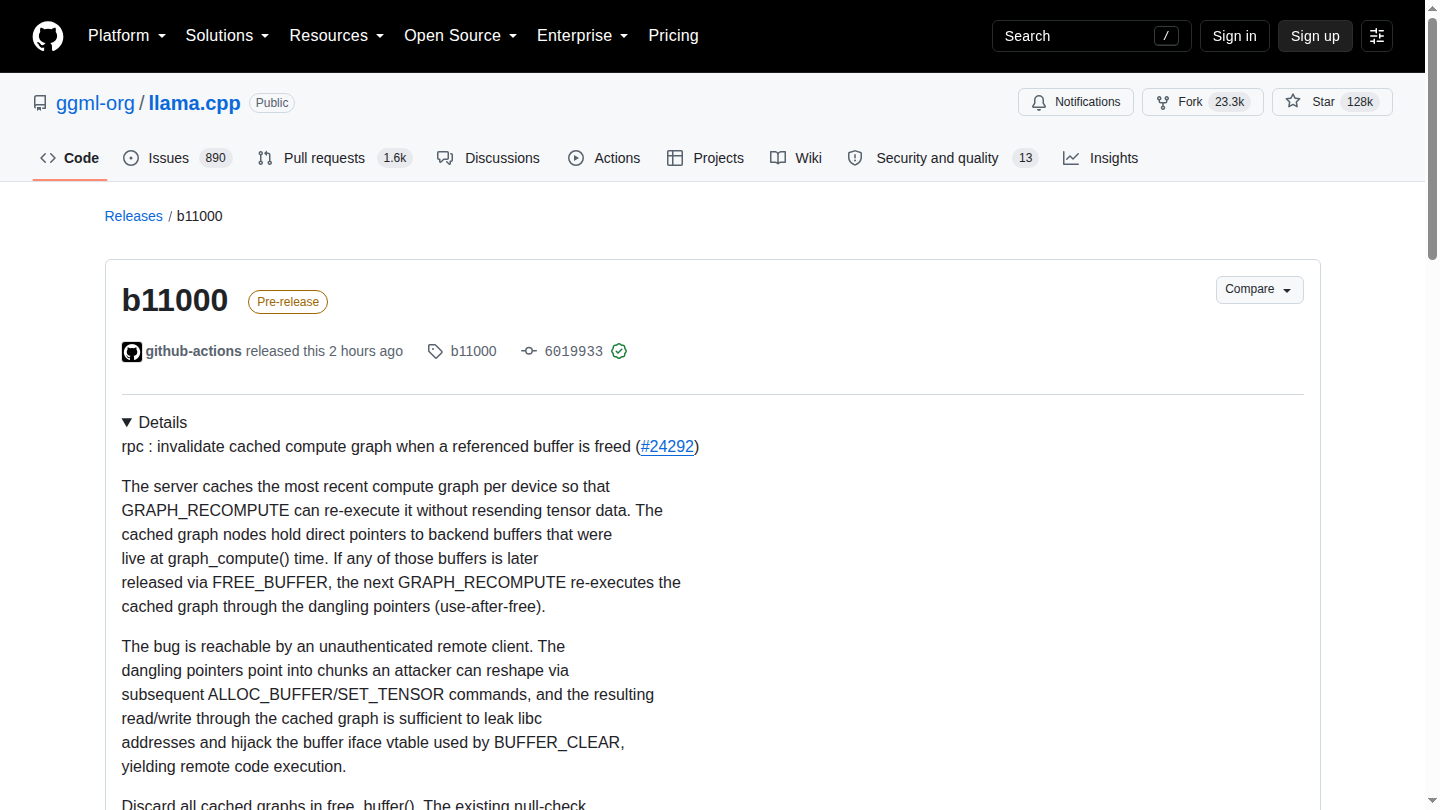
La pre-release b11000 corregge nel server RPC un use-after-free: un client remoto non autenticato poteva liberare un buffer ancora referenziato dal grafo in cache e riusare i puntatori pendenti. Il progetto afferma che il percorso consentiva perdita di indirizzi e remote code execution.
Limiti da conoscere
Limite: la release non indica CVE, CVSS, intervallo completo delle versioni vulnerabili o sfruttamento osservato. Il rischio riguarda il backend RPC esposto a client non fidati, non ogni uso locale di llama.cpp.
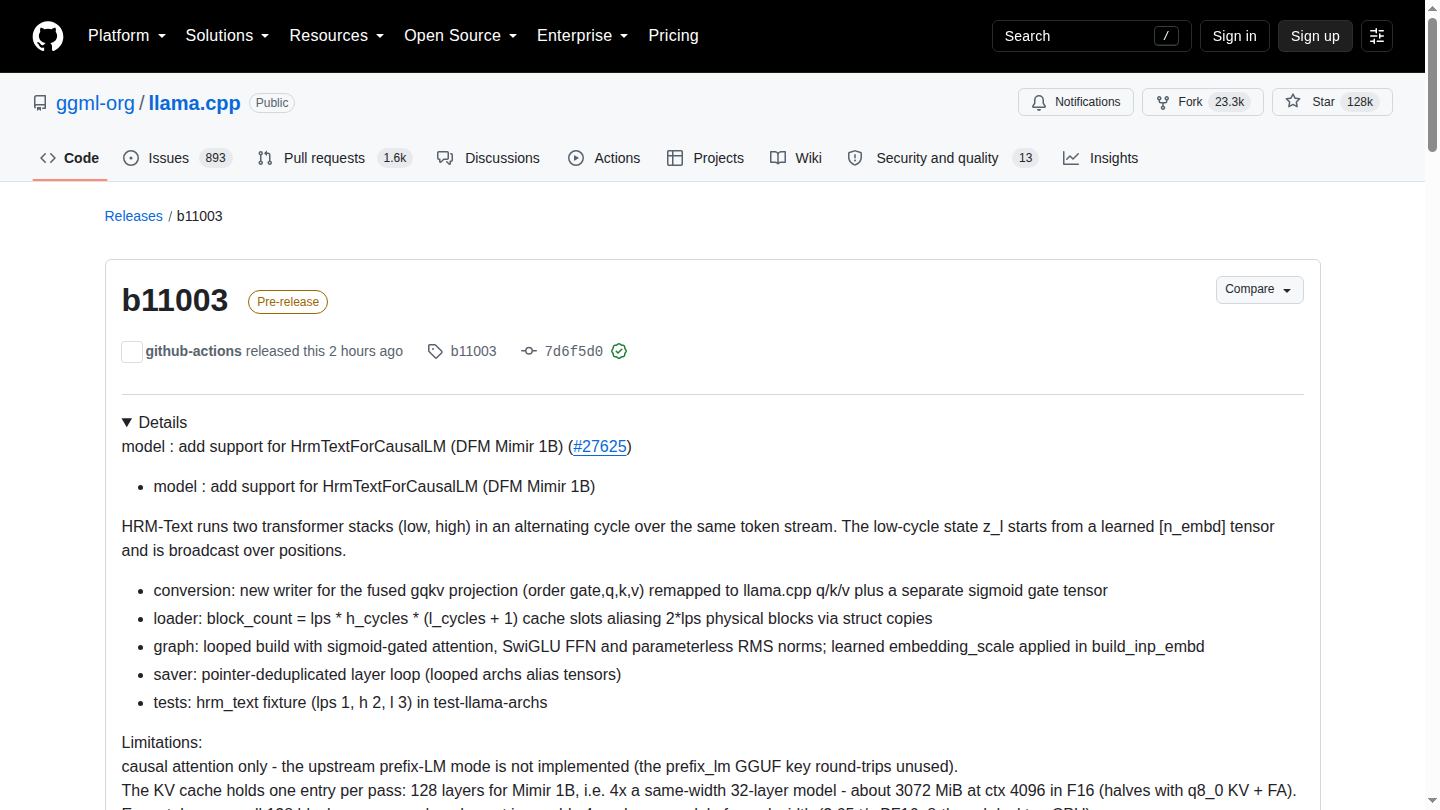
llama.cpp può ora convertire e avviare Mimir 1B in GGUF. Il test upstream riporta argmax identico in 334 posizioni su 334 tra GGUF BF16 e riferimento FP32, mentre la quantizzazione Q8_0 conserva il primo risultato nel 95,8% dei casi del test dichiarato.
Limiti da conoscere
Limite: il port implementa soltanto attenzione causale, non la modalità prefix-LM con cui Mimir è stato addestrato. Il maintainer segnala circa 3 GiB di KV cache a contesto 4096 in F16 e 2,65 token/s su CPU desktop a 8 thread: è supporto sperimentale, non equivalenza prestazionale col riferimento.
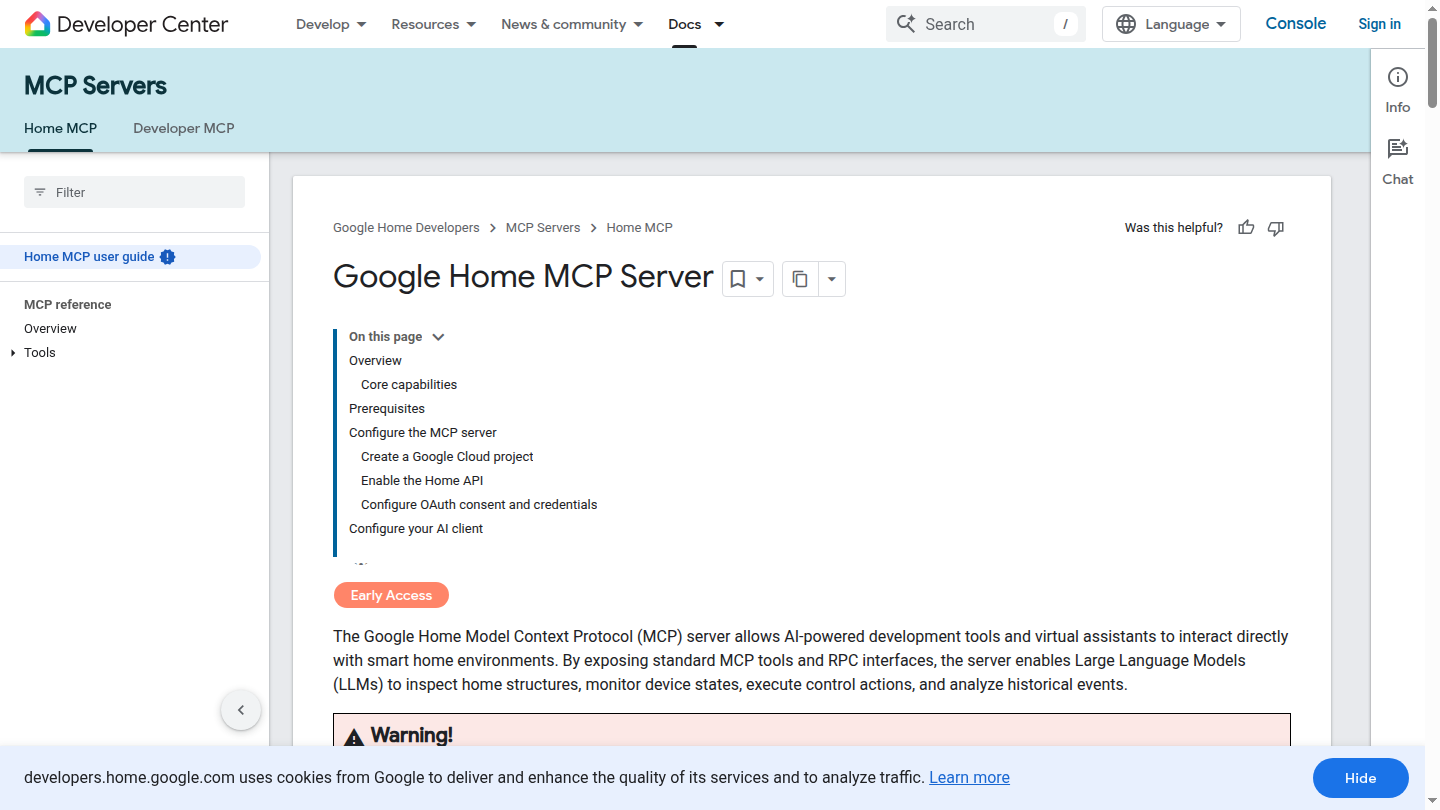
Google Home MCP Server collega client compatibili come Claude Cowork, Antigravity e OpenClaw alla casa con OAuth. Gli agenti possono elencare abitazioni e risorse, leggere stati ed eventi passati ed eseguire azioni parametrizzate sui dispositivi.
Limiti da conoscere
Limite: l’accesso è Early Access, richiede un progetto Google Cloud e un abbonamento Google Home Premium Advanced. La creazione e gestione delle automazioni non è ancora supportata; autorizzazioni e comandi vanno trattati come accesso operativo alla casa.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.