
L’ANALISI
llama.cpp b10982: sparse Flash Attention arriva su Vulkan
Il backend Vulkan aggiunge sparse Flash Attention per DSV4 e GLM, ma prestazioni e contesto lungo restano da misurare.
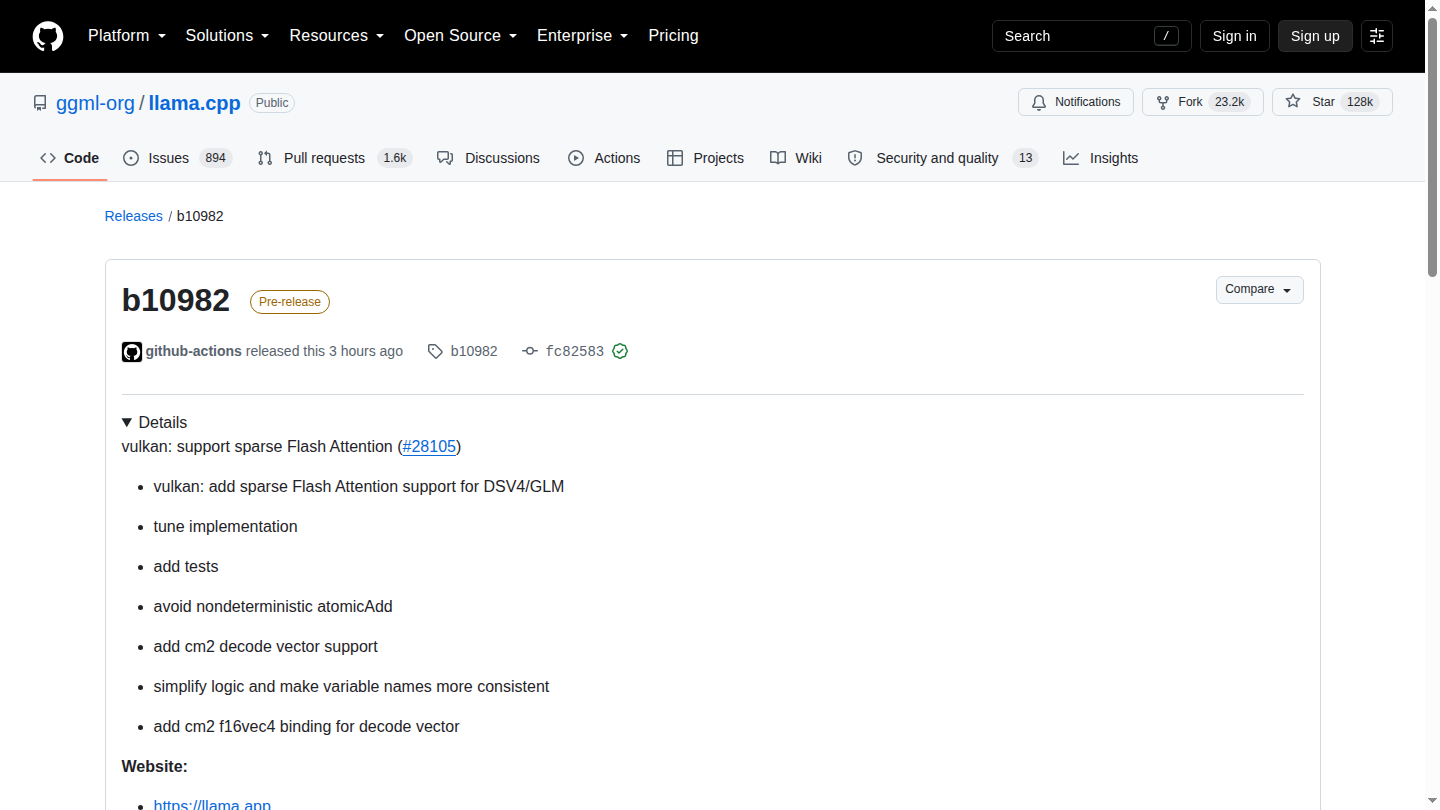
In breve: b10982 rende disponibile sparse Flash Attention nel backend Vulkan per DSV4 e GLM. È un delta eseguibile e scaricabile, ma bisogna confrontare output, token al secondo, latenza e memoria con la build precedente.
Che cosa è stato aggiunto
Il merge implementa sparse Flash Attention nel backend Vulkan per DSV4 e GLM, con tuning, test, decode vettoriale cm2 e rimozione di un atomicAdd non deterministico.
Perché conta su hardware locale
Vulkan è un percorso multipiattaforma usato anche da GPU AMD. Il supporto cambia ciò che si può eseguire senza CUDA, ma il vantaggio dipende da GPU, driver, modello, quantizzazione e contesto.
Il punto aperto sul contesto lungo
Un tester su Strix Halo ha segnalato perdita intermittente della cronologia a 20-30 mila token. L’autore non ha riprodotto il problema dopo un aggiornamento: non prova un difetto finale, ma richiede una verifica esplicita.
Prestazioni: cosa manca
La release non pubblica una tabella comparabile di velocità, latenza o memoria. Serve alternare build precedente e b10982 con lo stesso GGUF, parametri e prompt, dopo warm-up.
Condizioni e limitazioni
b10982 è una pre-release. Il supporto è dichiarato per DSV4 e GLM, non per ogni architettura; un risultato su una GPU Vulkan non si trasferisce automaticamente a un’altra.
Checklist pratica
- Registrare GPU, driver Vulkan, sistema operativo e modello esatto.
- Conservare la build precedente e usare lo stesso GGUF e gli stessi parametri.
- Provare prompt brevi e una sequenza da almeno 20 mila token con domande di richiamo.
- Misurare prompt processing, token al secondo, memoria e correttezza per almeno cinque run dopo warm-up.
- Confrontare mediana e dispersione, non il singolo risultato migliore.
- Mantenere un rollback finché la pre-release non supera il carico reale.