Gemini 3.8 Flash prova a portare prestazioni da modello di fascia alta dentro un listino Flash. Il risultato più interessante non è però il numero più grande nella tabella di Google: è il rapporto tra qualità, velocità e costo per attività completa. Ed è proprio lì che emergono sia il vantaggio sia il limite.
Ho confrontato annuncio e model card di Google con le prime misure indipendenti di Artificial Analysis. Non è un mio benchmark: dove i numeri provengono dal produttore lo indico esplicitamente.
La release è stata selezionata nel Radar AI del 2 settembre 2026; qui la approfondisco con dati tecnici, prezzi e confronti.
Che cos’è Gemini 3.8 Flash
È il successore di Gemini 3.7 Flash, pensato per coding, agenti e flussi di conoscenza complessi. Accetta testo, immagini, audio e video, mantiene una finestra di contesto fino a 1 milione di token e genera testo fino a 64K token. Il livello di effort è regolabile: più ragionamento può migliorare il risultato, ma può anche aumentare token e tempo.
Il confronto che conta: 3.7 Flash, Fable 5.1 e GPT-5.6
Google dichiara un salto netto sul lavoro agentico e sul software engineering rispetto a 3.7 Flash. Su DeepSWE v1.1 il modello si avvicina ai modelli più costosi; il grafico seguente è materiale ufficiale Google e va letto come risultato del vendor, non come verifica indipendente.
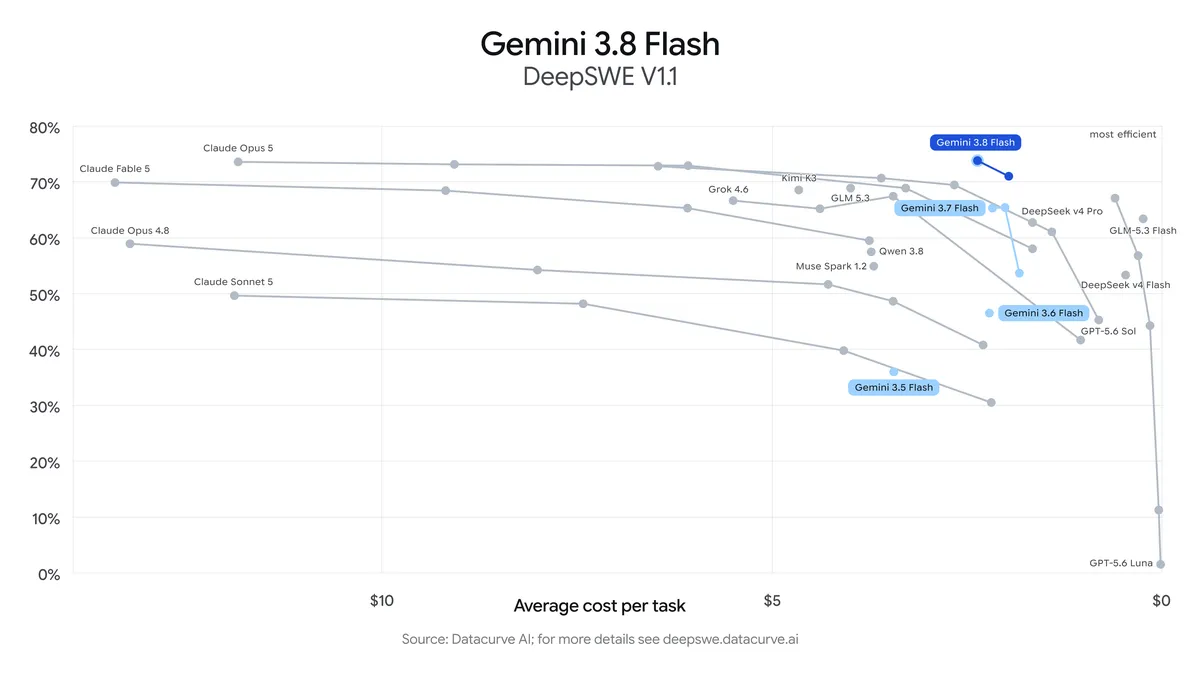
La prima misura indipendente di Artificial Analysis assegna a 3.8 Flash con reasoning alto 59 punti, tre più di 3.7 Flash. Il costo medio per task misurato sale però da circa $0,40 a $0,58: il prezzo per token non cambia, ma il modello usa circa il 30% di token di output in più e più turni agentici. Produce circa 300 token al secondo, ma il tempo medio per attività sale da 2,2 a 2,5 minuti. Fable 5.1 resta più forte nell’indice complessivo e più rapido su quel campione a effort medio; Gemini conserva un vantaggio di costo molto ampio. GPT-5.6 Sol raggiunge livelli simili o superiori a effort elevato, ma appartiene a una fascia di prezzo diversa.
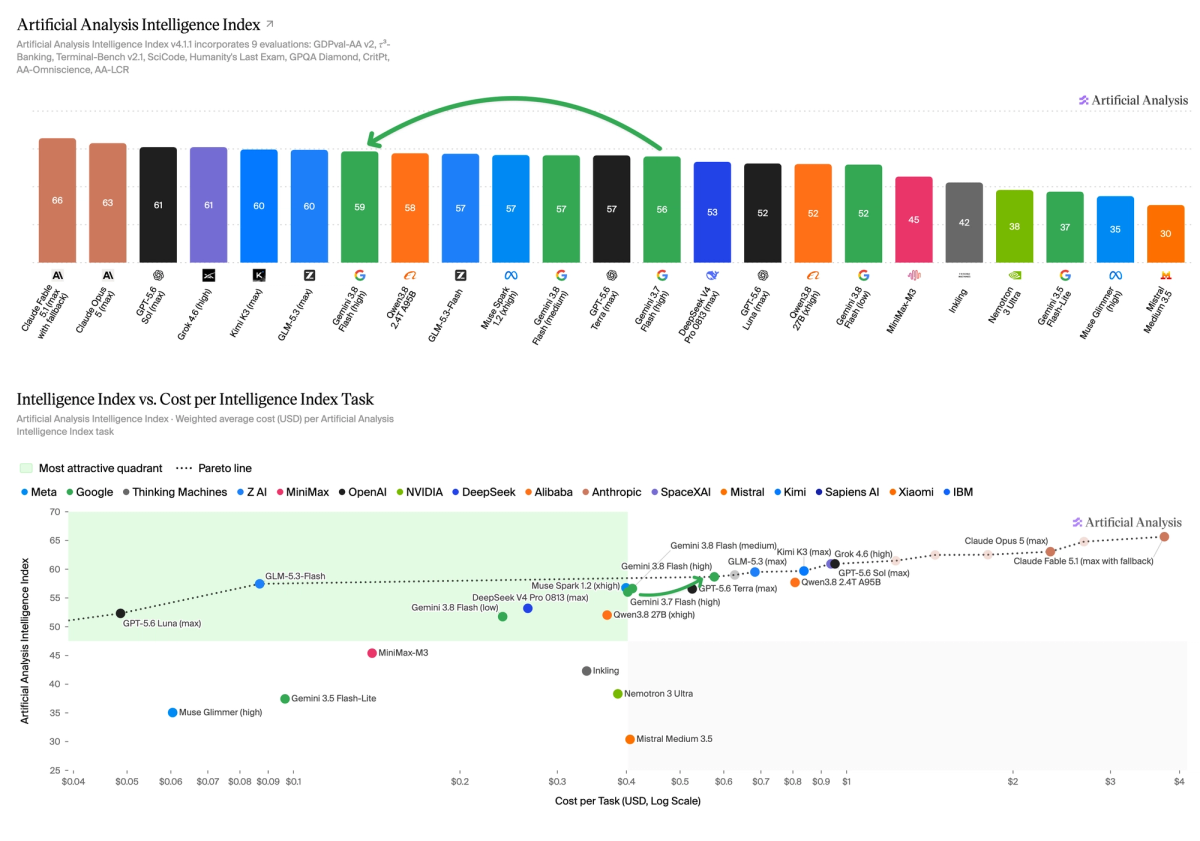
Il punto pratico: economico per token non significa sempre economico per task
Se il modello “lavora più a lungo”, il costo finale dipende da turni, tool call, retry e output prodotti. Per un agente in produzione misurerei quindi: task completati, costo per task riuscito, tempo totale, numero di interventi umani e regressioni. Usare solo il listino premia il modello sbagliato.
Video reale: Gemini 3.8 Flash Cyber in azione
Flash Cyber non è il modello API aperto a tutti
Google ha presentato anche Gemini 3.8 Flash Cyber, con protezioni più permissive per il lavoro difensivo. L’accesso passa dal programma Fairwind ed è riservato a difensori verificati: non basta cambiare il model ID nella normale API.
Su CWE-Bench Google riporta un Pass@1 del 47,2%, vicino al 47,8% del modello leader ma a costo inferiore. È un benchmark esterno, ma questa specifica esecuzione è riportata dal produttore. Google dichiara inoltre oltre il 70% in un proprio test interno su 20 linguaggi: dato utile, non indipendente.
Limiti che non metterei in nota a piè di pagina
- Il modello può allucinare e può mostrare rallentamenti o timeout.
- La model card segnala una lieve regressione nella sicurezza in alcune lingue non inglesi rispetto a 3.7 Flash.
- Le prestazioni salgono aumentando l’effort, ma anche consumo e latenza possono salire.
- I benchmark Google non sostituiscono un confronto sul proprio repository, con lo stesso harness e gli stessi permessi.
- Flash Cyber è gated; i controlli di rete, credenziali e approvazione delle patch devono restare esterni al modello.
Come lo proverei prima di migrare
- Congelare 20-30 task reali e i criteri di successo.
- Eseguire 3.7 Flash e 3.8 Flash agli stessi livelli di effort.
- Confrontare almeno un modello di fascia alta, come Fable 5.1 o GPT-5.6 Sol, sui casi difficili.
- Misurare costo e tempo per task riuscito, non per singola chiamata.
- Separare coding, tool use, documenti lunghi e input video.
- Testare prompt injection, permessi e rollback prima dell’autonomia.
Il mio verdetto iniziale
Gemini 3.8 Flash è interessante quando servono molti agenti veloci e il costo dei frontier model è difficile da sostenere. Non lo leggerei come “prestazioni top a un decimo del prezzo” senza condizioni: nei test indipendenti il maggiore reasoning consuma più token e allunga il task. Il candidato è forte; la decisione deve arrivare dai log del proprio workload.
Domande frequenti
Quanto costa Gemini 3.8 Flash?
Il prezzo introduttivo è $0,75 per milione di token in input e $3,75 in output. Google indica un prezzo standard successivo di $1,50 e $7,50.
È migliore di Gemini 3.7 Flash?
I primi benchmark mostrano progressi, soprattutto negli agenti, ma anche più token e un costo per task più alto ad effort elevato.
Gemini 3.8 Flash Cyber è pubblico?
No: l’accesso è riservato a difensori verificati tramite il programma Fairwind.
Può analizzare video?
Sì. Accetta video in input insieme a testo, immagini e audio; l’output resta testuale.
Fonti e dati
Google - annuncio ufficiale
Release, benchmark dichiarati, disponibilità e media ufficiali.
Apri la fonte ↗Google DeepMind - model card
Specifiche, input e output, limiti, sicurezza e data della conoscenza.
Apri la fonte ↗Artificial Analysis - test indipendente
Intelligence Index, velocità, token prodotti e costo medio per task.
Apri la fonte ↗Vals AI - Finance Agent V2
Benchmark esterno sui flussi agentici in ambito finanziario.
Apri la fonte ↗CWE-Bench - leaderboard
Benchmark esterno sul patching delle vulnerabilità software.
Apri la fonte ↗Aggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.