Un PDF scannerizzato non contiene sempre vero testo. A volte è solo una serie di fotografie: puoi leggerle con gli occhi, ma non puoi cercare una parola, copiare una riga o recuperare un numero. Lo stesso vale per scontrini, etichette, screenshot e foto di documenti.
Qui entra in gioco l’OCR. Detto nel modo più semplice possibile, l’OCR prende le lettere presenti nei pixel e le trasforma in testo copiabile e ricercabile. In questa guida spiego come estrarre testo da PDF e immagini con OCR, quando è davvero necessario e come farlo in locale sul proprio PC.
OCR: cos’è e a cosa serve
OCR significa Optical Character Recognition, cioè riconoscimento ottico dei caratteri. Un software OCR osserva un’immagine, riconosce lettere, parole e numeri e restituisce testo utilizzabile da altri programmi.
Il risultato può essere un semplice file TXT, un documento Markdown, dati strutturati oppure un PDF in cui finalmente è possibile usare la ricerca. Se vuoi convertire un’immagine in testo, questo è il tipo di tecnologia che ti serve.
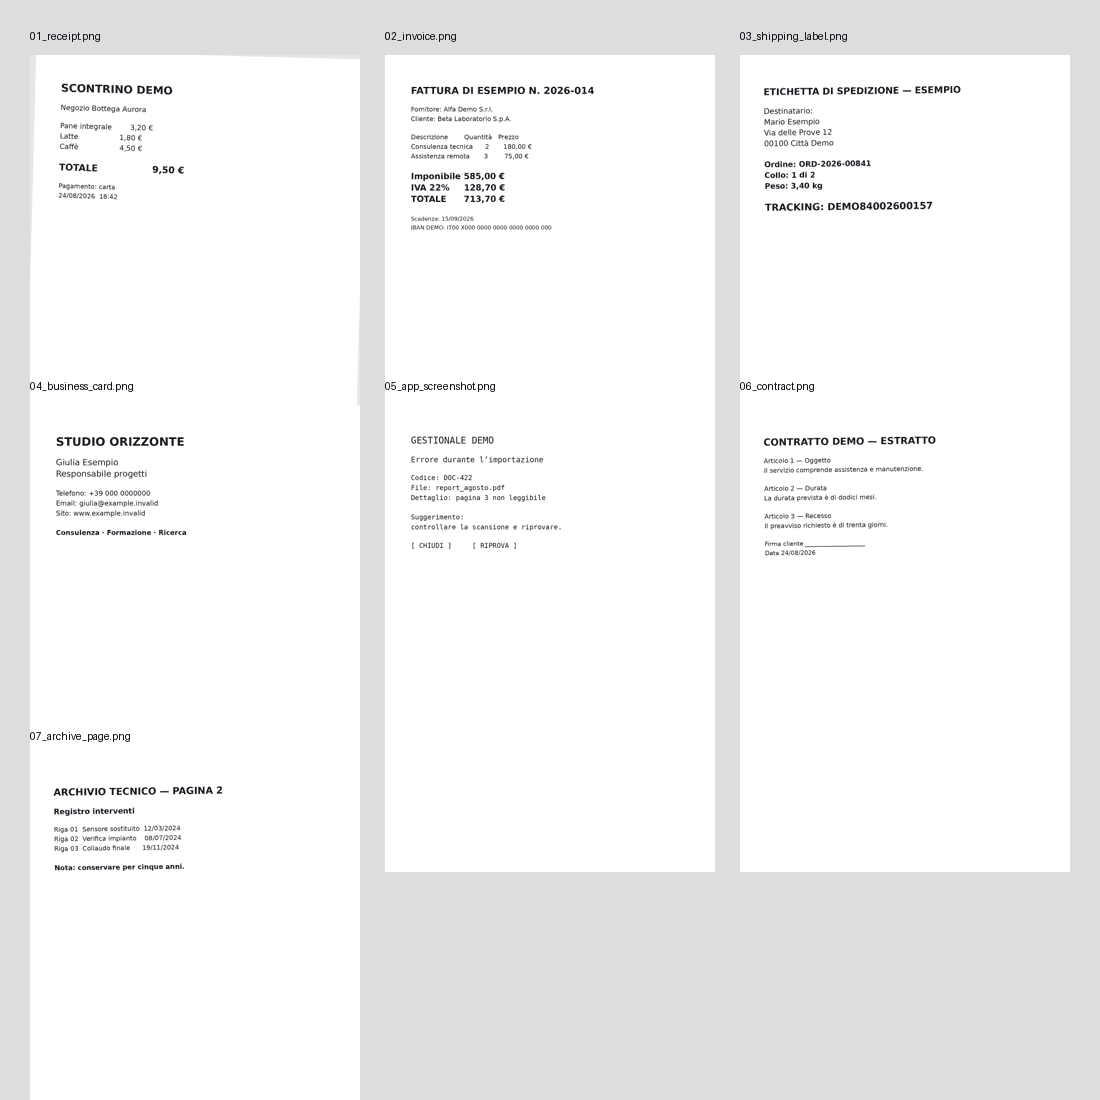
Sette casi d’uso concreti
- Scontrino: recuperare esercente, data, totale e righe di spesa.
- Fattura: estrarre numero, imponibile, IVA e scadenza da una scansione.
- Etichetta di spedizione: leggere destinatario, indirizzo e codice di tracciamento.
- Biglietto da visita: trasformare nome, azienda, email e telefono in un contatto.
- Screenshot di un errore: copiare il messaggio per cercarlo o inserirlo in un ticket.
- Contratto: rendere ricercabili clausole, date e riferimenti in una copia acquisita con scanner.
- Pagina d’archivio: recuperare testo da materiale storico digitalizzato.
Lo stesso flusso funziona anche con un PDF raster di due pagine: prima si trasformano le pagine in immagini, poi si esegue l’OCR su ciascuna pagina e infine si uniscono i risultati mantenendo il riferimento alla pagina di origine.
Ti sta piacendo?
Ricevi una guida pratica ogni settimana. AI, tool e automazioni.
Quando l’OCR non serve
Prima di avviare un modello, prova a selezionare una frase nel documento. Se riesci a copiarla correttamente, probabilmente il testo esiste già e l’OCR aggiungerebbe solo tempo e possibili errori.
- Un PDF nativo, esportato da un programma, va letto con un parser PDF.
- Un file DOCX va aperto come documento strutturato.
- Un file XLSX va letto per fogli, celle e formule.
- Una pagina HTML va analizzata dal suo codice e dalla sua struttura.
La regola pratica è semplice: parsing nativo quando il testo è già presente, OCR solo quando il contenuto utile vive nei pixel. Questo migliora velocità, precisione e tracciabilità.
OCR PDF gratis e online oppure OCR locale?
Un servizio OCR PDF online può essere comodo per una prova rapida e per documenti non riservati. Carichi il file, attendi l’elaborazione e scarichi il testo. Prima di usarlo, però, conviene controllare limiti di dimensione, conservazione dei file, informativa privacy e condizioni del servizio.
Io preferisco l’OCR locale quando devo ripetere il lavoro, automatizzare una cartella o trattare materiale che non voglio inviare a terzi. “Locale” significa che immagini e modelli restano sul computer. Non significa automaticamente che la configurazione sia facile o che ogni documento venga riconosciuto senza errori.
Il mio test: GLM-OCR Q8 e PaddleOCR-VL 1.6 Q8
Ho confrontato i due modelli con lo stesso ambiente: commit di llama.cpp 7bd8282..., backend Vulkan, GPU Radeon 8060S, quantizzazione Q8, stesso prompt OCR, temperatura 0 e top-k 1. Il corpus comprendeva sette immagini sintetiche e pulite: scontrino, fattura, etichetta di spedizione, biglietto da visita, screenshot di errore, contratto e pagina d’archivio.
Ho eseguito ogni immagine due volte con entrambi i modelli: 7 immagini × 2 ripetizioni × 2 modelli = 28 run. Tutte le 28 esecuzioni sono riuscite e, nelle condizioni del test, i risultati sono stati deterministici.
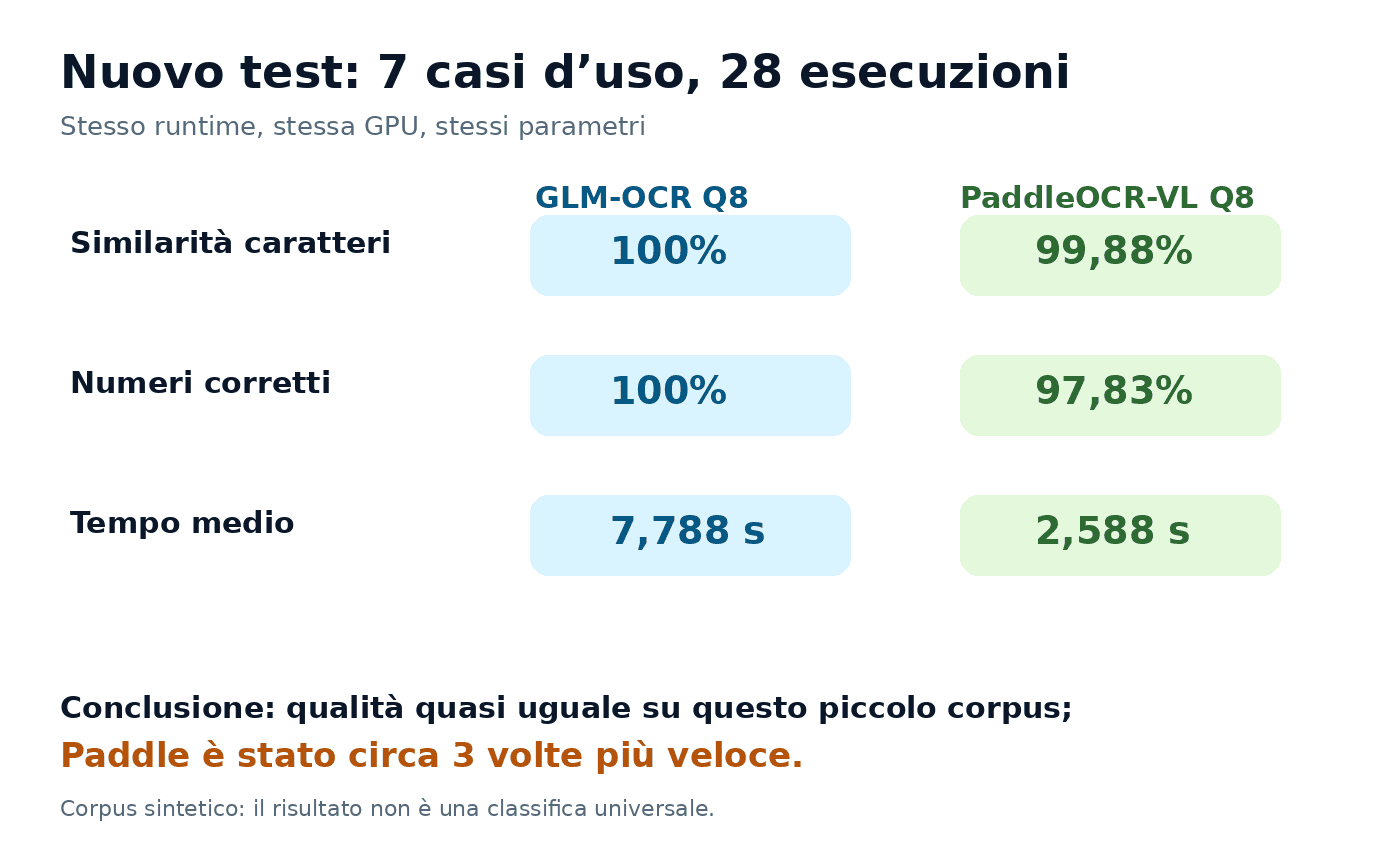
GLM-OCR ha restituito una trascrizione equivalente al riferimento dopo la normalizzazione di markup e spaziatura. PaddleOCR-VL ha commesso qualche imprecisione, ma è stato 3,01 volte più veloce. Il CER è il tasso di errore sui caratteri: più è basso, meglio è.
Attenzione al significato del benchmark. Il corpus è sintetico, volutamente pulito e piccolo. Serve a rendere il confronto ripetibile, non a costruire un ranking universale. Foto storte, ombre, tabelle complesse, scrittura a mano, lingue diverse e scansioni rovinate possono cambiare molto il risultato.
Il test precedente su un corpus più difficile
Conservo anche il risultato delle 36 run precedenti, effettuate su materiale sintetico più difficile. GLM-OCR aveva raggiunto il 91,17% di similarità caratteri, 8,59% di CER e 7,905 secondi medi. PaddleOCR-VL aveva ottenuto il 91,13%, 8,65% di CER e 2,724 secondi medi. In quel test la qualità era sostanzialmente appaiata, mentre Paddle era 2,90 volte più veloce.
Come estrarre testo da un’immagine sul PC
Quella che segue è una traccia pratica, non una promessa di installazione “one-click”. Servono un minimo di familiarità con terminale, percorsi dei file e dipendenze.
- Installa Python 3.11 e crea un ambiente virtuale dedicato.
- Compila o installa una versione recente di llama.cpp con supporto multimodale e il backend adatto al tuo hardware.
- Scarica il modello GGUF e il relativo file mmproj. Sono file separati e servono entrambi.
- Prepara un’immagine leggibile: orientamento corretto, risoluzione sufficiente e poco margine inutile.
- Avvia la CLI indicando modello, proiettore multimodale, immagine e prompt.
- Salva l’output e controlla sempre nomi, date, importi e codici.
llama-mtmd-cli \
  -m /percorso/modello-ocr-q8.gguf \
  --mmproj /percorso/mmproj-ocr.gguf \
  --image /percorso/documento.png \
  -p "Trascrivi fedelmente tutto il testo visibile. Mantieni righe e numeri." \
  --temp 0 --top-k 1
I nomi delle opzioni possono cambiare tra versioni di llama.cpp: verifica sempre la guida del commit che stai usando. Per un PDF scannerizzato, converti prima ogni pagina in immagine, esegui il comando pagina per pagina e conserva nel risultato un marcatore come pagina: 1.
docroute-ocr 0.2: dal file al testo verificabile
Ho trasformato docroute-ocr in una piccola applicazione locale. Riconosce il formato, usa il parser corretto e applica l’OCR soltanto quando il contenuto vive nei pixel. Puoi scaricare docroute-ocr 0.2.0.
- elabora TXT, Markdown, HTML, DOCX, XLSX, immagini e PDF;
- analizza i PDF pagina per pagina e usa l’OCR solo sulle pagine senza testo;
- produce JSON, TXT e Markdown con riferimenti a pagina, foglio, cella o sezione;
- elabora intere cartelle in batch senza mescolare file con nomi simili;
- offre una Web UI locale con caricamento, anteprima, download e cancellazione del workspace;
- crea un indice SQLite locale e risponde recuperando passaggi originali con citazioni verificabili.
La funzione ask è volutamente estrattiva: cerca e restituisce il testo originale con la sua fonte. Non viene presentata come risposta generata da un modello e non è ancora un RAG completo.
./install.sh
.venv/bin/docroute web --host 127.0.0.1 --port 8765

# oppure da terminale
.venv/bin/docroute process documento.pdf --output risultati
SHA-256 del pacchetto:
cf0fb7cfdd4c78fcb6bda061ea83db99be106084354d90efaa34c27338b13b65La release ha superato 23 test automatici, una prova di installazione pulita e una prova PDF reale con Poppler. I modelli OCR non sono inclusi: per immagini e PDF scannerizzati servono ancora un runtime llama.cpp multimodale, il modello GGUF e il relativo mmproj.
Puoi anche scaricare il corpus sintetico completo con immagini, testi attesi e report, oppure provare direttamente il PDF scansionato multipagina di esempio. Tutti i dati sono inventati.
Software OCR open source: come scegliere
Non esiste un motore migliore per ogni situazione. Per scegliere un software OCR open source, prova un campione che assomigli davvero ai tuoi documenti e misura almeno:
- errori su lettere e parole;
- precisione di importi, date, codici e partite IVA;
- tempo medio per pagina;
- memoria richiesta e compatibilità con l’hardware;
- capacità di mantenere righe, tabelle e ordine di lettura;
- licenza del codice e dei pesi del modello.
Per i dati importanti non basta una percentuale media: un totale letto come 1.000 invece di 100 può essere più grave di diversi accenti sbagliati. Conviene aggiungere controlli automatici e revisione umana nei passaggi critici.
Dall’OCR al RAG documentale
L’OCR è solo il primo anello della catena. Dopo l’estrazione vengono normalizzazione, suddivisione in chunk, creazione degli embedding, caricamento in Vespa o in un altro indice e infine una chat che risponde mostrando le citazioni.
In una futura chat per documenti aziendali userò parsing nativo + OCR selettivo, isolamento per workspace, cancellazione controllata e fonti precise a livello di pagina o cella. L’obiettivo non è soltanto “far leggere il file all’AI”, ma poter verificare da dove arriva ogni risposta.
Dedicherò un articolo specifico al RAG documentale e alla chat con i documenti aziendali, mostrando come passare da una scansione a una risposta verificabile con la relativa fonte.
OCR cos’è, in parole semplici?
È una tecnologia che riconosce le lettere dentro un’immagine e le trasforma in testo copiabile e ricercabile.
Come estrarre testo da un PDF scannerizzato?
Converti le pagine del PDF in immagini, applica l’OCR a ogni pagina e unisci il testo mantenendo i numeri di pagina. Se il PDF contiene già testo selezionabile, usa invece un parser PDF.
Come estrarre testo da un’immagine?
Fornisci l’immagine a un motore OCR locale oppure a un servizio online. Raddrizzala, usa una risoluzione leggibile e controlla soprattutto numeri, date e nomi.
Un OCR PDF gratis online è sicuro?
Dipende dal servizio e dal documento. Prima del caricamento verifica privacy, conservazione e luogo di trattamento. Per contenuti riservati è spesso preferibile un flusso locale approvato dalla propria organizzazione.
Qual è il miglior software OCR open source?
Dipende da lingua, impaginazione, qualità delle scansioni e hardware. La scelta corretta nasce da un test sul proprio campione, non da un singolo benchmark.
L’OCR è sempre preciso?
No. Immagini sfocate, rotazioni, ombre, caratteri piccoli e tabelle possono introdurre errori. I campi importanti devono essere validati.
Per verificare definizioni, runtime e modelli ho consultato documentazione e repository ufficiali.
GLM-OCR-GGUF
Pesi GGUF e indicazioni ufficiali per usare GLM-OCR con llama.cpp.
Apri fontellama.cpp
Runtime open source utilizzato per eseguire entrambi i modelli nello stesso ambiente locale.
Apri fonteGLM-OCR
Repository ufficiale del modello, SDK, architettura e licenze dei componenti.
Apri fonteAWS: che cos’è l’OCR
Definizione semplice del riconoscimento ottico dei caratteri e principali applicazioni documentali.
Apri fonteGoogle Cloud: casi d’uso OCR
Esempi di estrazione del testo da immagini e documenti e distinzione fra testo generico e documenti densi.
Apri fonteAggiungi francescogruner.it come fonte preferita
Se leggi spesso i miei articoli su AI, automazione e tecnologia, ora puoi dire a Google che vuoi vedere più spesso i contenuti di francescogruner.it tra le notizie.