
IL PUNTO SULL’AI
8 ottobre 2026
Difesa delle infrastrutture critiche, sicurezza open source, modelli decisionali edge, servizi AI esposti, agenti enterprise e OCR locale strutturato.
In questa edizione 7 notizie
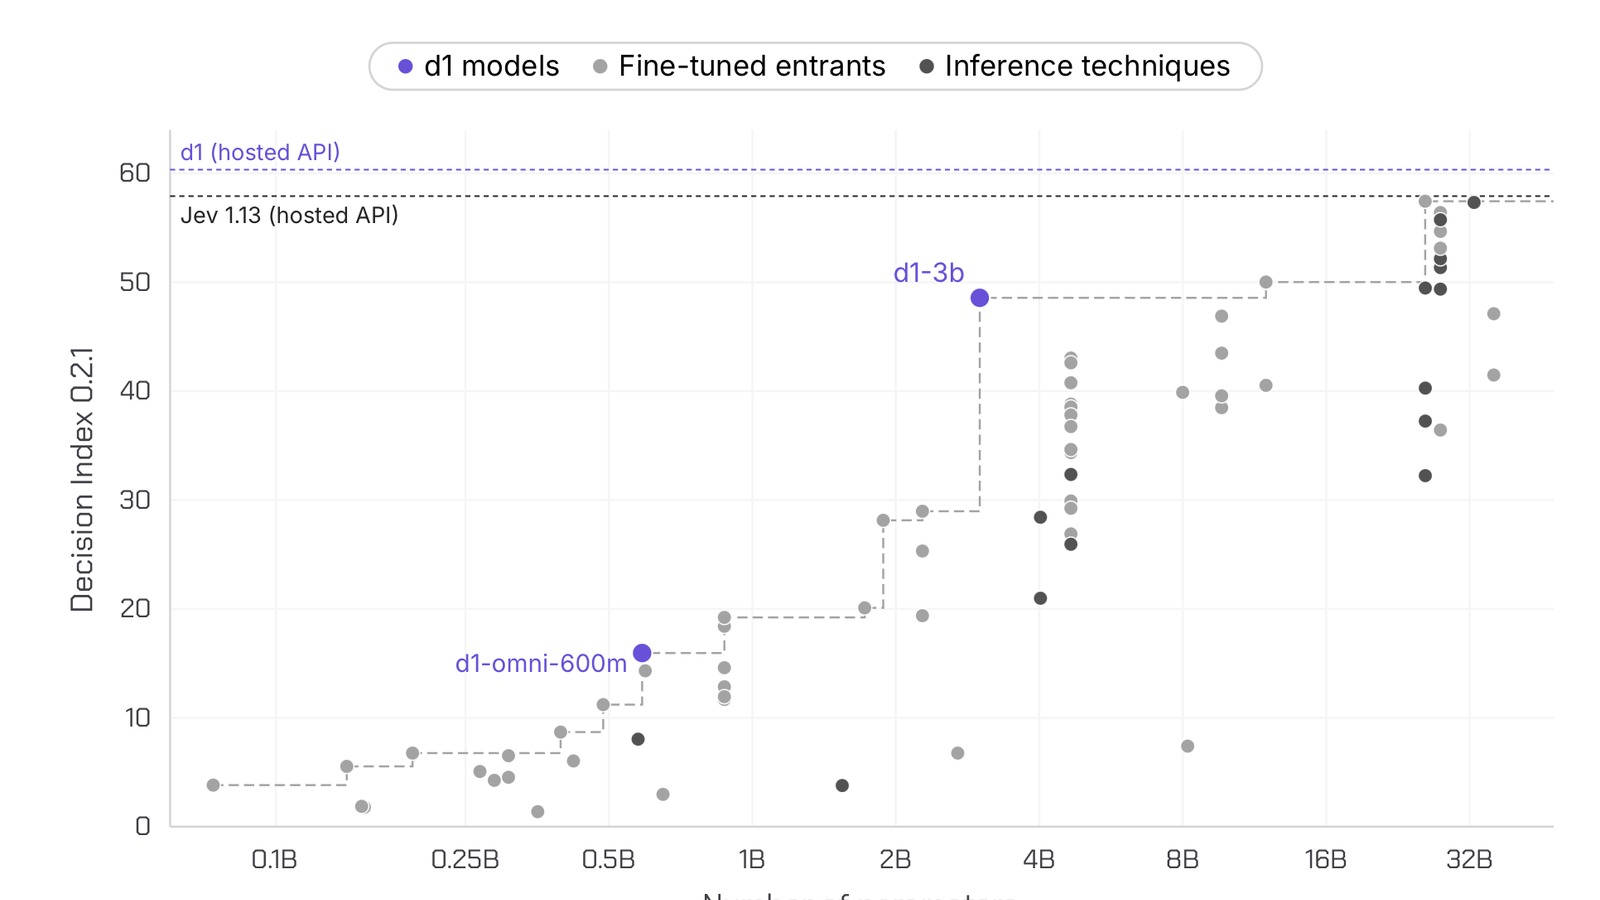
Liquid AI ha pubblicato i pesi di d1-3B e d1-omni-600M. I modelli restituiscono sì/no, scelte e punteggi in un singolo passaggio senza generare testo; d1-3B accetta testo e immagini, mentre la variante sperimentale da 600M aggiunge audio fino a 30 secondi.
Limiti da conoscere
Limite: Prestazioni, latenza e confronti sono misure del produttore, non test indipendenti. I checkpoint eseguono codice remoto con trust_remote_code=True; d1-omni è sperimentale, non ha benchmark di velocità pubblicati e limita l’audio al dominio addestrato e a clip di 30 secondi.
Black Lotus Labs ha documentato PoeLLM, una campagna attiva almeno da aprile che sfrutta servizi AI e open source esposti, installa miner e riusa gli host compromessi per scansione ed exploit. La telemetria Lumen conta oltre 3.400 server colpiti e picchi superiori a 800 sistemi attivi al giorno.
Limiti da conoscere
Limite: I numeri e l’attribuzione derivano dalla telemetria del ricercatore, non da un censimento completo. Ollama è indicato tra i servizi osservati, ma la catena tecnica pubblicata associa l’esecuzione remota confermata soprattutto a LiteLLM CVE-2026-42271; un servizio raggiungibile non prova da solo una compromissione.
Anthropic ha reso disponibile Claude Haiku 5.5 per carichi ad alto volume e sensibili alla latenza. Il modello introduce effort regolabile, un contesto fino a un milione di token e prezzi dichiarati di 0,10 dollari per milione di token in ingresso e 0,50 in uscita fino a 100.000 token.
Limiti da conoscere
Limite: Prezzi, benchmark e riduzione media dei costi sono dichiarazioni del fornitore. Senza test sullo stesso workload non dimostrano che Haiku 5.5 completi un’attività a costo inferiore: errori, ripetizioni, cache, prompt lunghi ed effort possono cambiare il risultato.
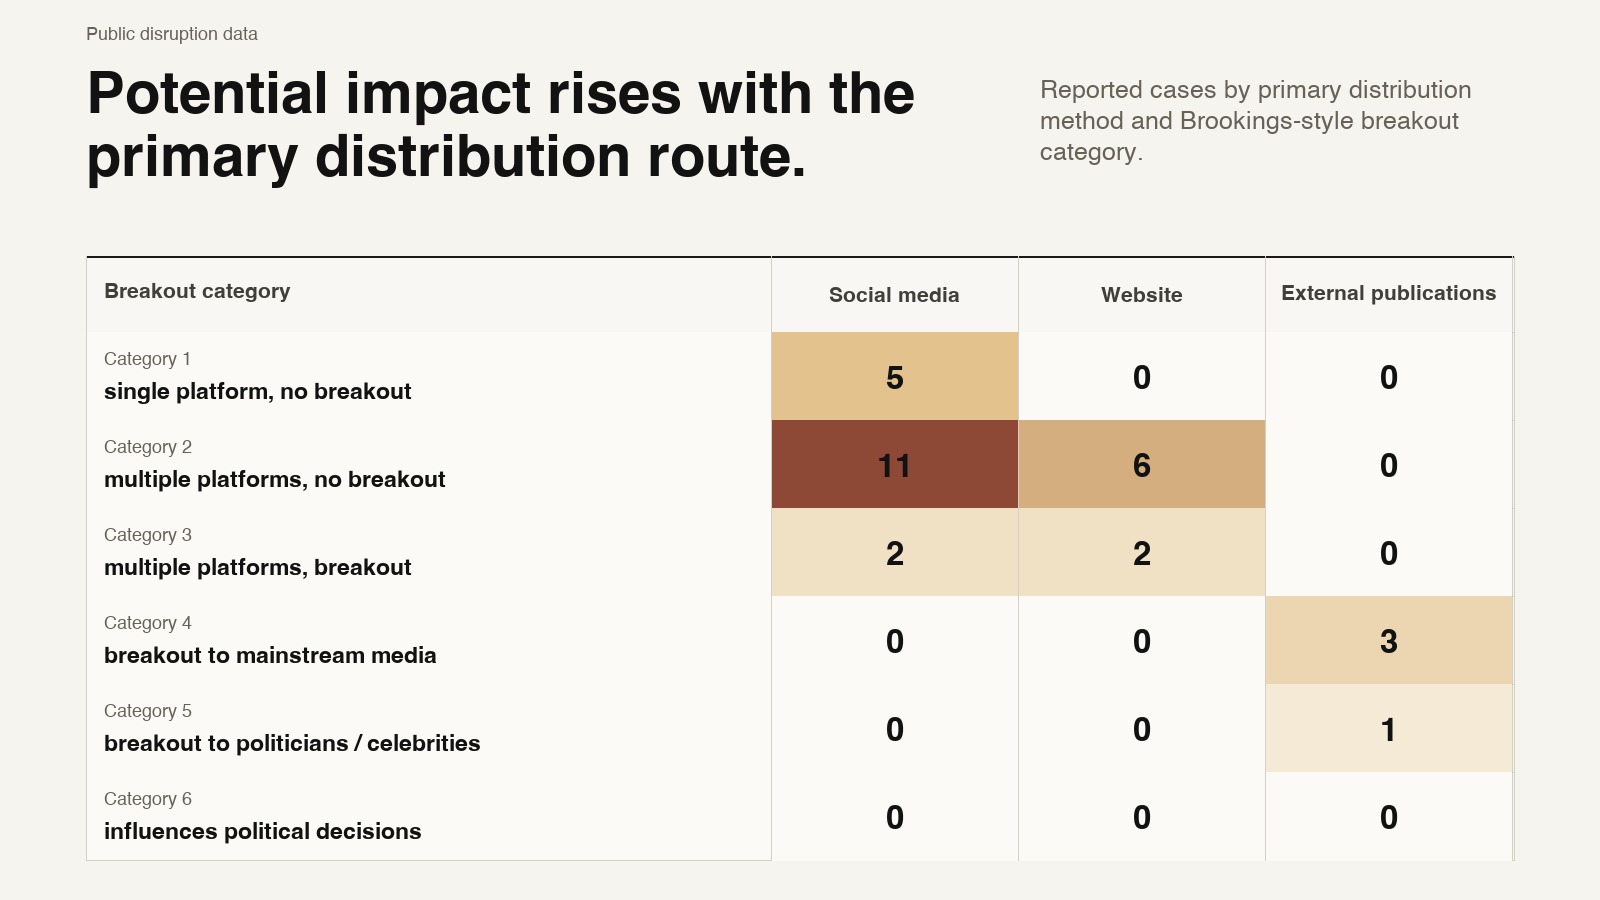
OpenAI ha bloccato due operazioni di influenza, una russa e una iraniana, che univano modelli generativi e tecniche tradizionali per sostenere entità di facciata. La parte più rilevante non è il volume social: entrambe sono riuscite a collocare contenuti in testate reali, raggiungendo le categorie 5 e 4 della Breakout Scale.
Limiti da conoscere
Limite: Il rapporto descrive dati e interventi osservati da OpenAI sui propri servizi. Non misura l’intero fenomeno e non dimostra che l’AI sia stata la causa principale della diffusione.
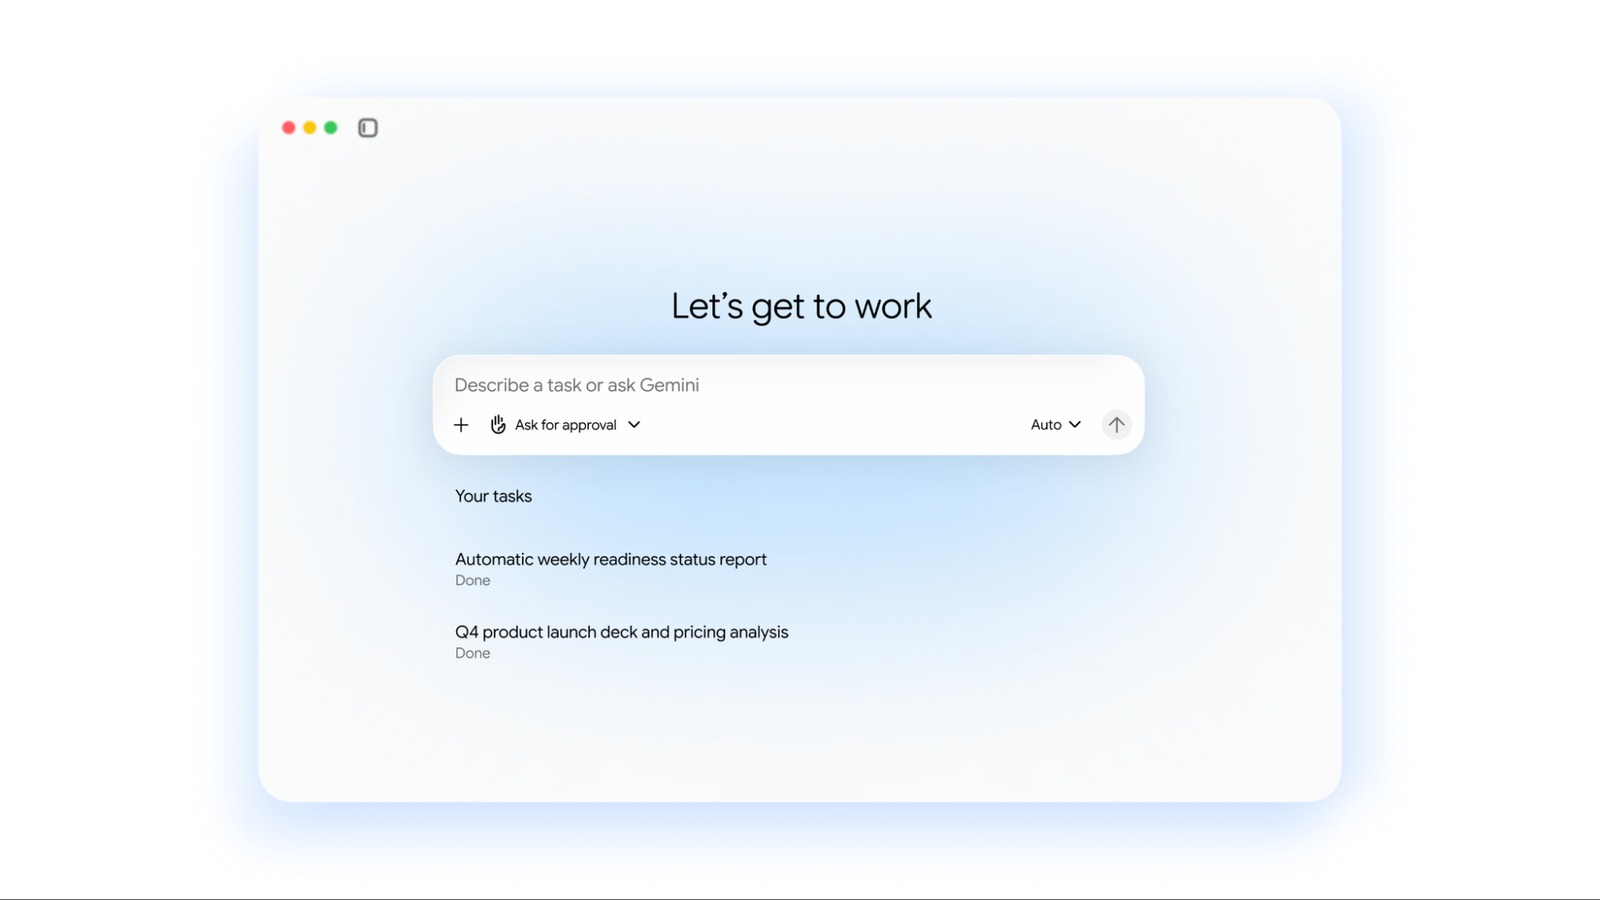
Google Cloud presenta Gemini come un agente universale accessibile da Workspace, Microsoft 365, Slack, desktop, mobile e API. Può eseguire attività persistenti nel cloud, creare sub-agenti con identità dedicate, collegarsi a server MCP e instradare i lavori tra modelli Gemini e Claude.
Limiti da conoscere
Limite: È un annuncio del fornitore. Disponibilità per piano e area, prezzi, limiti amministrativi e comportamento reale delle integrazioni richiedono verifica in un tenant; il supporto MCP non equivale al riuso automatico di credenziali consumer.
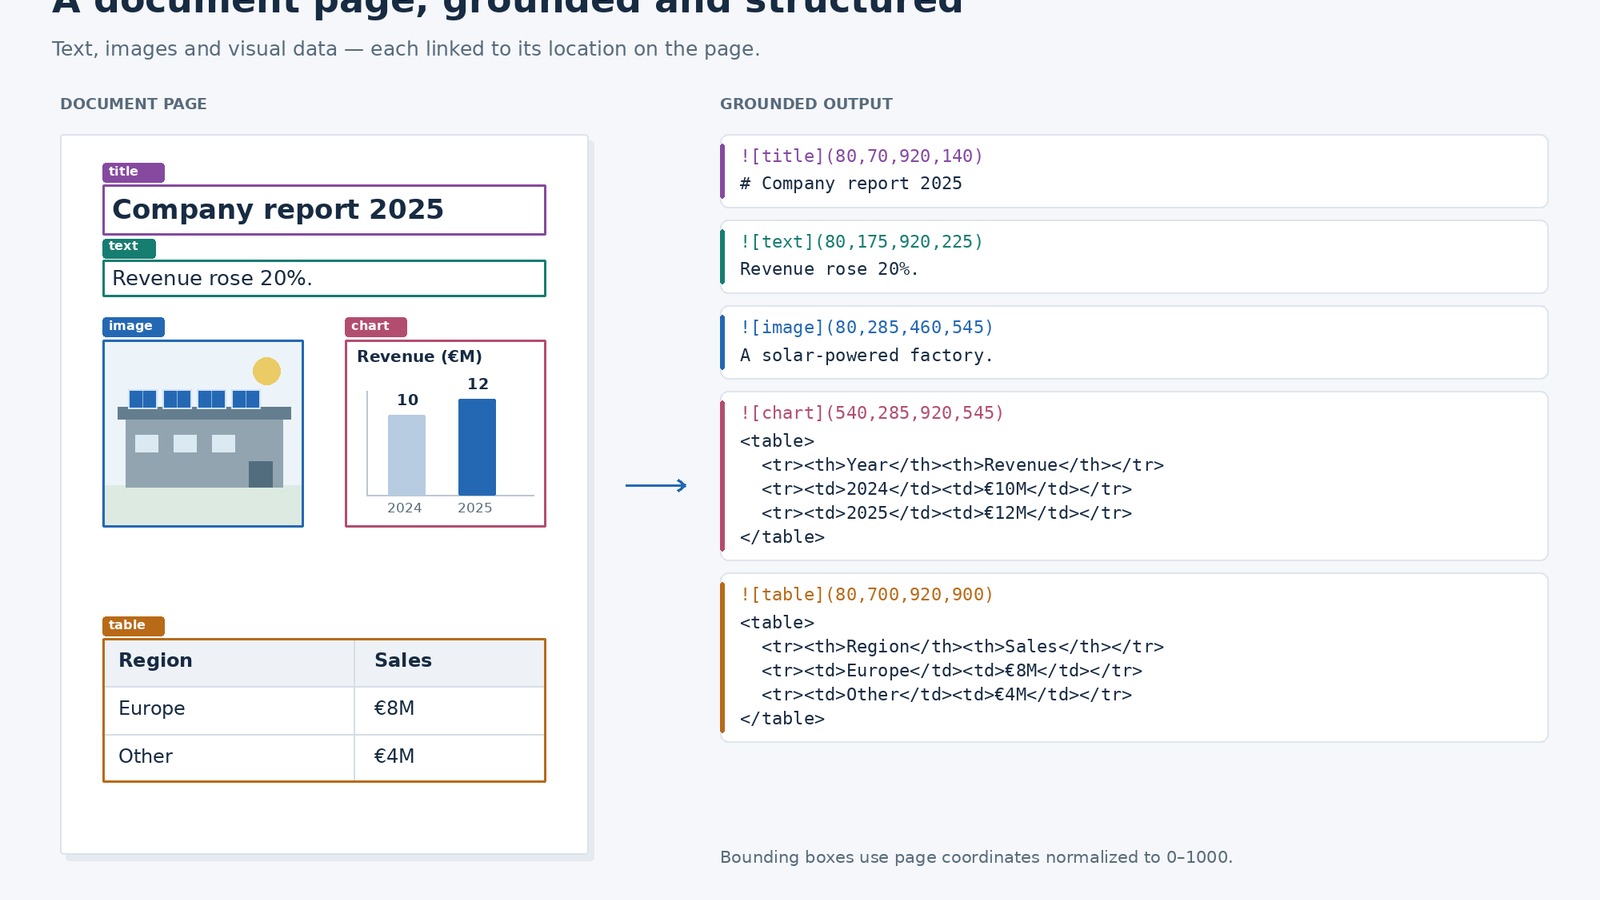
LightOn AI ha rilasciato con licenza Apache 2.0 tre modelli LightOnOCR-3 da 0,8B, 1B e 4B. Oltre alla trascrizione, il prompt grounding restituisce etichette e coordinate dei blocchi, brevi descrizioni delle immagini e tabelle ricavate dai grafici, con pesi scaricabili e codice per Transformers o vLLM.
Limiti da conoscere
Limite: Benchmark, velocità e qualità dichiarati provengono dal team del progetto e da test su dataset selezionati. L’estrazione dei valori dai grafici può includere stime e va validata sui documenti reali prima di alimentare processi automatici.
Anthropic ha avviato la Cyber Mission con due percorsi operativi: il Critical Infrastructure Defense Program porta modelli Claude, ingegneri sul posto e threat research a undici provider della sicurezza OT; OSS Scanner offre ai progetti open source scansioni periodiche gratuite con proof of concept e correzioni suggerite.
Limiti da conoscere
Limite: Il programma OT parte con un gruppo ristretto di provider e non pubblica ancora risultati comparabili. I report di OSS Scanner sono generati senza revisione umana: Anthropic stima un tasso di veri positivi superiore al 90%, ma avverte che severità e diagnosi possono essere errate.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.