
L’ANALISI
LightOnOCR-3: OCR locale con layout, immagini e grafici in un solo modello
Analisi pratica di LightOnOCR-3: varianti locali, grounding del layout, estrazione dei grafici, benchmark dichiarati e checklist per una prova controllata.
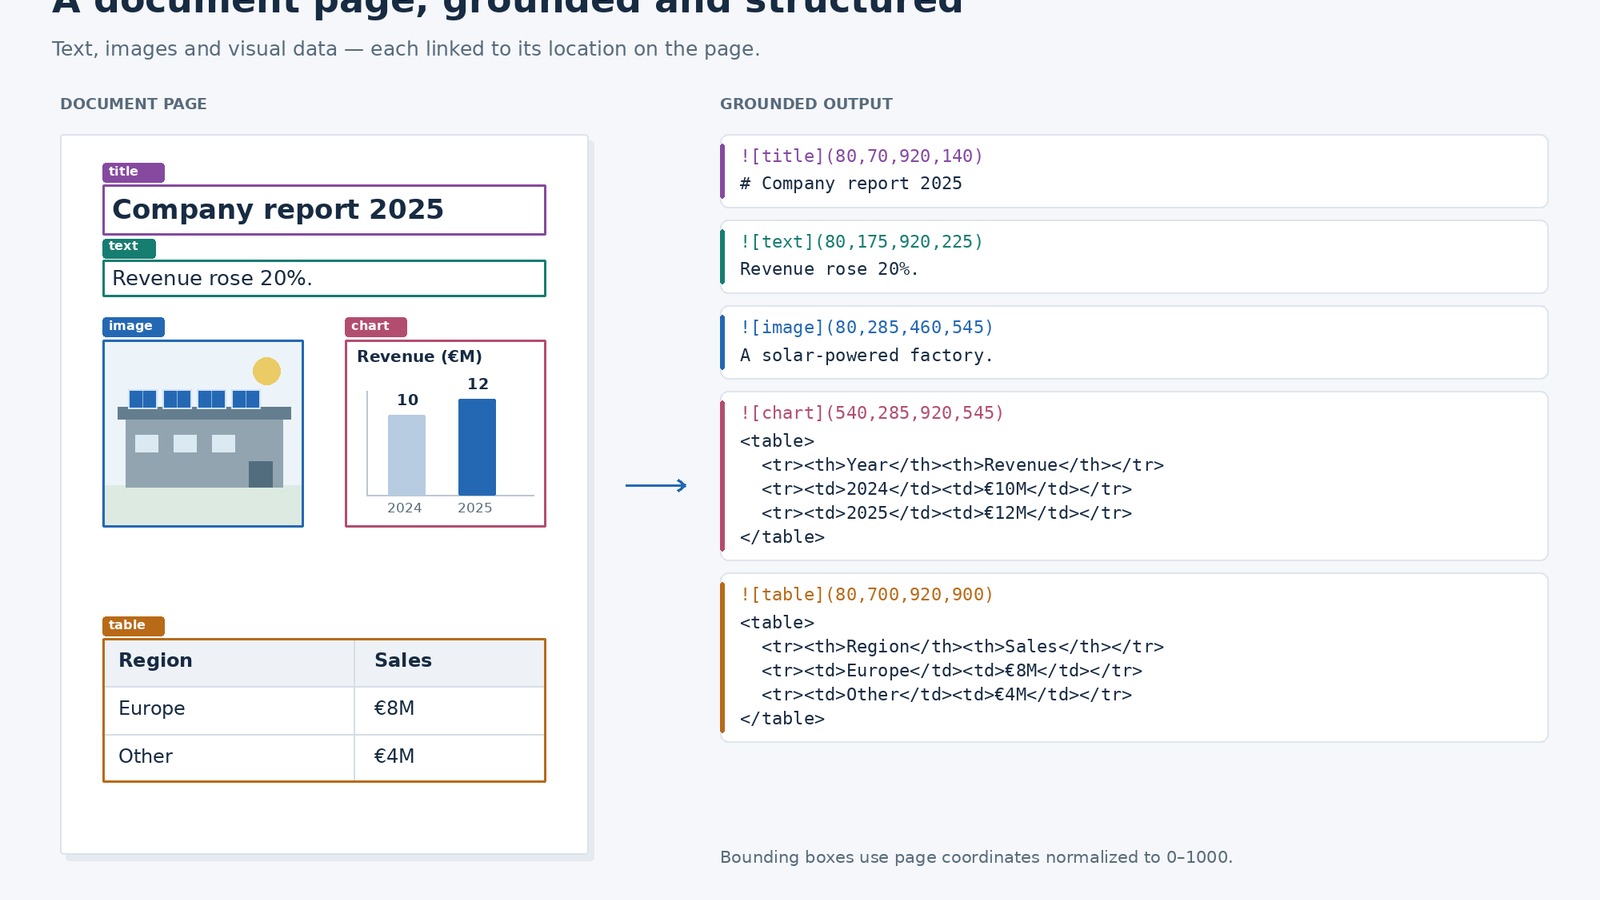
In breve: LightOnOCR-3 riduce il numero di componenti necessari per trasformare pagine e PDF in contenuto strutturato: un solo modello può trascrivere, localizzare i blocchi e descrivere immagini o grafici. Prima della produzione servono però test su scansioni, tabelle e lingue reali, oltre a controlli sui numeri estratti.
Che cosa è stato rilasciato
La famiglia comprende versioni da 0,8B, 1B e 4B, tutte con pesi scaricabili e licenza Apache 2.0. La variante 1B mantiene l’architettura della generazione precedente; 0,8B e 4B adottano un’architettura vision-language Qwen3.5.
Due modalità, un’interfaccia semplice
Con un prompt vuoto il modello esegue la trascrizione. Con il solo prompt grounding aggiunge tipo e coordinate normalizzate per ogni regione, descrizioni brevi delle immagini e tabelle HTML per i dati letti nei grafici.
Dove può semplificare una pipeline RAG
L’output conserva posizione e ruolo dei blocchi, quindi può aiutare chunking, ricerca e citazione di documenti complessi senza concatenare separatamente OCR, rilevamento del layout e descrizione visuale. La semplificazione va misurata anche su errori e manutenzione, non solo sul numero di servizi.
Prestazioni dichiarate e confronto
Nel test pubblicato, il 4B ottiene 86,3 su olmOCR-Bench e 75,1 su ParseBench; il team dichiara anche vantaggi di throughput rispetto a Chandra-OCR-2 nelle proprie condizioni H100 e vLLM. Sono risultati del produttore, con normalizzazioni che possono modificare i punteggi.
Vincoli operativi
Le pagine vengono convertite in immagini e la risoluzione influenza token, latenza e precisione. Il progetto raccomanda 1540 pixel sul lato lungo per la variante 1B, mentre i migliori risultati dichiarati di 0,8B e 4B usano fino a 400 DPI e 5 megapixel.
Condizioni e limitazioni
Benchmark, velocità e qualità dichiarati provengono dal team del progetto e da test su dataset selezionati. L’estrazione dei valori dai grafici può includere stime e va validata sui documenti reali prima di alimentare processi automatici.
Checklist pratica
- Scegliere una variante e fissare modello, revisione, librerie e risoluzione di rendering.
- Creare un campione con scansioni, moduli, tabelle, grafici, scrittura a mano e documenti italiani.
- Misurare trascrizione, ordine di lettura, coordinate e accuratezza numerica separatamente.
- Validare sempre i valori estratti dai grafici prima di usarli per decisioni o automazioni.
- Registrare VRAM, latenza, pagine al secondo ed errori sul proprio hardware.
- Confrontare il modello unico con la pipeline OCR e layout già in uso, inclusi costi di manutenzione.