
L’ANALISI
Liquid AI open d1: modelli locali per decisioni su testo, immagini e audio
Analisi pratica dei modelli open d1-3B e d1-omni-600M di Liquid AI: pesi, modalità, latenza dichiarata, sicurezza del codice remoto e checklist di prova.
In breve: Open d1 rende scaricabili due modelli specializzati in decisioni strutturate: non scrivono risposte, ma assegnano probabilità a opzioni definite. Sono interessanti per routing, triage e guardrail locali, purché codice remoto, calibrazione e soglie vengano verificati sul proprio flusso.
Che cosa è stato pubblicato
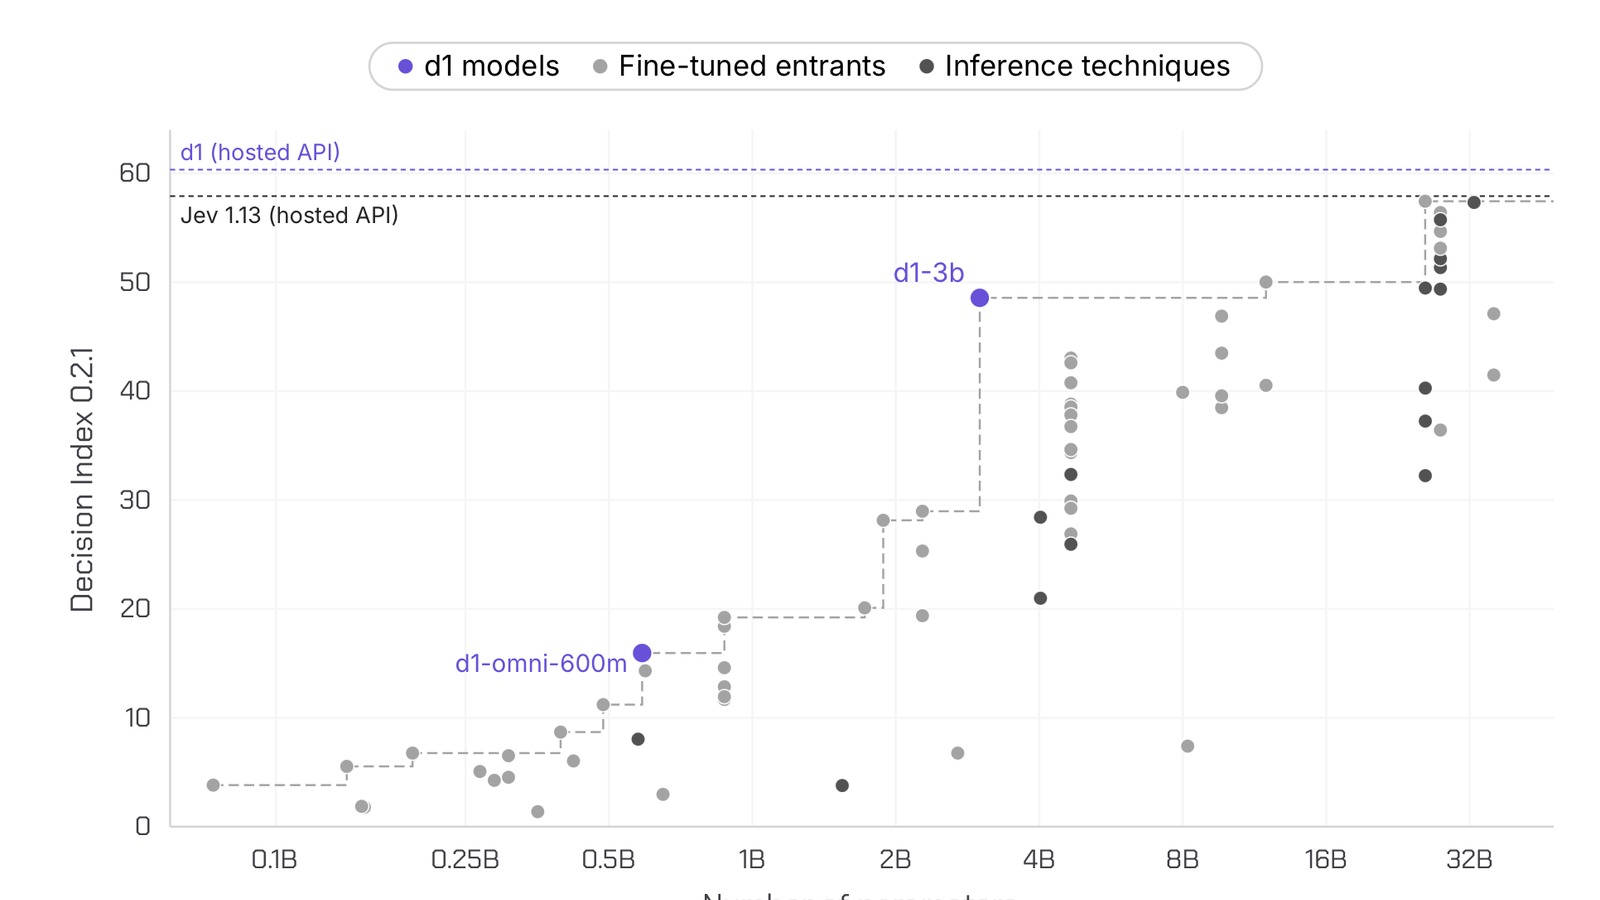
Liquid AI distribuisce d1-3B, 3,12 miliardi di parametri e contesto da 32.768 token, e d1-omni-600M, 587 milioni di parametri e contesto da 16.384 token. Entrambi hanno pesi disponibili su Hugging Face.
Che cosa fanno diversamente da un chatbot
Ricevono uno stato e domande chiuse di tipo sì/no, scelta o punteggio. La risposta deriva dalle probabilità sulle opzioni in un singolo forward pass, con zero token di output: sono classificatori generalisti, non modelli generativi.
Modalità e hardware
d1-3B combina testo e immagini. d1-omni accetta testo con immagini oppure testo con un clip audio, non immagini e audio insieme. Liquid AI dichiara per d1-3B 8 ms su RTX 4090, 9 ms su AMD MI325X, 30 ms su Apple M5 Pro e 50 ms su Jetson Orin Nano per una domanda calda.
Come leggere benchmark e confronti
Il produttore dichiara 48,57 sul Decision Index 0.2.1 per d1-3B e una media di 82,9 su sette dataset pubblici. Il punteggio Decision Index non è una submission alla leaderboard e la comparazione non sostituisce una prova indipendente sul dominio di destinazione.
Sicurezza e confine operativo
Il caricamento indicato usa trust_remote_code=True: prima di eseguire il checkpoint occorre revisionare e fissare la revisione del codice. Le probabilità devono alimentare soglie, fallback e revisione umana; non autorizzano da sole azioni irreversibili.
Condizioni e limitazioni
Prestazioni, latenza e confronti sono misure del produttore, non test indipendenti. I checkpoint eseguono codice remoto con trust_remote_code=True; d1-omni è sperimentale, non ha benchmark di velocità pubblicati e limita l’audio al dominio addestrato e a clip di 30 secondi.
Checklist per una prova controllata
- Scegliere una sola decisione chiusa e definire le opzioni prima del test.
- Fissare hash del checkpoint, revisione del codice remoto e versione di Transformers.
- Eseguire il codice in ambiente isolato senza segreti né accesso di rete non necessario.
- Creare un set locale con casi facili, ambigui, fuori dominio e avversariali.
- Misurare accuratezza, calibrazione, latenza, memoria e tasso di fallback.
- Confrontare d1-3B e d1-omni solo sulle modalità realmente necessarie.
- Imporre soglie conservative e revisione umana per azioni ad alto impatto.
- Registrare input, versione e decisione senza conservare dati sensibili oltre il necessario.