
IL PUNTO SULL’AI
7 ottobre 2026
K2-Horizon pubblica i pesi Stage 1, OpenAI apre Decisions API, EmbeddingGemma 2 porta embeddings multimodali sui dispositivi, Strands offre un decider locale, Google avvia Playground e Claude Haiku 5.5 riduce i costi dei carichi ad alto volume.
In questa edizione 6 notizie
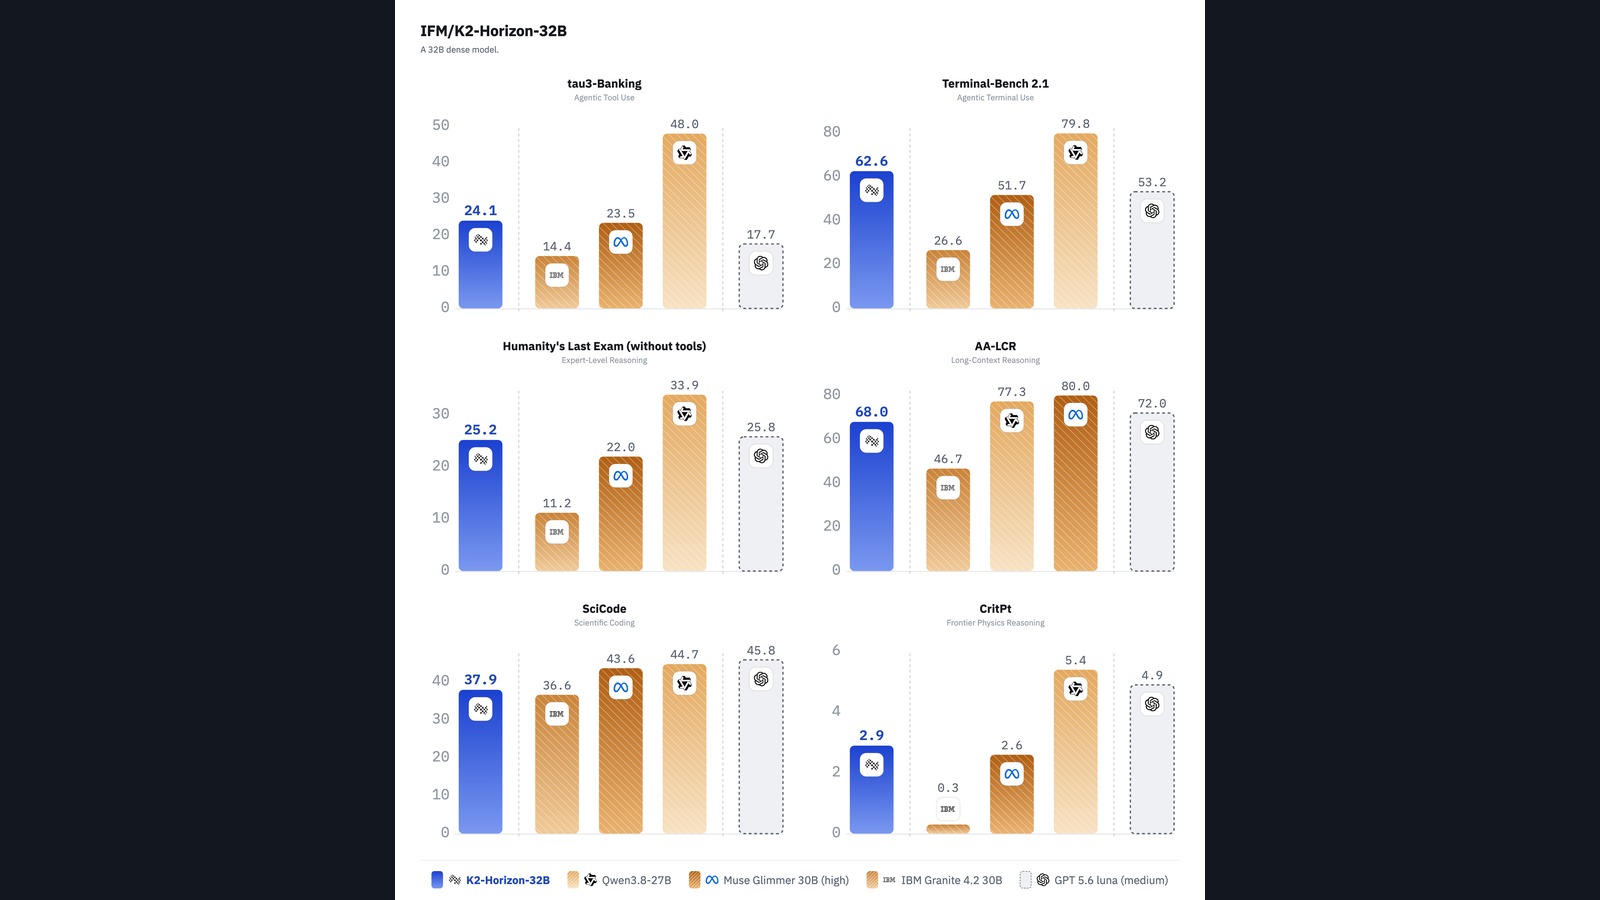
Intelligence Foundation Models ha pubblicato K2-Horizon-32B-Stage1: modello dense decoder-only da 32 miliardi di parametri, pesi Safetensors, licenza Apache 2.0 e contesto nativo dichiarato di 524.288 token. La model card include ricette per vLLM e SGLang e benchmark su agenti, coding e ragionamento.
Limiti da conoscere
Limite: È un checkpoint Stage 1, non il modello finale. La ricetta SGLang è validata dal produttore su 2 GPU H200; la ricetta vLLM limita l’esempio a 131.072 token. Benchmark e confronti sono dichiarazioni del progetto e non equivalgono a una replica indipendente.
OpenAI ha aperto in beta pubblica l’endpoint POST /v1/decisions. Accetta testo e immagini e restituisce predicate, choice o score con probabilità, usando per ora soltanto gpt-6-luna. La documentazione lo propone per classificazione, routing e priorità applicative.
Limiti da conoscere
Limite: Il confronto “10x più veloce” è una dichiarazione di OpenAI rispetto a GPT-6 Luna via Responses API, non una misura indipendente. La beta supporta un solo modello, non produce spiegazioni libere e richiede di definire in anticipo domande e risposte ammesse.
Strands Agents ha pubblicato Strands Decider 2B, un modello Apache 2.0 basato su Qwen3.5-2B che sostituisce la generazione libera con scelte, sì/no e punteggi corredati da probabilità. Codice, checkpoint, inventario dei dati e ricetta di training sono disponibili per prove locali.
Limiti da conoscere
Limite: Non è un modello di ragionamento o generazione. I risultati dichiarati provengono dal progetto: la model card segnala debolezze su documenti lunghi, domande fuori distribuzione e trasferimento della calibrazione. Soglie e affidabilità vanno misurate sui propri casi.
Google ha pubblicato EmbeddingGemma 2, un modello Apache 2.0 da 740 milioni di parametri che mappa testo, codice, immagini, audio e video nello stesso spazio vettoriale. Pesi e integrazioni sono già disponibili per prove locali con Transformers, MLX, llama.cpp, Ollama e LiteRT.
Limiti da conoscere
Limite: I benchmark e le misure di memoria sono dichiarazioni Google su set e dispositivi specifici. Un embedding condiviso non garantisce qualità sufficiente sul proprio corpus: recall, latenza, RAM, quantizzazione e privacy della pipeline vanno misurate end to end.
Google ha aperto Playground, una piattaforma sperimentale browser-based che genera e modifica giochi tramite una conversazione. Si può partire da zero o da prompt guidati, provare subito il risultato, tenerlo privato, condividerlo tramite link o pubblicarlo nella galleria.
Limiti da conoscere
Limite: Il lancio è riservato agli utenti maggiorenni negli Stati Uniti e l’accesso alla creazione viene distribuito per livelli in base al piano Google One. Non abbiamo eseguito una prova end-to-end: qualità, affidabilità, esportazione degli asset e controllo sul codice non sono documentati nell’annuncio.
Anthropic ha rilasciato Claude Haiku 5.5 per carichi ad alto volume: costa 0,10 dollari per milione di token in input e 0,50 in output fino a 100K token, introduce effort regolabile ed è disponibile anche su AWS, Google Cloud e Azure.
Limiti da conoscere
Limite: Oltre 100K token i prezzi salgono a 0,50 dollari in input e 2,50 in output. Prestazioni e risparmi pubblicati provengono da Anthropic e clienti scelti dal fornitore: non abbiamo eseguito un benchmark indipendente né verificato latenza e qualità su un carico reale.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.