
L’ANALISI
llama.cpp b12121: fix alle copie della cache KV
llama.cpp b12121 corregge copie di stato con cache KV q8_0 e q4_0. È una prerelease: ambito del difetto e controlli prima dell’aggiornamento.
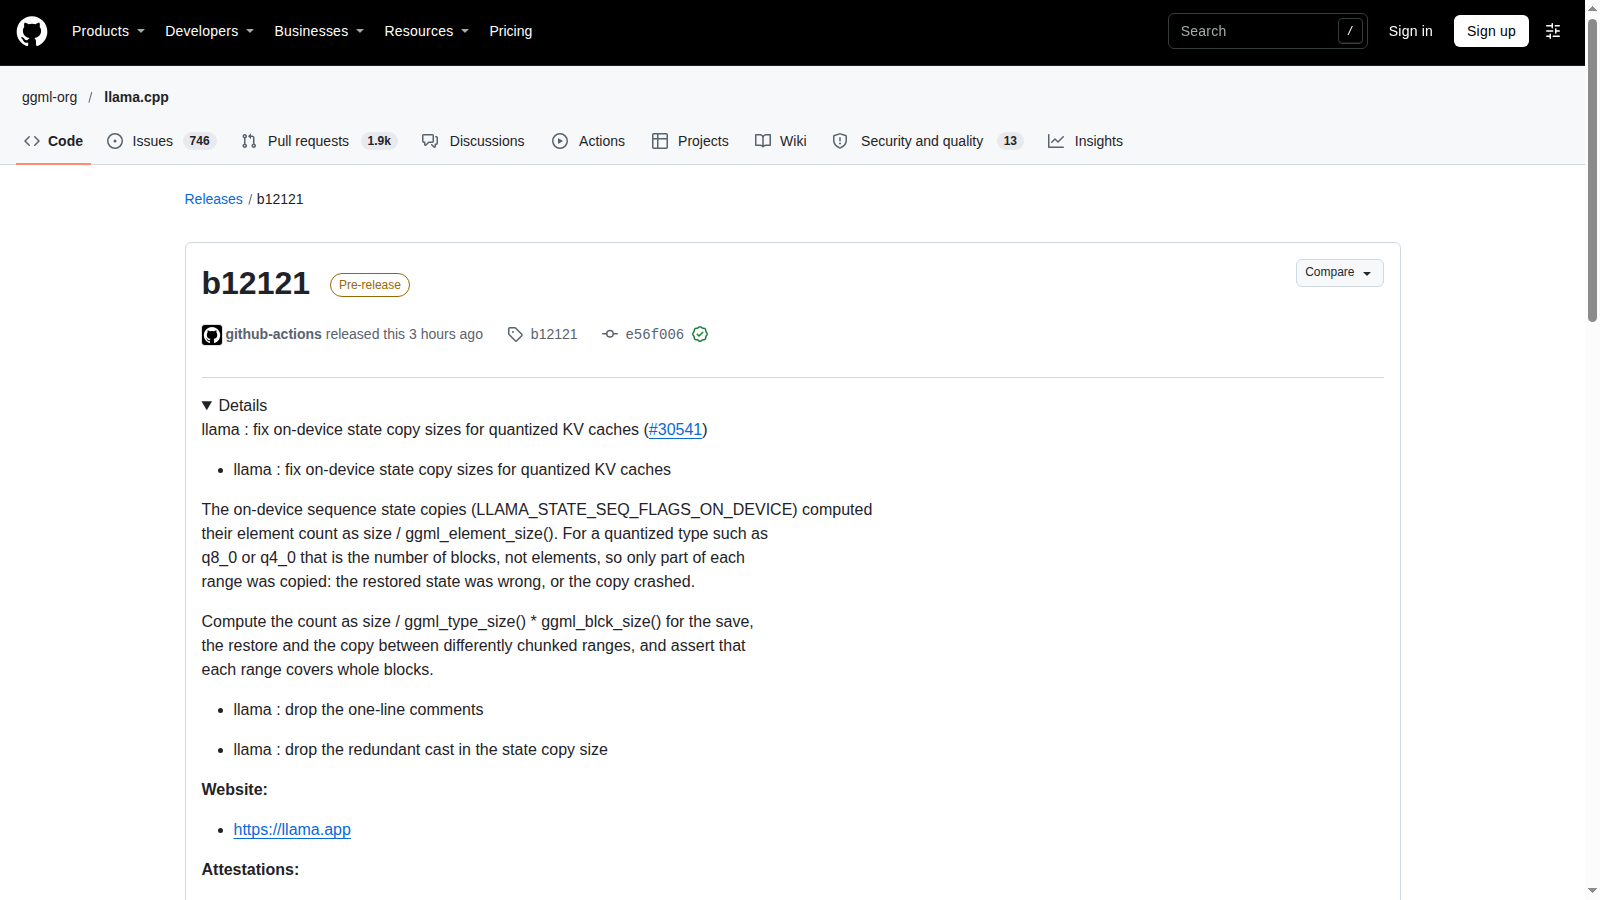
In breve: llama.cpp b12121 corregge un errore nelle copie di stato on-device quando la KV cache è quantizzata. Per decidere se aggiornare serve verificare quel percorso nella propria applicazione; il tag è una prerelease e non un benchmark di velocità. llama.cpp: note e stato prerelease di b12121.
Analisi delle note ufficiali b12121 e della pull request 30541, rilette il 5 novembre 2026. I risultati dei test citati sono dell’autore della modifica, non nostri. Nessun binario installato, modello caricato o servizio aggiornato in questa verifica editoriale.
Che cosa corregge davvero b12121
Le note collegano il problema a LLAMA_STATE_SEQ_FLAGS_ON_DEVICE: il numero calcolato per una copia trattava i blocchi dei tipi quantizzati come elementi. Una parte dello stato poteva quindi non essere copiata. Il sintomo descritto è un ripristino errato o un crash, non una misura di qualità del modello. La pubblicazione GitHub risulta del 5 novembre alle 04:00 italiane. llama.cpp: note e stato prerelease di b12121.
Perché il formato della KV cache conta
La pull request cita q8_0 e q4_0 e chiarisce che le cache f16 e f32 non sono interessate. Il perimetro non coincide quindi con tutti gli utenti llama.cpp o con ogni modello GGUF quantizzato: bisogna distinguere quantizzazione dei pesi e tipo della cache. Come verifica preliminare proponiamo di annotare entrambe le configurazioni senza dedurle dal nome del file del modello. llama.cpp: pull request 30541 e condizioni dei test.
Quali test riferisce l’autore
L’autore riporta test-save-load-state con cache K e V q8_0, poi q4_0 e flash attention attiva sul backend CPU: i casi di copia device e scatter passano con la modifica. Cita anche un controllo OpenCL insieme a un’altra modifica. È evidenza del progetto sul caso descritto, non una validazione indipendente di tutti i backend o delle applicazioni che lo integrano. llama.cpp: pull request 30541 e condizioni dei test.
Come decidere un aggiornamento prudente
Proponiamo di riprodurre in un ambiente separato il salvataggio e ripristino realmente usato, fissando build, modello, tipo di cache e backend. Confrontare errori, stato ripristinato e continuità del flusso è più pertinente di un semplice test di avvio. Conservare la build precedente permette un ritorno controllato; nessun risultato di questo protocollo è stato misurato qui. llama.cpp: note e stato prerelease di b12121.
Condizioni e limitazioni
È una prerelease, non una nuova release stabile. L’autore della correzione riferisce prove con q8_0 e q4_0 e dichiara f16/f32 non coinvolte. Non abbiamo riprodotto il difetto né validato il fix sul nostro hardware.
Checklist pratica
- Registrare commit o tag in uso e distinguere versione stabile e prerelease.
- Annotare separatamente quantizzazione del modello e tipi K/V della cache.
- Verificare se l’applicazione usa copie di stato on-device.
- Provare salvataggio e ripristino in un ambiente separato con gli stessi parametri.
- Confrontare stato ed errori, senza attribuire al fix un guadagno di velocità non misurato.
- Conservare configurazione e build precedente per un eventuale rollback.