
L’ANALISI
llama.cpp Vulkan: Split-K su AMD RDNA3 e RDNA4
llama.cpp integra la PR 30280: Split-K condizionale su AMD RDNA3 e RDNA4. I test pp512 del contributore non misurano la generazione.
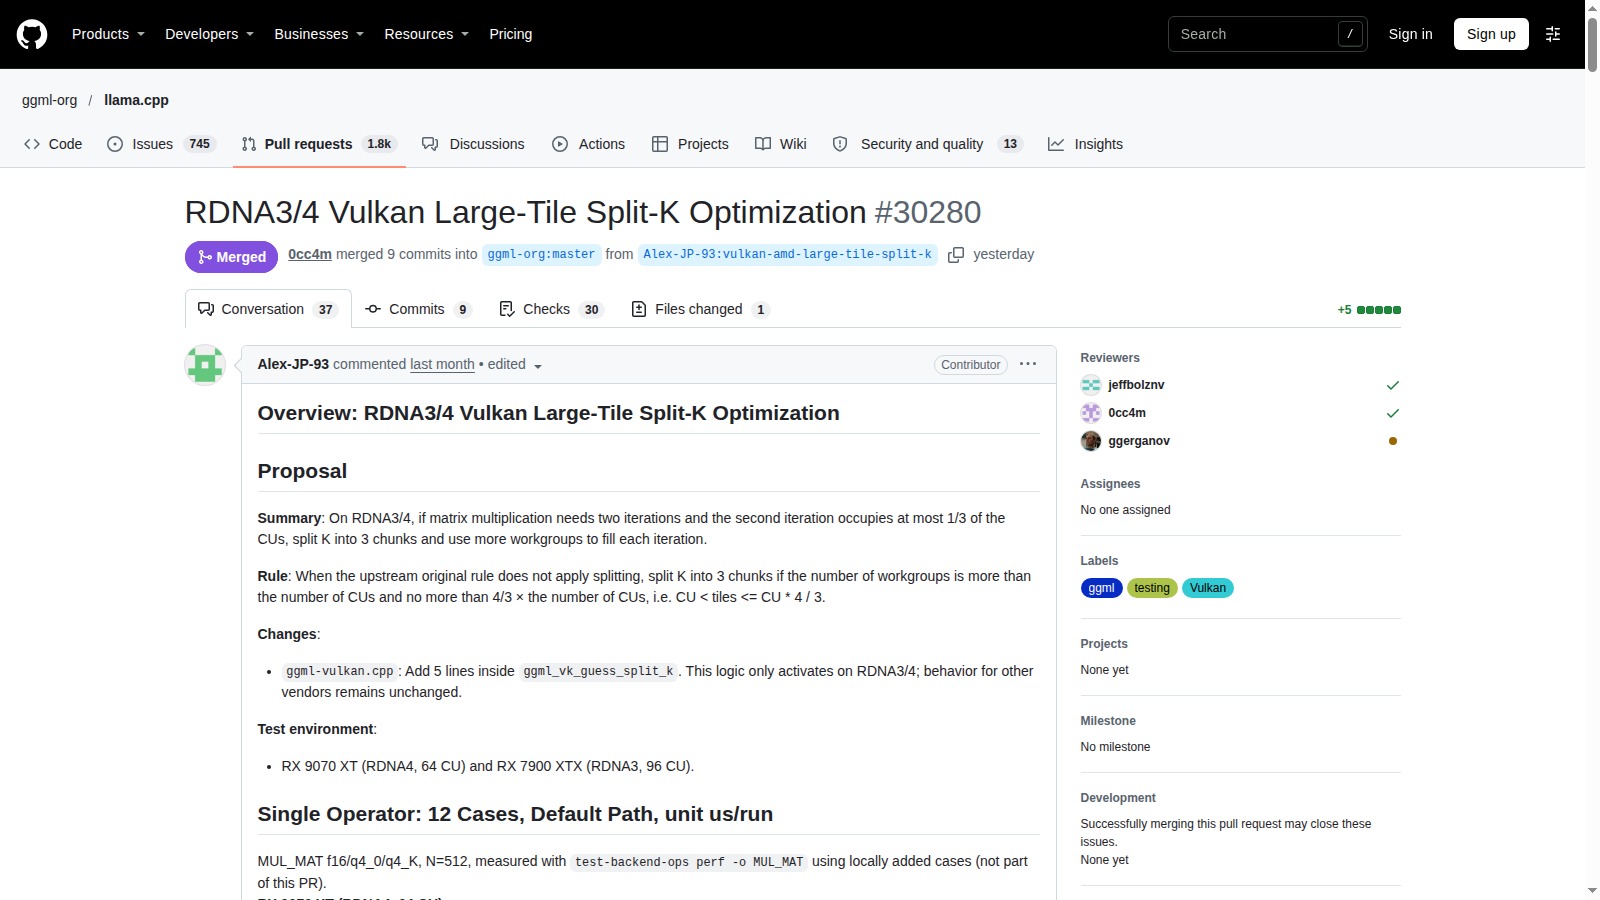
In breve: llama.cpp ha integrato una regola Split-K per AMD RDNA3 e RDNA4 nel backend Vulkan. Il cambiamento è nel codice sorgente: prima di attribuirgli un guadagno occorre verificare che la propria build lo includa e misurare separatamente prompt e generazione. llama.cpp: PR 30280, merge e benchmark del contributore.
Verifica documentale della PR 30280 e del diff tramite API GitHub il 6 novembre 2026. Merge del 5 novembre alle 12:11:08 UTC, commit da3416d8077c55d68e45ce15babd999ac7ba1c49. Non abbiamo compilato il progetto, verificato un binario distribuito o riprodotto i benchmark.
Qual è il cambiamento verificato nel codice?
La nuova condizione interessa il calcolo Split-K quando i tile superano il numero di unità di calcolo ma non quattro terzi di quel numero. In quel caso il codice può scegliere una divisione in tre parti, limitata alle architetture RDNA3 e RDNA4. Per chi esamina una build, il controllo utile è sul commit incluso e sul backend attivo: il nome generico dell’applicazione non basta a collegare l’esecuzione a questa modifica.
llama.cpp: PR 30280, merge e benchmark del contributore.
Perché pp512 non significa generazione più rapida?
Il benchmark riportato dal contributore usa un prompt di 512 token e zero token generati. È quindi una misura di prompt processing. Nel test proposto per il proprio computer teniamo separata la lettura del prompt dalla produzione della risposta: una variazione nella prima non autorizza a dichiarare la stessa variazione nella seconda. Anche il tempo totale percepito dall’utente resta una misura distinta, da registrare sul flusso reale.
llama.cpp: PR 30280, merge e benchmark del contributore.
È già una release da installare?
La notizia verificata è il merge, non la disponibilità di uno specifico pacchetto stabile o eseguibile. Prima di aggiornare proponiamo di leggere la provenienza della build e cercare il commit nella sua storia. Se il distributore non espone quel legame, il requisito resta non verificato. Non indichiamo un tag come scorciatoia e non trasformiamo una pagina di release mancante nella prova che il codice non esista.
llama.cpp: PR 30280, merge e benchmark del contributore.
Come impostare un confronto utile sulla propria GPU?
Proponiamo due build identificate, lo stesso file modello, identici parametri e driver, e più ripetizioni dopo una fase di riscaldamento. Conservare i risultati dei casi senza miglioramento è essenziale per evitare di scegliere soltanto il modello favorevole. Registrare separatamente pp e tg, memoria ed errori; non cambiare contemporaneamente quantizzazione o contesto. È un protocollo suggerito, non una prova già eseguita né una raccomandazione ad aggiornare un sistema di produzione senza rollback.
llama.cpp: PR 30280, merge e benchmark del contributore.
Condizioni e limitazioni
Verificati merge e diff, non una nuova release binaria. Nessuna compilazione o prova GPU eseguita qui. Le misure sono del contributore, con hardware e casi specifici; non si estendono automaticamente a ogni modello, driver o quantizzazione.
Checklist pratica
- Verificare che la GPU sia RDNA3 o RDNA4 e che sia attivo il backend Vulkan.
- Identificare commit e provenienza della build; non confondere merge e release distribuita.
- Conservare la build precedente per un confronto reversibile.
- Usare stesso modello, hash, quantizzazione, contesto, driver e parametri.
- Misurare separatamente prompt processing pp512 e generazione, includendo i casi peggiori.
- Non trasferire i risultati del contributore al proprio hardware senza una prova ripetuta.