
IL PUNTO SULL’AI
5 novembre 2026
llama.cpp e Mistral aggiornano l’inferenza; un preprint sui retry distingue recupero del servizio, risposte consegnate e carico duplicato.
In questa edizione 13 notizie
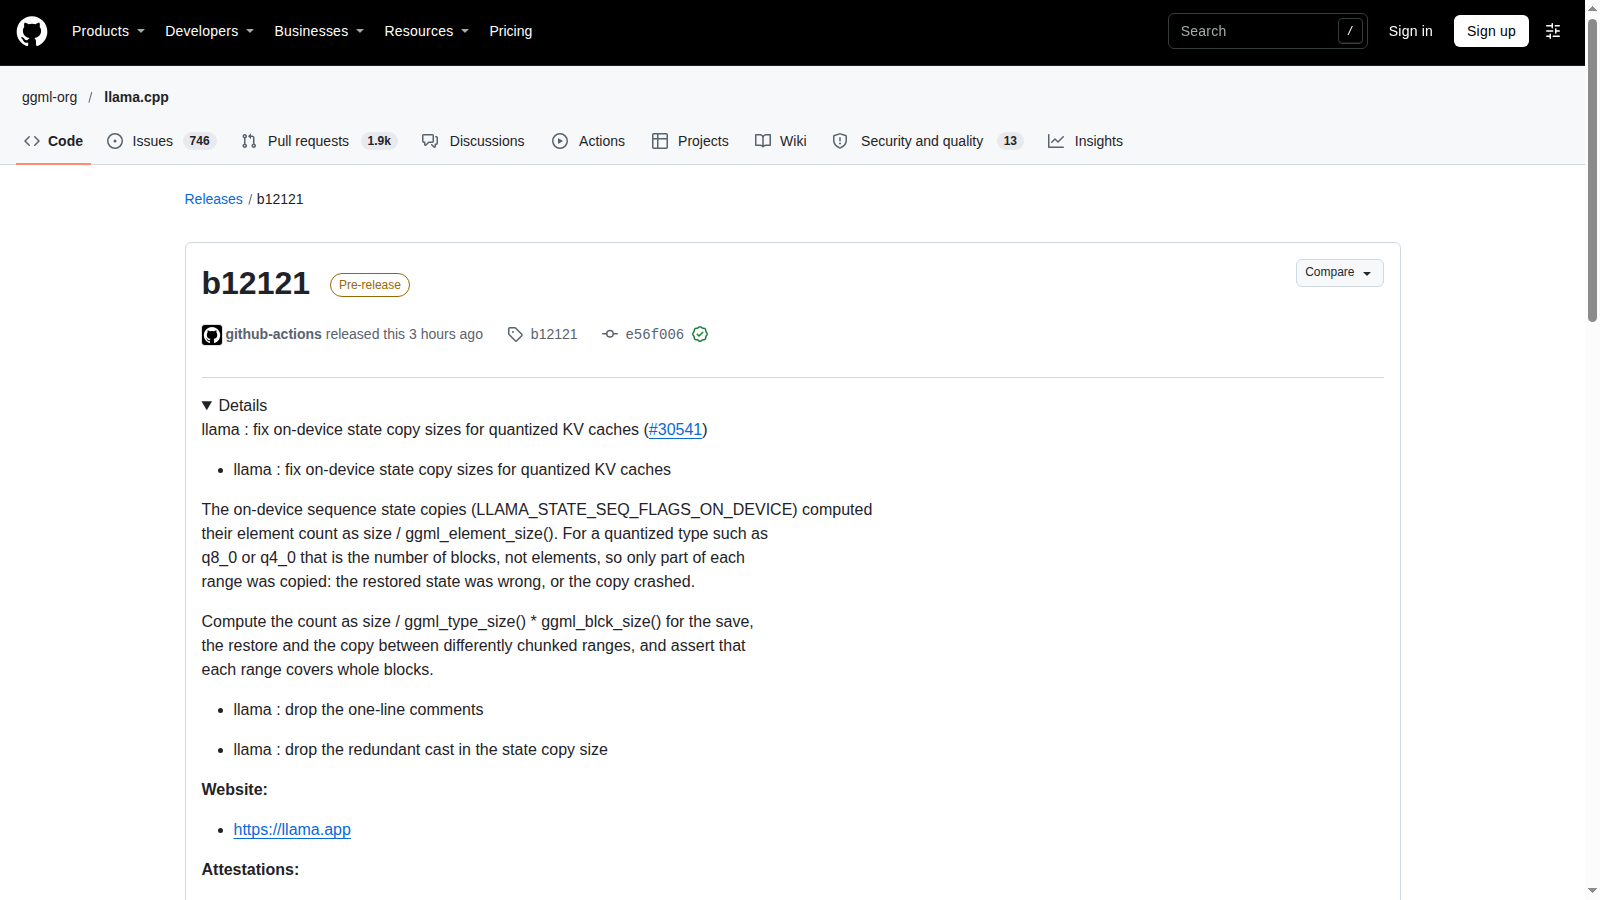
La prerelease b12121 del 5 novembre corregge il conteggio nelle copie di stato on-device con KV cache quantizzate. Le note spiegano che una copia parziale poteva ripristinare uno stato errato o causare un crash. Il delta interessa chi usa quel percorso di salvataggio e ripristino, non dimostra un aumento generale delle prestazioni.
Limiti da conoscere
Limite: È una prerelease, non una nuova release stabile. L’autore della correzione riferisce prove con q8_0 e q4_0 e dichiara f16/f32 non coinvolte. Non abbiamo riprodotto il difetto né validato il fix sul nostro hardware.
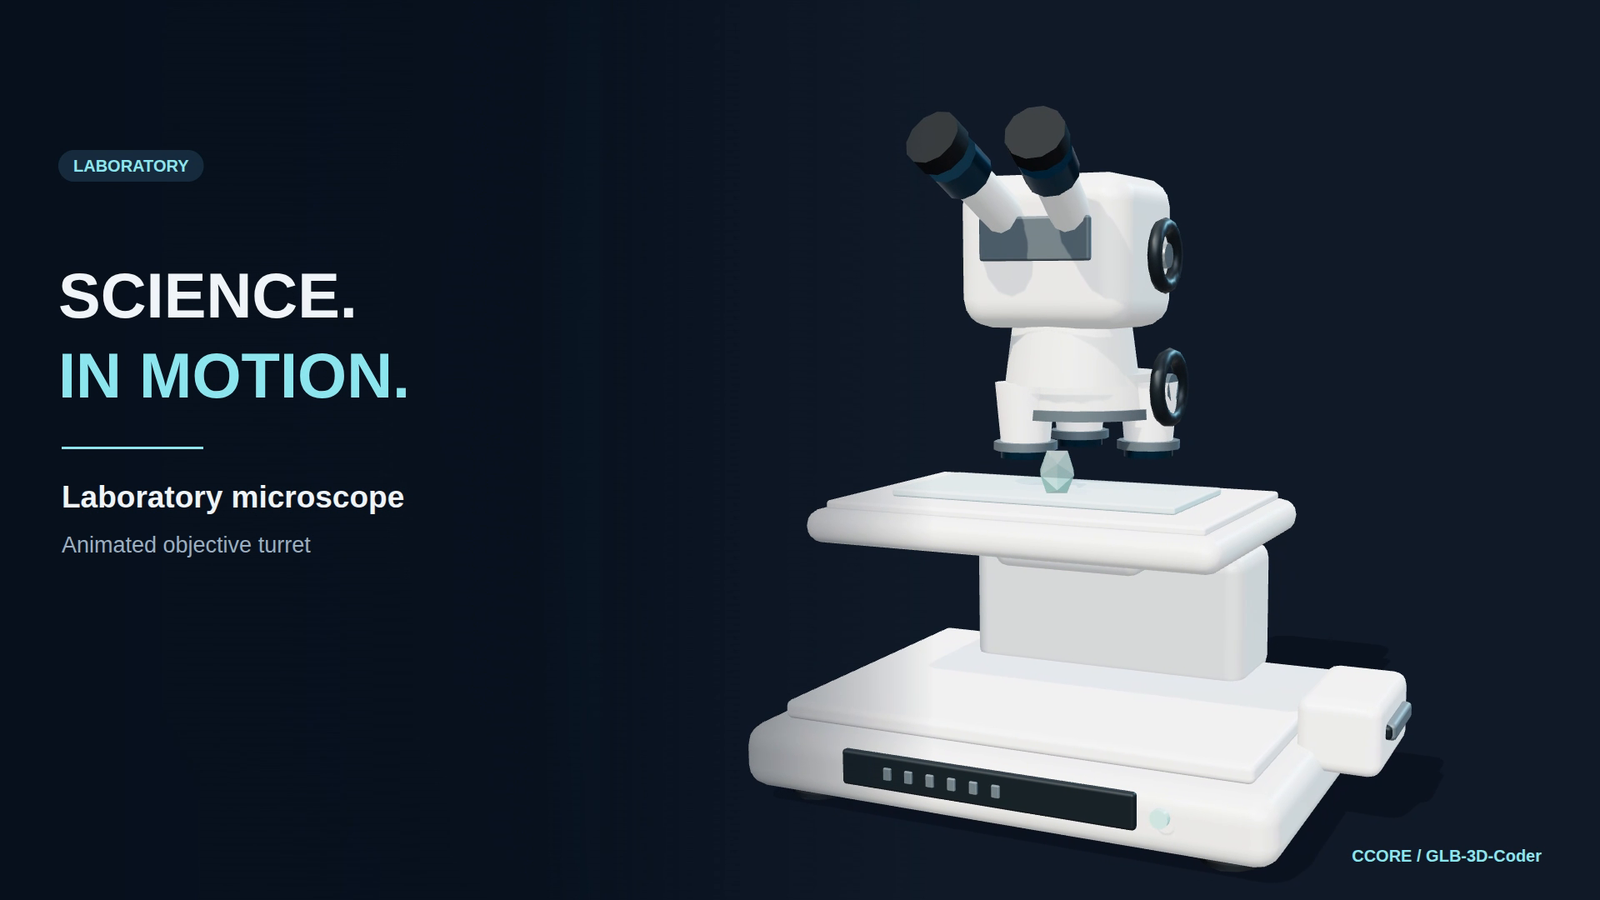
CCORE pubblica il checkpoint u008186 del fine-tuning indipendente su Qwen3.5-4B. I GGUF Q4_K_M e Q8_0 mantengono nomi e dimensioni, ma cambiano gli identificatori LFS; arrivano anche i cinque shard Safetensors originali. È un aggiornamento dei pesi scaricabili, non soltanto della vetrina: il modello genera HTML/JavaScript Three.js con anteprima ed export GLB.
Limiti da conoscere
Limite: Nessun peso scaricato e nessuna generazione, esportazione o importazione in Godot eseguita. I circa 17,49 GB degli shard indicano download, non RAM richiesta. La pagina generata può caricare librerie da CDN e l’export può differire dall’anteprima; il dataset resta annunciato.
Alook 0.1.64 include due correzioni per i flussi email degli agenti: conserva le dimensioni degli allegati e i byte dei messaggi IMAP, e corregge la gestione degli orari assoluti negli inviti. La release del 5 novembre è marcata non-prerelease. Il punto operativo non è un nuovo modello: è evitare che un messaggio venga interpretato o pianificato in modo diverso dalla sua origine. Note Alook 0.1.64.
Limiti da conoscere
Limite: Verifica documentale di release, tag e pull request, non prova end-to-end. Non abbiamo installato Alook, collegato caselle, ricevuto allegati o eseguito inviti reali. I test riportati dal progetto non dimostrano consegna email, collegamento ai provider o corretto scheduling in produzione; gli inviti non risolti restano incerti.
Google annuncia Gemini Omni 1.2 Flash: generazione ed editing video fino a 15 secondi, API a pagamento e prezzo video ridotto. Chat business e riferimenti audio richiedono distinzioni rispetto all'annuncio. Annuncio Google Gemini Omni 1.2 Flash.
Limiti da conoscere
Limite: Verifica documentale, non prova del modello: nessuna generazione, misura di qualità o fattura. Il post Cloud collegato è datato 6 novembre, successivo alla verifica del 5 novembre.
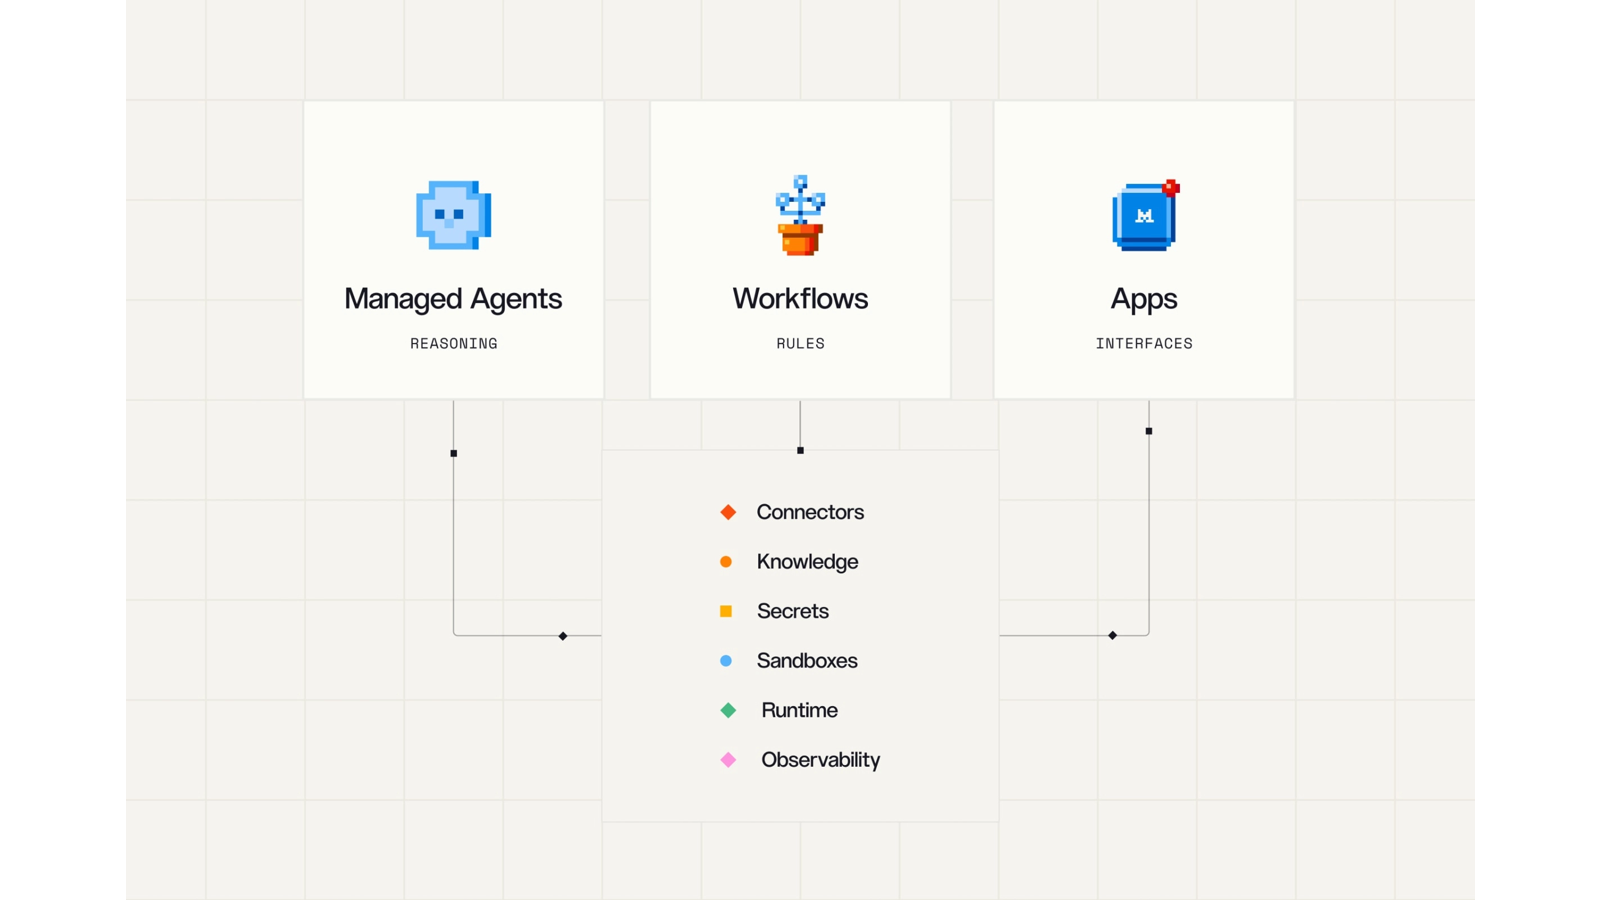
Mistral Studio aggiunge Managed Agents e strumenti per workflow e app. L’SDK permette di lavorare nel proprio processo, servire un worker proprio o usare l’esecuzione gestita. Il punto pratico è distinguere dove girano harness, modello e sessioni: self-hosted non significa automaticamente tutto locale. Le note del 5 novembre classificano Managed Agents in public preview e i connettori HTTP in private preview. Release note Mistral Studio.
Limiti da conoscere
Limite: Analisi documentale di annuncio, guide e release note, non installazione o prova end-to-end. Public preview e private preview hanno accessi e stabilità diversi. Non abbiamo verificato account, contratti, prezzi, retention, residenza effettiva dei dati o recupero da crash.
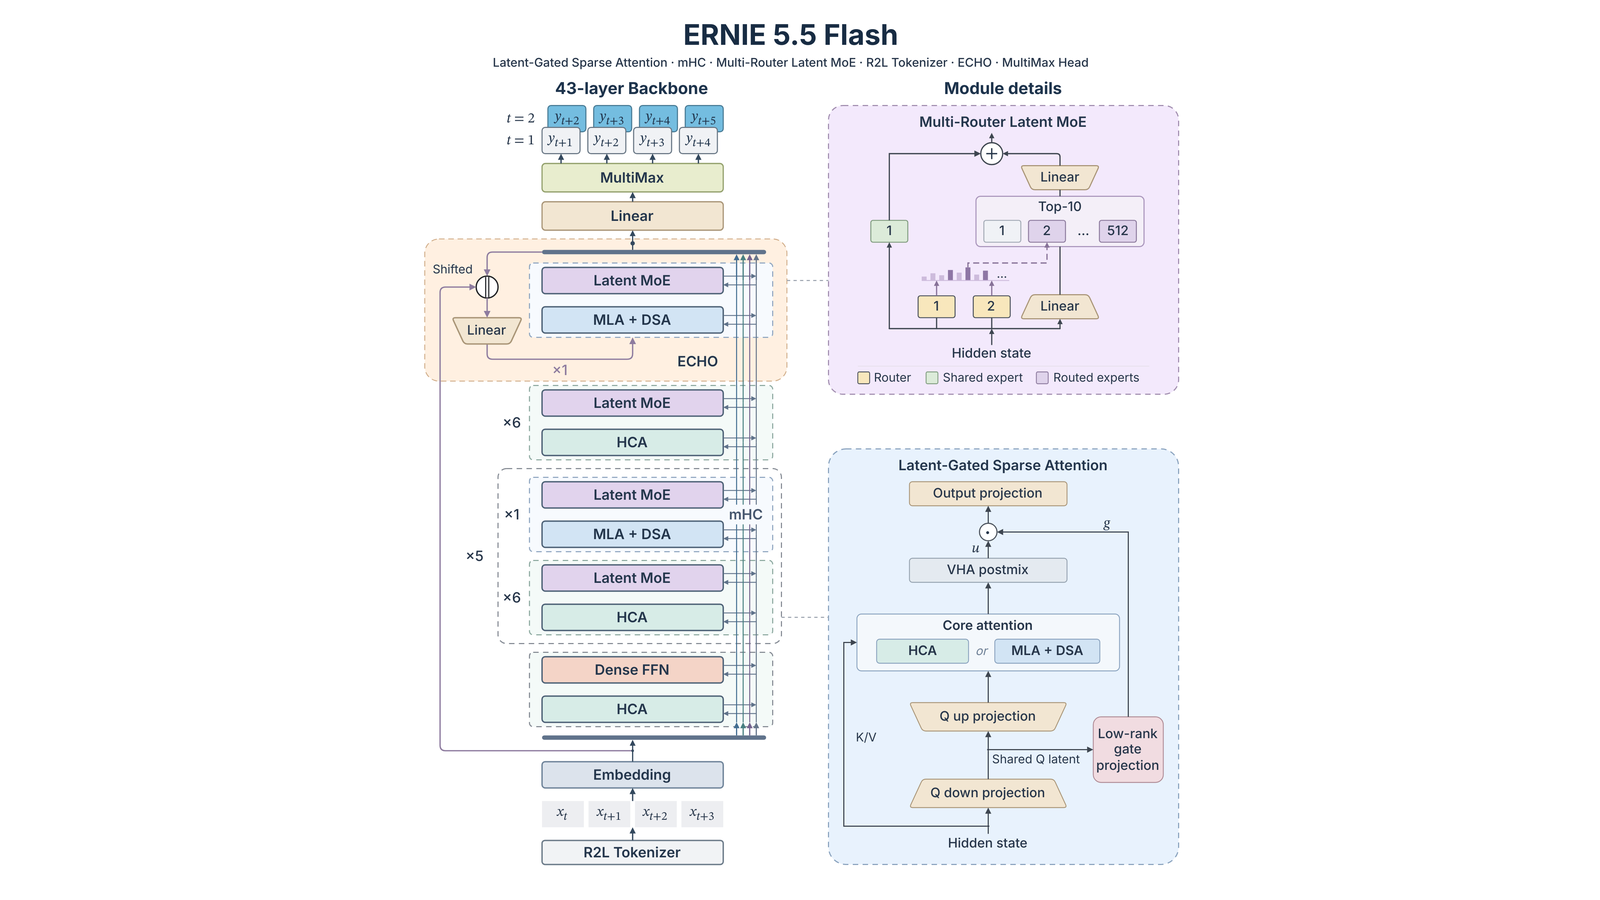
Baidu presenta ERNIE 5.5 Flash Base, un checkpoint MoE prima del mid/post-training. I 14B attivati per token non descrivono il peso dell'intero modello: l'indice FP8 dichiara circa 288,42 GB. La licenza esclude UE, Regno Unito e Corea del Sud dal territorio autorizzato. Annuncio Baidu.
Limiti da conoscere
Limite: Analisi documentale, non prova del modello: nessun peso scaricato, inferenza o requisito RAM misurato. Lettura della licenza, non consulenza legale. L'allegato reca il 6 novembre 2026, futuro rispetto alla verifica del 5 novembre.
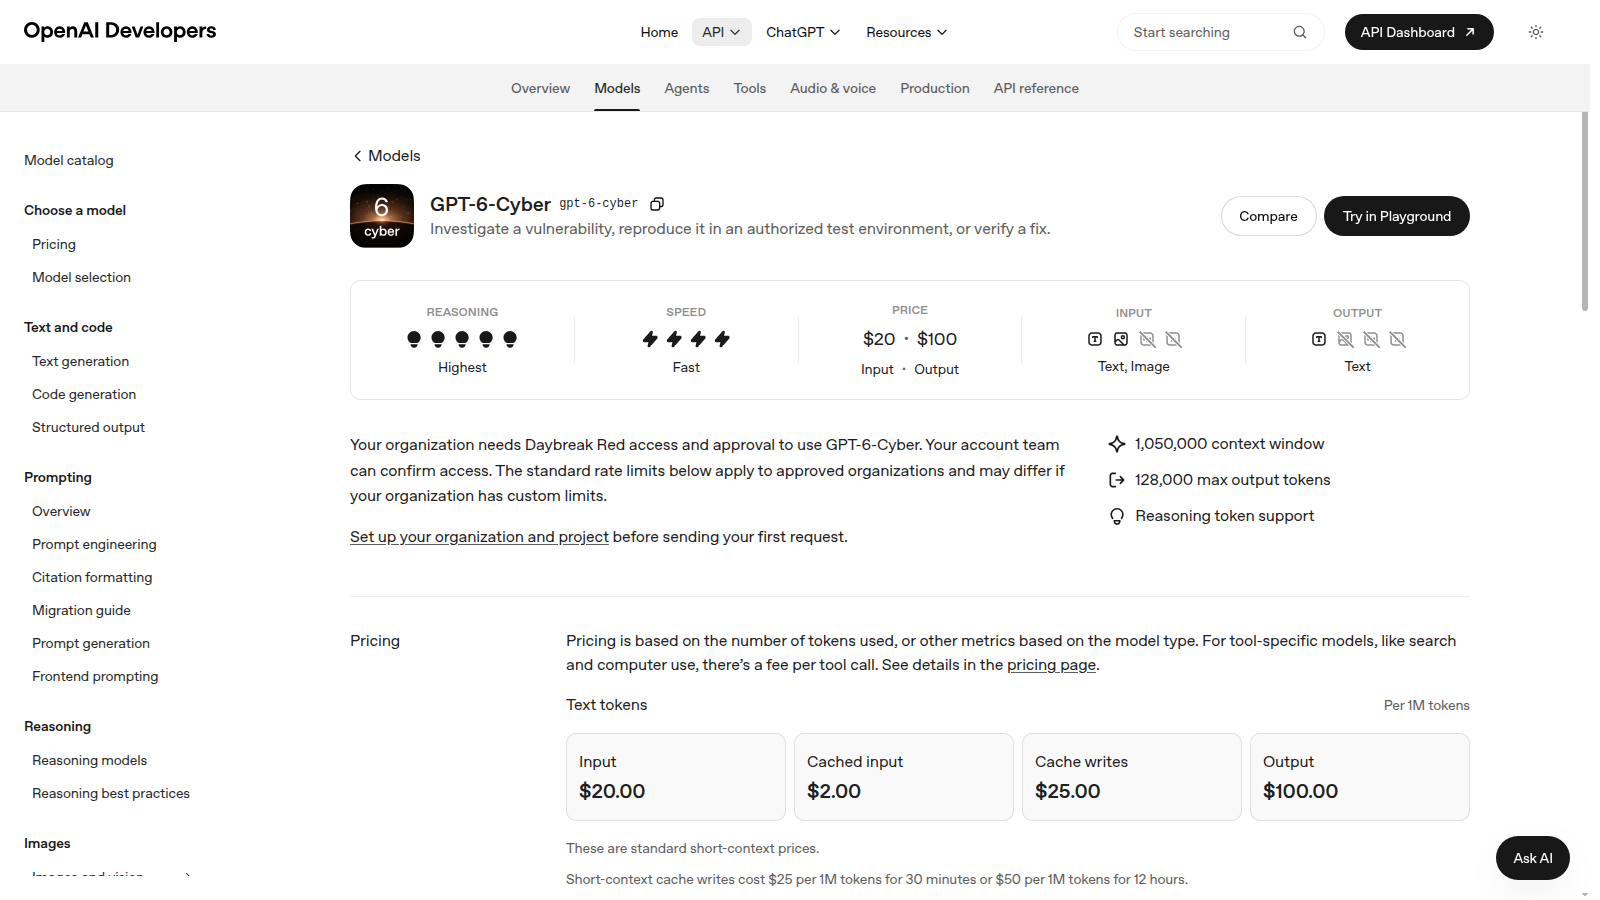
OpenAI annuncia GPT-6 Cyber per analizzare vulnerabilità e verificare correzioni entro un perimetro autorizzato. La scheda API richiede Daybreak Red e un’approvazione specifica del modello: conoscere il nome dell’endpoint non concede l’accesso. Scheda API OpenAI.
Limiti da conoscere
Limite: Analisi delle fonti ufficiali, non prova del modello o delle capacità offensive. Nessuna chiamata API, verifica di accesso o misura di efficacia. L’annuncio web restituisce 403; data e descrizione sono confermate dal feed ufficiale, dettagli operativi dalla documentazione API.
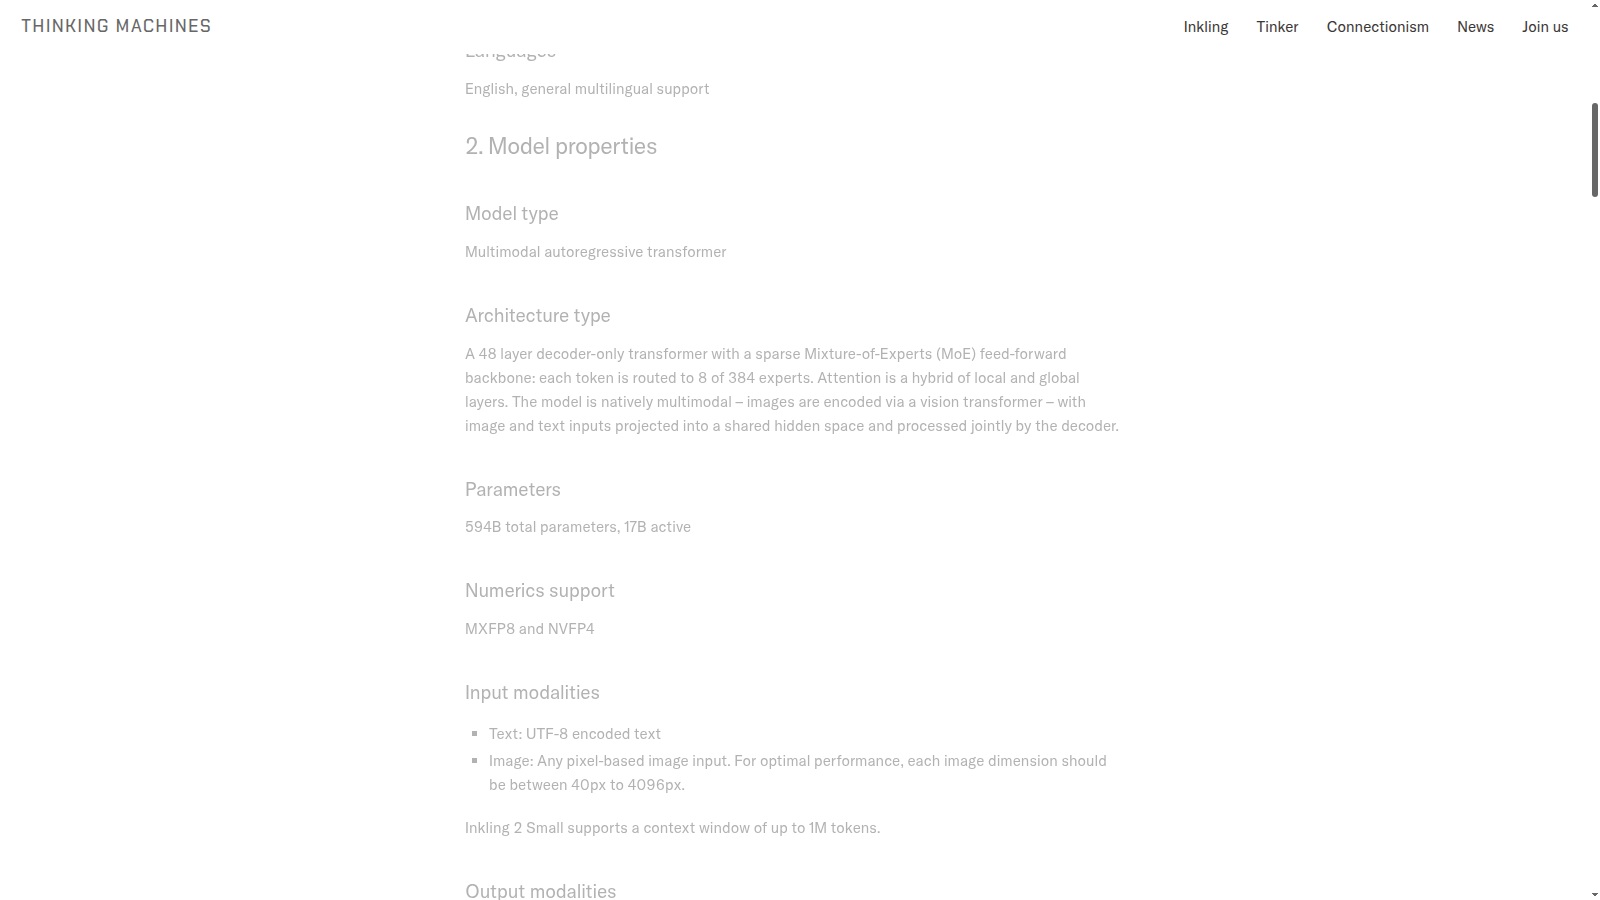
Thinking Machines Lab presenta Inkling 2 Small: modello multimodale MoE con 594B parametri totali e 17B attivi, disponibile tramite Tinker. I pesi sono inizialmente chiusi; il rilascio Apache 2.0 è un impegno futuro condizionato ai test esterni, non un download già disponibile. Il laboratorio descrive anche un incidente durante il training e nuovi controlli sulle chiamate agli strumenti. Thinking Machines Lab: Introducing Inkling 2 Small.
Limiti da conoscere
Limite: Pesi non ancora pubblici al momento della verifica. L’incidente e i miglioramenti di allineamento sono riferiti dal laboratorio; non dimostrano che il modello rispetti ogni vincolo in un sistema reale. Accesso dell’account, tariffe e prestazioni non sono stati provati.
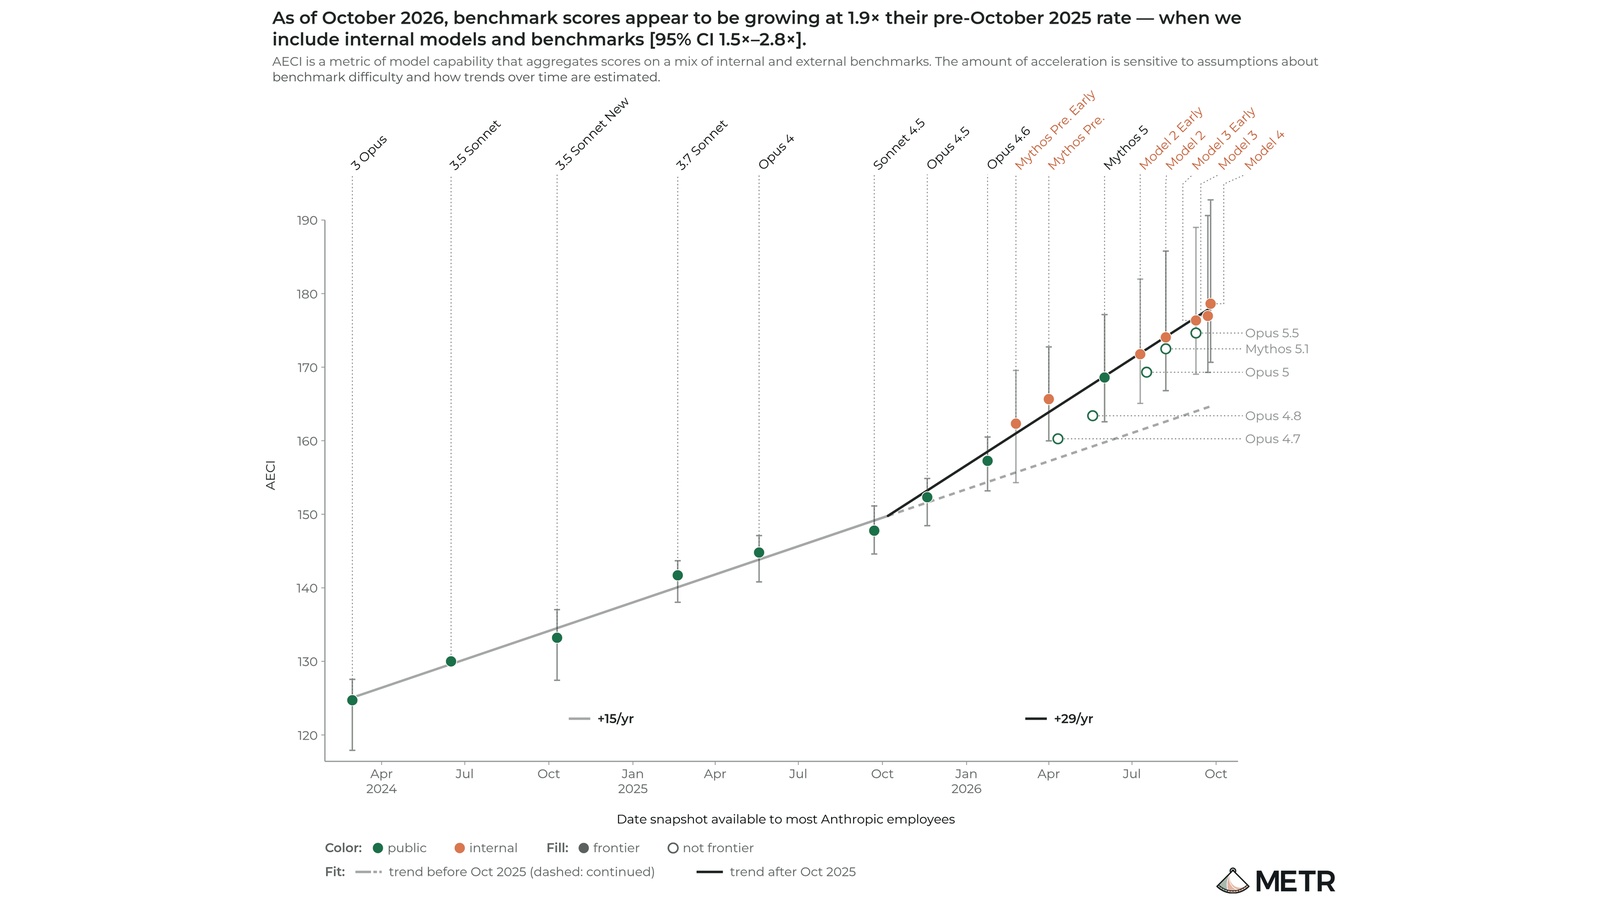
Nel rapporto del 5 novembre, METR stima che il ritmo di crescita dei punteggi AECI di Anthropic sia 1,9× quello precedente a ottobre 2025, con intervallo di confidenza al 95% di 1,5–2,8×. La metrica riguarda il progresso sui benchmark, non le ore risparmiate da ogni ricercatore. METR: valutazione indipendente della ricerca Anthropic a ottobre 2026.
Limiti da conoscere
Limite: METR dichiara forte incertezza causale e segnala che Anthropic ha rimosso dalla versione pubblica molta dell’evidenza decisiva. I dati interni non sono stati riprodotti qui. Il rapporto descrive soprattutto assistenza AI, non ricerca completamente autonoma.
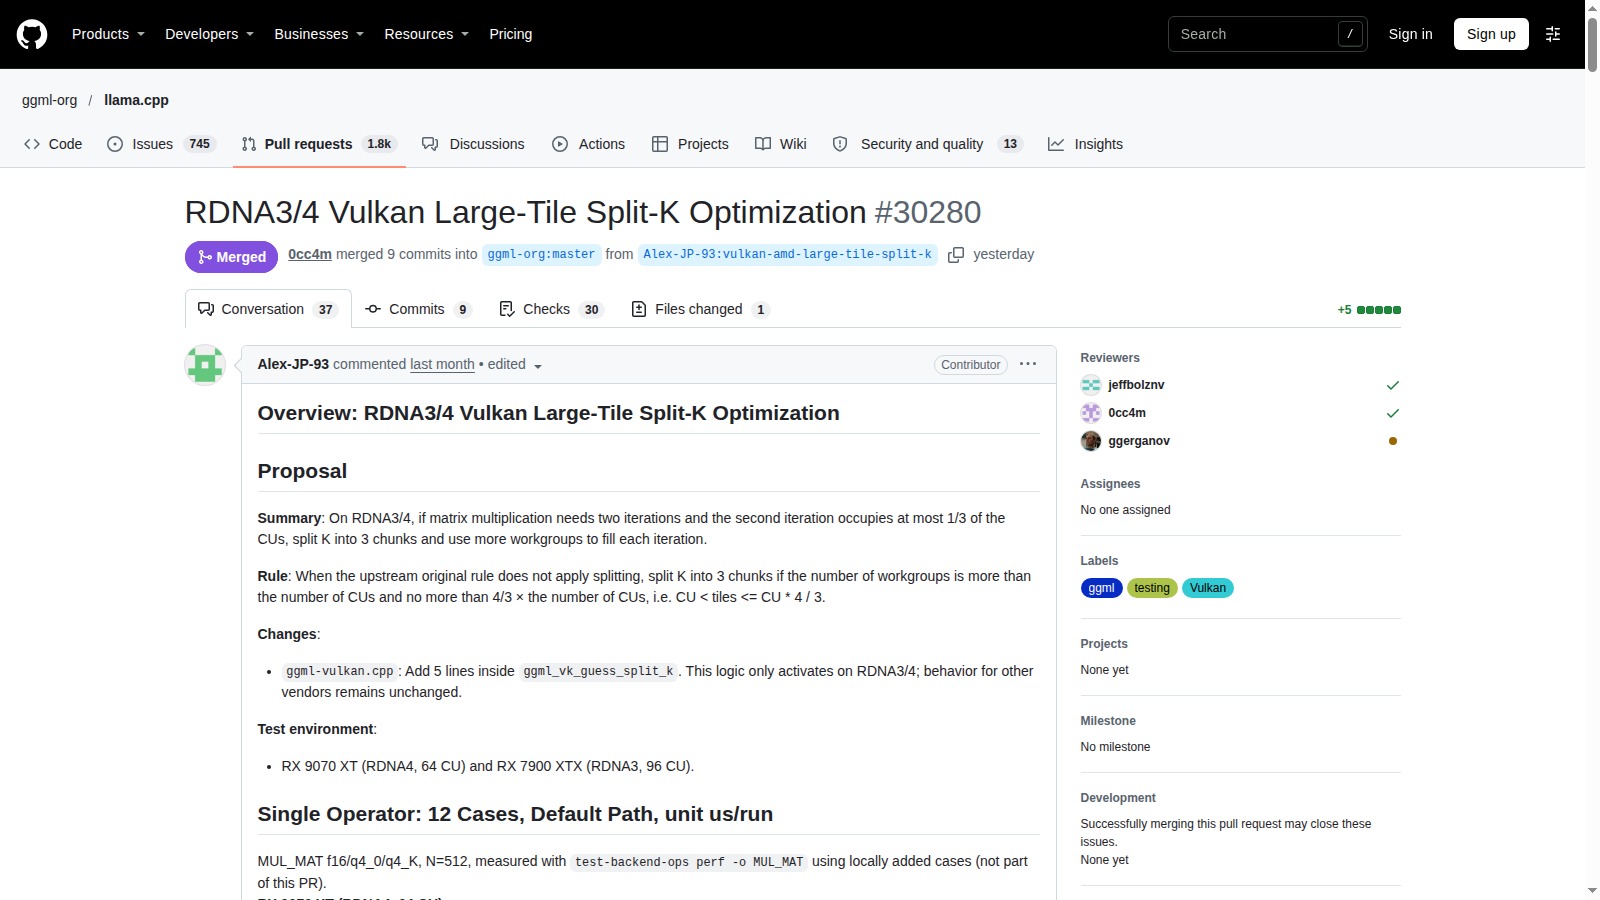
La PR 30280 è stata integrata il 5 novembre alle 13:11 italiane. Aggiunge una scelta Split-K specifica per AMD RDNA3 e RDNA4 nel backend Vulkan. I risultati del contributore includono prompt processing pp512 con benefici variabili e casi senza miglioramento: non sono una promessa di generazione più veloce. llama.cpp: PR 30280, merge e benchmark del contributore.
Limiti da conoscere
Limite: Verificati merge e diff, non una nuova release binaria. Nessuna compilazione o prova GPU eseguita qui. Le misure sono del contributore, con hardware e casi specifici; non si estendono automaticamente a ogni modello, driver o quantizzazione.
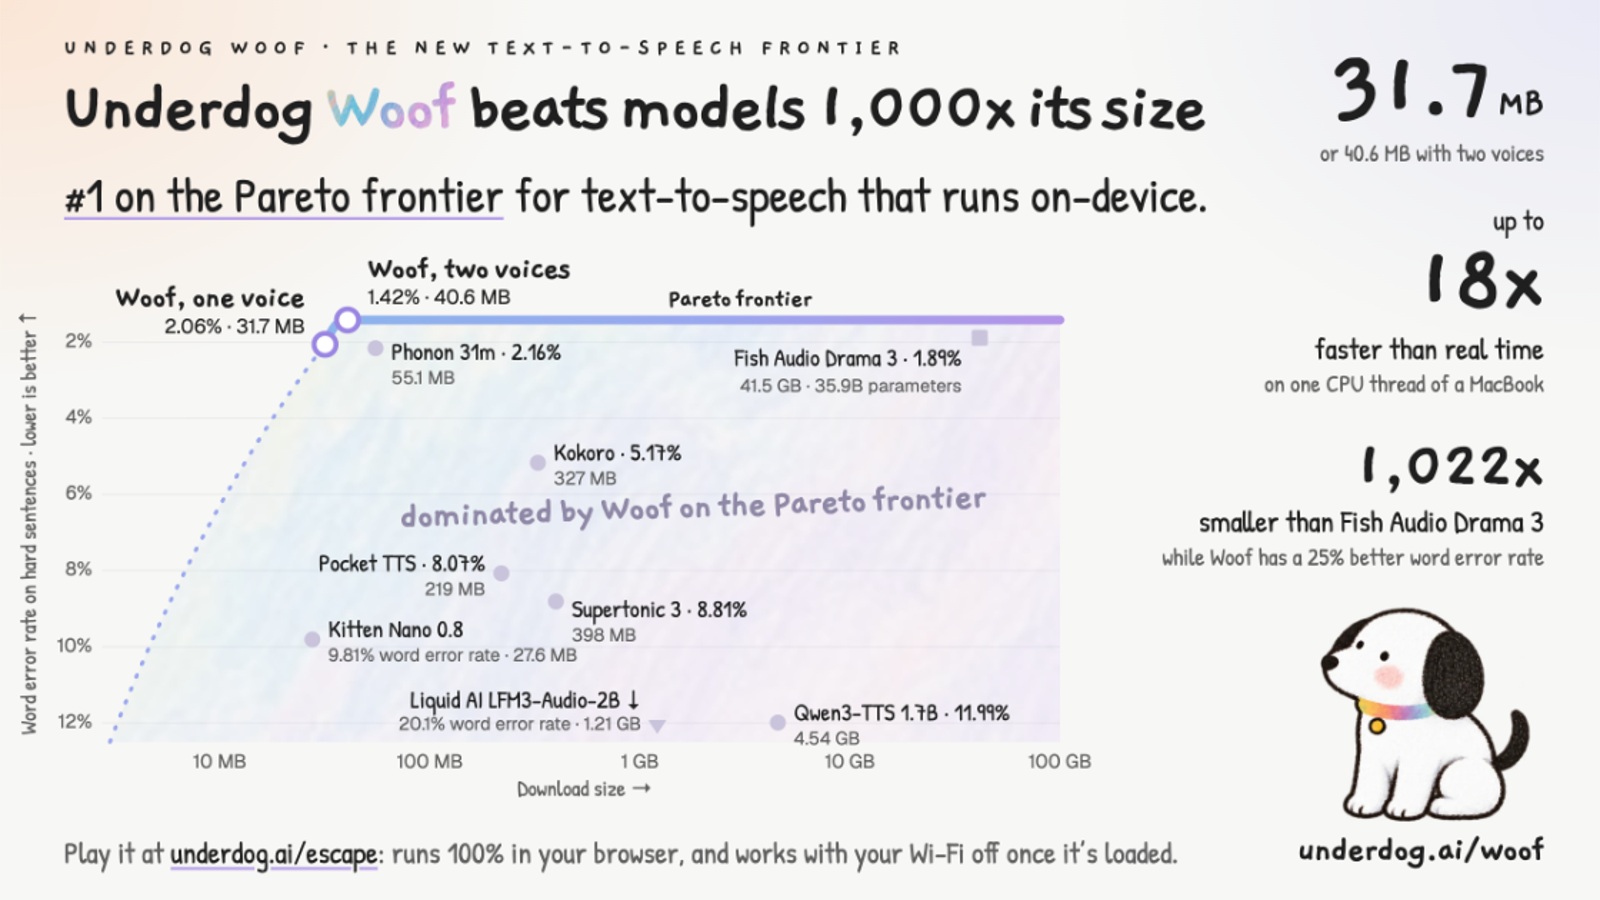
I primi pesi pubblici su Hugging Face risalgono al 5 novembre: Woof offre un TTS inglese a due voci da 40,6 MB con runtime NumPy su CPU. Non è il modello da 31,7 MB della demo a una voce. Il sito riporta una data del 26 ottobre: distinguiamo l’annuncio dalla disponibilità del repository verificata. Underdog Woof: model card e condizioni delle misure.
Limiti da conoscere
Limite: I pesi sono scaricabili, ma non con un permesso commerciale generale. Il repository distribuisce Underdog Non-Commercial License 1.0, mentre il sito cita CC BY-NC 4.0. Prestazioni, RAM e funzionamento offline sono dichiarazioni del produttore, non test di questo ciclo; il supporto documentato è inglese.
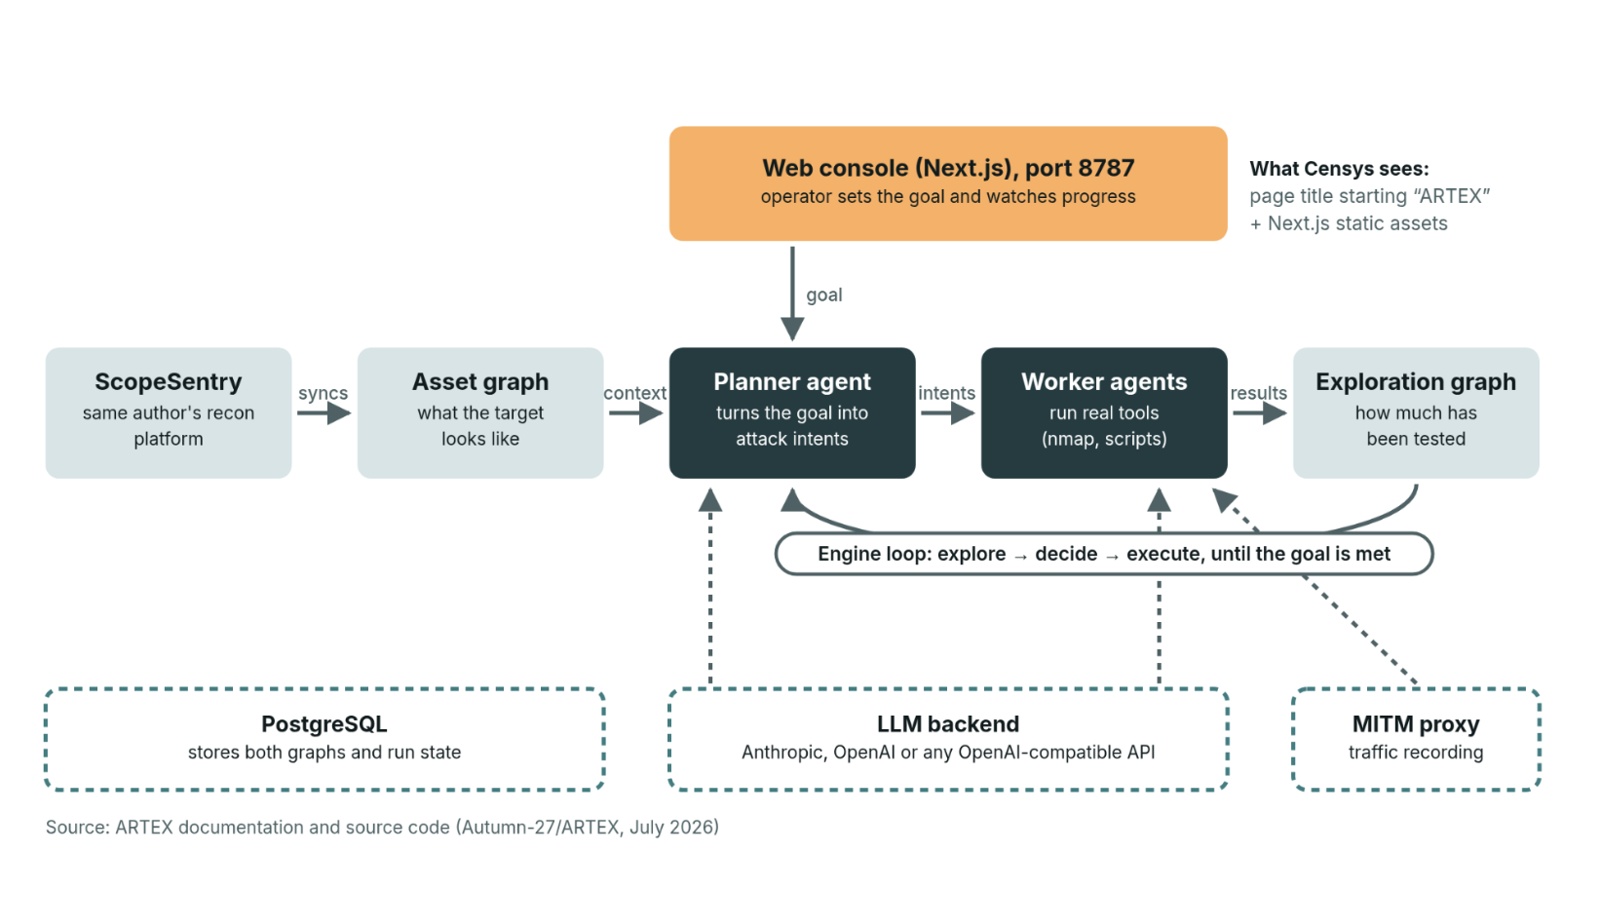
Nel rapporto del 5 novembre Censys osserva 1.465 host con console ARTEX esposta. Circa 650 ricadono in due insiemi di configurazioni uniformi, lasciando circa 815 deployment dall’aspetto distinto. Non sono 1.465 attacchi, vittime o operatori identificati; la fonte include possibili usi legittimi. Censys: ARTEX, Agentic Asbestos (5 novembre 2026).
Limiti da conoscere
Limite: Conteggio del fornitore non rimisurato. La sintesi data lo snapshot al 4 novembre, il corpo al 3 novembre: la discordanza resta aperta. Configurazioni simili non provano identità dell’operatore; una console esposta non prova un attacco riuscito.
Nei test degli autori, un picco breve lascia il servizio in crisi anche quando le nuove chiamate tornano sotto la capacità. Fermare un tentativo non impedisce al retry di creare un’altra esecuzione: budget e riaggancio delle richieste intervengono su questo passaggio, con conseguenze diverse sulle risposte consegnate.
Limiti da conoscere
Limite: Preprint del 5 novembre 2026, con vLLM 0.30.0, una H100 per run, tre modelli e carico sintetico. Non è una prova su n8n, su altri engine o su un servizio distribuito; non è stato eseguito un benchmark indipendente per questa analisi.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.