
L’ANALISI
OpenDecider trasforma scelte chiuse in probabilità eseguibili in locale
Analisi di OpenDecider 0.1.2, famiglia Apache 2.0 per classificare decisioni tipizzate su CPU, NVIDIA e Apple Silicon con benchmark riproducibili.
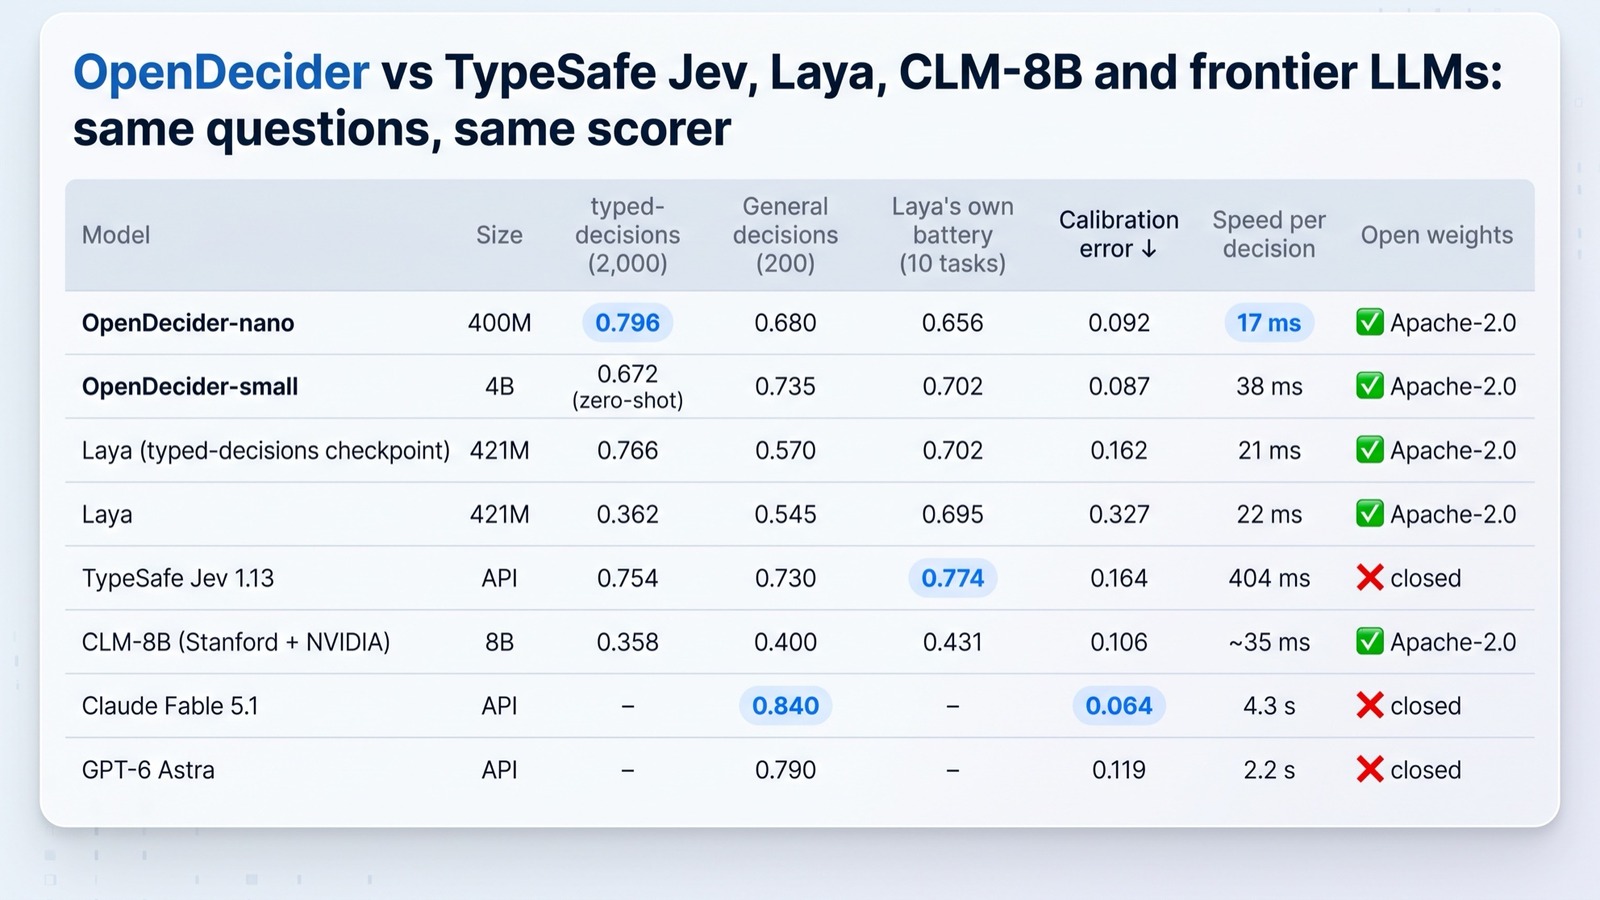
In breve: OpenDecider è una famiglia di modelli per decisioni a risposta chiusa: riceve uno stato e domande tipizzate, poi restituisce una probabilità per ogni opzione senza generare testo. La release 0.1.2 aggiunge il modello 30B-A3B, build MLX e caricamento multi-GPU. È adatto a routing e triage con opzioni note, ma non sostituisce un LLM generativo e i benchmark restano misure dell’autore.
Che cosa è stato pubblicato
La versione 0.1.2 distribuisce il pacchetto Python, i checkpoint nano, small e medium-td, build MLX e un notebook Colab. Codice e pesi sono dichiarati Apache 2.0. Nano usa Ettin Encoder 400M; le varianti maggiori derivano da Qwen3 4B e Qwen3 30B-A3B.
Come funzionano le decisioni tipizzate
L’applicazione invia uno stato e domande di tipo scelta, punteggio o sì/no. OpenDecider assegna probabilità alle opzioni definite nella richiesta e restituisce un oggetto strutturato. Nano usa marker per opzione in un singolo passaggio; le varianti Qwen elaborano una domanda alla volta.
Quale variante scegliere
Nano occupa circa 2 GiB in esecuzione e privilegia velocità e batch di molte domande. Small migliora le decisioni generali e dispone di build MLX a 8 e 4 bit. Medium-td arriva a 0,765 sui 200 casi generali dichiarati, ma richiede circa 61 GB di memoria GPU e non ha una build Mac completa.
Come leggere i benchmark
Il repository pubblica harness, manifest, predizioni e tabelle. Nano raggiunge 0,796 sul test typed-decisions dopo addestramento sul train split; small raggiunge 0,735 sui 200 casi generali zero-shot. Questi numeri sono verificabili nei file, ma sono prodotti e interpretati dallo stesso autore del progetto.
Condizioni e limiti
Le opzioni devono essere definite prima della chiamata e le probabilità non autorizzano automaticamente un’azione. Phishing è il compito più debole di OpenDecider, Jev guida la batteria applicativa di Laya e non esiste ancora una valutazione multilingue. Questo Radar non include un test end-to-end indipendente dei checkpoint.
Checklist per provarlo
- Definire un insieme chiuso di scelte e una politica di fallback.
- Partire da nano su CPU o GPU prima di giustificare una variante maggiore.
- Bloccare versione 0.1.2, checkpoint e dipendenze nel test.
- Separare un set di valutazione che non compare nei dati di addestramento.
- Misurare accuratezza, calibrazione, latenza e memoria sul proprio hardware.
- Verificare soglie e tasso di invio a revisione umana.
- Testare esplicitamente i casi in cui nessuna opzione è corretta.
- Non usare il benchmark dell’autore come prova di sicurezza in produzione.