
L’ANALISI
llama.cpp b11224 corregge un errore di calcolo nel backend Vulkan
Analisi della build b11224 di llama.cpp: cosa corregge nelle letture di cache e negli stride Vulkan, chi dovrebbe aggiornare e come verificare gli output.
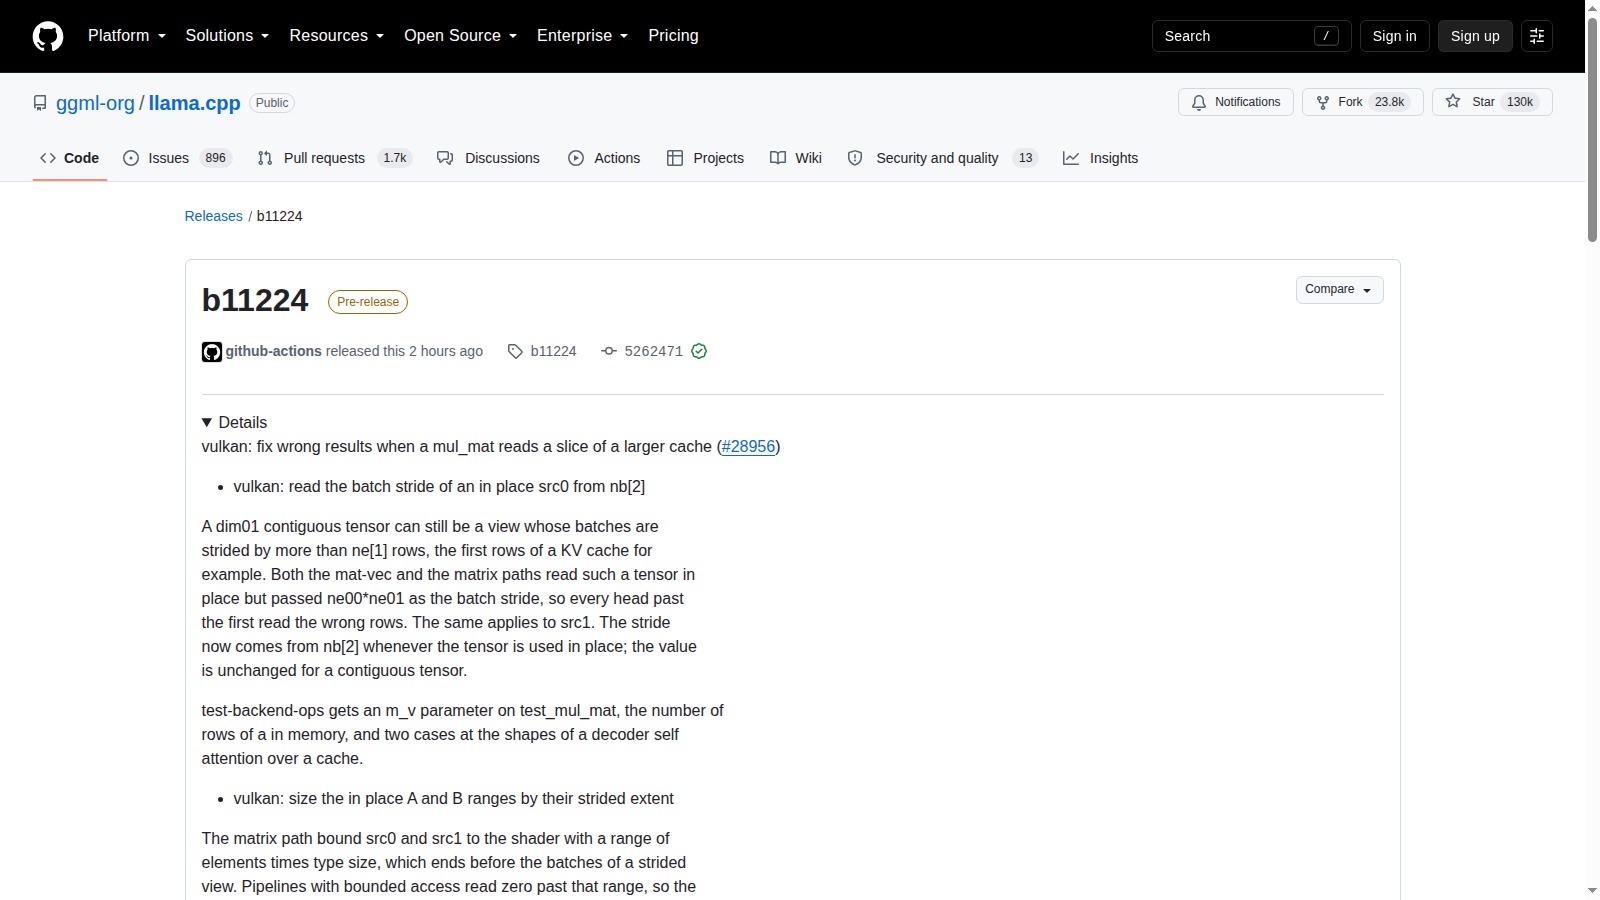
In breve: La build b11224 corregge più percorsi Vulkan che potevano leggere righe o intervalli sbagliati durante moltiplicazioni di matrici su viste strided e cache più grandi. Il risultato pratico è un rischio di output numericamente errati, non soltanto un rallentamento. Chi usa llama.cpp con Vulkan dovrebbe aggiornare e confrontare gli output prima e dopo su prompt e modelli rappresentativi.
Che cosa cambia nella build
La release b11224 corregge il calcolo dell’intervallo dei tensori letti in place e lo stride usato dal percorso a singolo token di mul_mat_id. Prima della modifica, una vista strided di esperti poteva leggere righe diverse da quelle richieste. La patch aggiunge un caso di test specifico.
Perché non è un semplice fix di prestazioni
La descrizione ufficiale parla di risultati errati: il problema interessa l’indirizzamento dei dati nella moltiplicazione, quindi un’esecuzione poteva completarsi senza segnalare il difetto. Un altro aggiustamento limita i descrittori dei buffer per evitare letture di residui di nodi precedenti e un blocco NVFP4 su NVIDIA senza coopmat2.
Chi è interessato
La correzione è pertinente a chi esegue llama.cpp attraverso Vulkan, in particolare con cache, viste strided, MoE o percorsi quantizzati. La release pubblica binari Vulkan per Ubuntu x64, Ubuntu arm64 e Windows x64. Gli utenti esclusivamente CPU, CUDA, ROCm o Metal non devono attribuire automaticamente a questo bug eventuali differenze.
Come verificare l’aggiornamento
Il confronto utile non è solo la velocità. Occorre bloccare modello, quantizzazione, seed e parametri, eseguire lo stesso set di prompt con la build precedente e b11224, quindi confrontare token, logit o output strutturati. I test upstream riducono il rischio di regressione ma non sostituiscono la verifica sul proprio hardware.
Condizioni e limiti
La release non quantifica la frequenza del difetto né fornisce una lista completa di GPU o modelli colpiti. Non c’è in questo Radar una riproduzione indipendente su AMD o NVIDIA. Aggiornare è prudente per chi usa Vulkan, ma non dimostra che ogni output storico fosse errato.
Checklist per provarlo
- Annotare build precedente, commit, backend Vulkan e driver GPU.
- Bloccare modello, file GGUF, quantizzazione, seed e parametri di campionamento.
- Salvare un piccolo set di prompt e output di riferimento prima dell’aggiornamento.
- Installare b11224 dai binari ufficiali o compilare lo stesso commit.
- Ripetere i casi su singolo token, cache lunga e modelli MoE quando pertinenti.
- Confrontare output e logit, non soltanto token al secondo.
- Controllare errori, blocchi e uso di memoria nei log Vulkan.
- Conservare la vecchia build per rollback se emerge una regressione.