
L’ANALISI
VeriLoop E2 27B: pesi aperti, GGUF e limiti delle prove pubblicate
VeriLoop E2 è un post-training 27B scaricabile con contesto 262K e pacchetto di valutazione. Cosa si può eseguire, quali risultati sono ispezionabili e cosa resta da verificare.
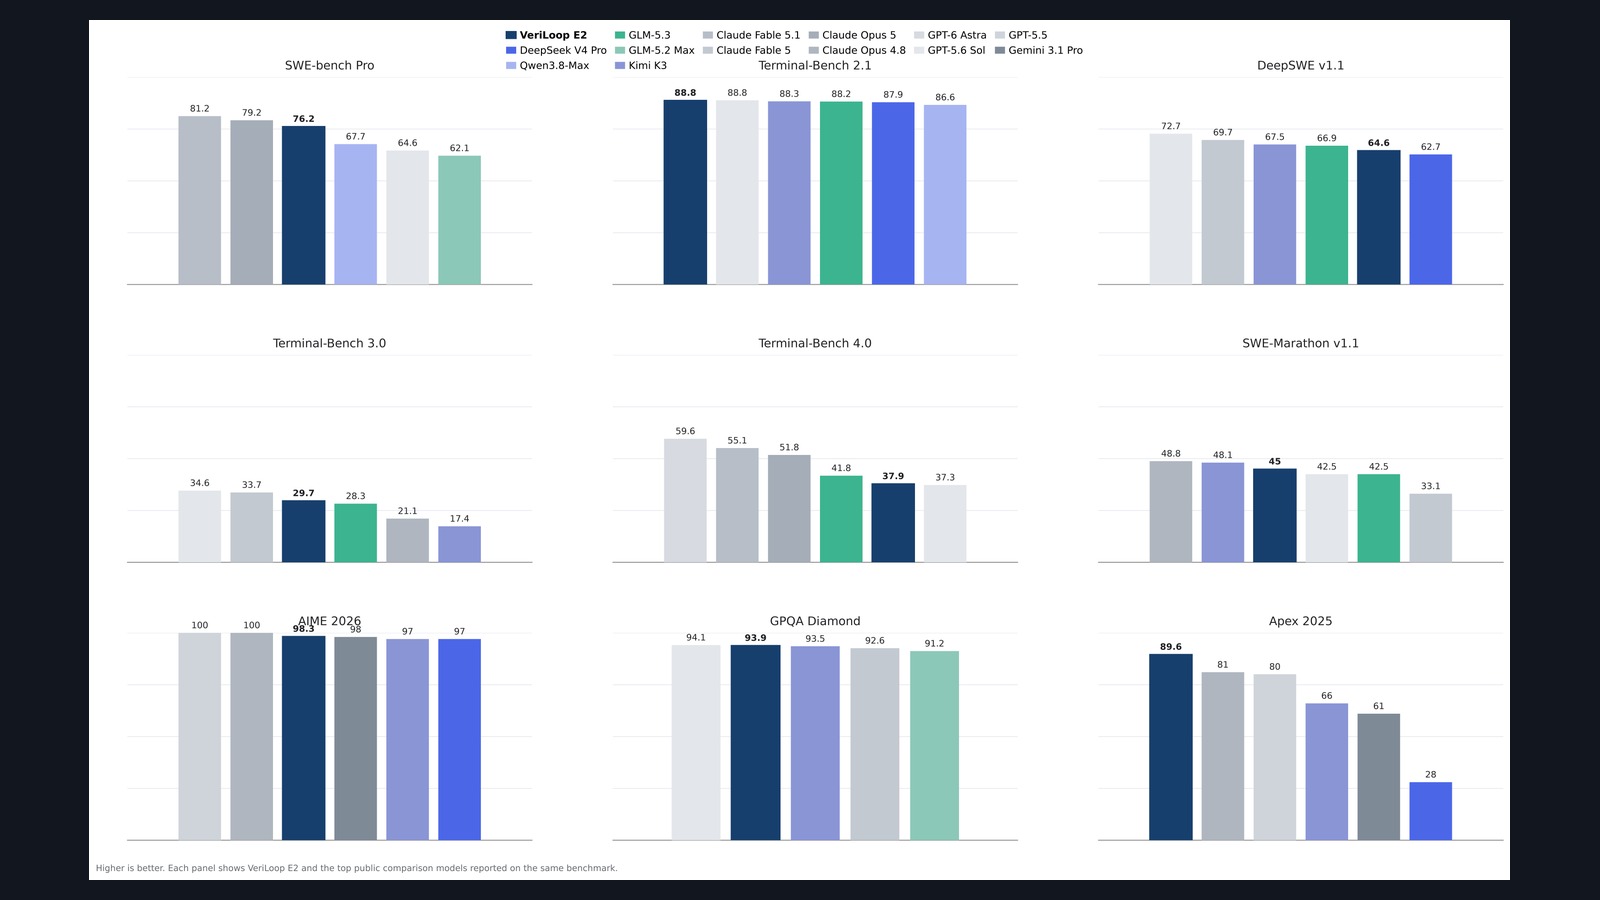
In breve: VeriLoop E2 è oggi scaricabile in BF16 e tramite quantizzazioni GGUF, con licenza Apache 2.0 e configurazione vLLM documentata. Il rilascio è più verificabile di una semplice tabella perché include output e ricevute per diversi benchmark, ma i punteggi agentici appartengono alla configurazione completa valutata: l’harness di produzione non è incluso e serve una replica indipendente.
Che cosa viene pubblicato
Il rilascio comprende un checkpoint da circa 28 miliardi di parametri derivato da Qwen3.8-27B, file Safetensors, tokenizer e configurazione con contesto nativo di 262.144 token. La scheda indica Apache 2.0 e collega anche due raccolte GGUF, quindi il delta riguarda sia la disponibilità dei pesi sia percorsi di inferenza più accessibili.
Come funziona la verifica ricorsiva
Il progetto descrive VeriLoop-Governed Recurrence: il modello propone soluzioni e correzioni, mentre un harness separato ammette le evidenze, esegue controlli, decide commit o rollback e applica le condizioni di arresto. Questa separazione è interessante per gli agenti tecnici perché evita che il modello certifichi da solo i propri progressi.
Che cosa mostrano le evidenze
La scheda riporta risultati su SWE-bench Pro, Terminal-Bench, AIME, GPQA e altri test, con collegamenti a directory di evidenza per gran parte dei punteggi. È un passo utile per l’ispezione, ma i confronti restano prodotti dal laboratorio e alcuni valori dipendono dalla configurazione completa con strumenti e harness.
Come eseguirlo oggi
Il percorso documentato usa vLLM 0.17.0 e una lunghezza validata di 131.072 token, inferiore al massimo nativo dichiarato. Le quantizzazioni GGUF permettono prove con llama.cpp, ma memoria, cache KV, template e qualità alle precisioni più basse devono essere misurati sul dispositivo reale.
Limiti e condizioni
L’implementazione di produzione dell’harness non è inclusa nel repository del modello. Dati di post-training e protocolli sono descritti nel report, ma il rilascio non equivale a una replica indipendente. Le dimostrazioni scientifiche hanno inoltre confini espliciti e non vanno generalizzate oltre i certificati pubblicati.
Checklist per una prova riproducibile
- Registrare revisione del checkpoint, formato e checksum dei file scaricati.
- Partire dalla configurazione vLLM validata a 131K prima di tentare 262K.
- Confrontare BF16 e una quantizzazione GGUF sullo stesso set di prompt.
- Separare qualità del checkpoint, template e comportamento dell’harness.
- Riprodurre almeno un task pubblico usando output ed evaluator del pacchetto di evidenza.
- Misurare RAM o VRAM, cache KV, prefill, generazione e stabilità sul proprio hardware.
- Non usare i punteggi dichiarati come prova del checkpoint isolato senza replicare strumenti e protocollo.