
IL PUNTO SULL’AI
25 settembre 2026
Ollaya porta i modelli decisionali su desktop, mentre GitHub amplia il contesto del coding agent e vLLM e SGLang affrontano un rischio RoPE.
In questa edizione 7 notizie
Liquid AI pubblica il drafter sperimentale LFM2.5-VL-3B-DSpark in Safetensors e GGUF, con supporto per MLX-VLM, llama.cpp e SGLang. Nei test del produttore accelera la decodifica fino a 3,13 volte e l’esecuzione end-to-end fino a 2,62 volte su Apple Silicon.
Limiti da conoscere
Limite: Le misure sono prodotte da Liquid AI a batch 1 e temperatura zero su H100 80 GB, M5 Max e M3 Ultra. Il vantaggio varia per task e runtime; il modello è sperimentale, aggiunge circa 280 milioni di parametri e non è ancora servito dagli Inference Provider di Hugging Face.
Anthropic avvia sui piani Team il rollout dei connettori personali in Claude Tag: una richiesta nel canale può combinare le connessioni condivise dell’agente con calendario, Drive, CRM o altri strumenti accessibili solo all’utente che la invia.
Limiti da conoscere
Limite: Claude Tag è in beta e la funzione è disponibile solo per un numero limitato di organizzazioni. Enterprise seguirà, ma Anthropic non indica ancora una data; non abbiamo eseguito un test end-to-end su un account abilitato.
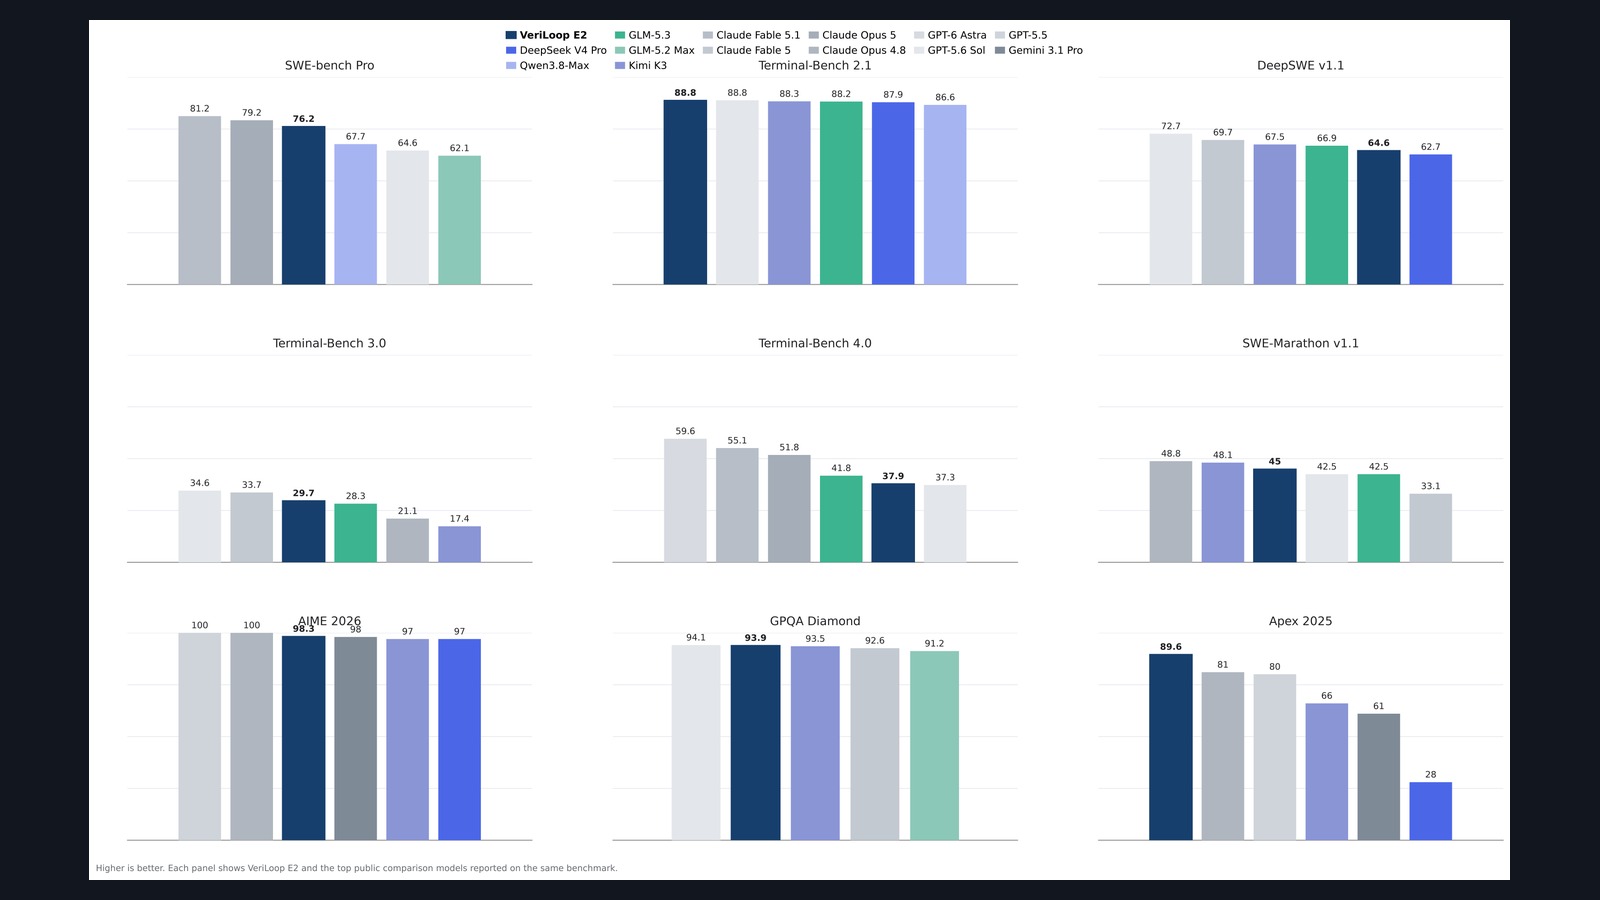
Tsinghua SIGS Robot Lab rende scaricabile VeriLoop E2, post-training Apache 2.0 di Qwen3.8-27B con contesto nativo da 262K token, checkpoint BF16, quantizzazioni GGUF e un pacchetto pubblico di evidenze per i benchmark.
Limiti da conoscere
Limite: I risultati sono dichiarazioni del laboratorio e descrivono il sistema valutato, che in alcuni test usa un harness interno non pubblicato. Il checkpoint da solo non garantisce gli stessi punteggi; non abbiamo riprodotto benchmark o contesto lungo su hardware indipendente.
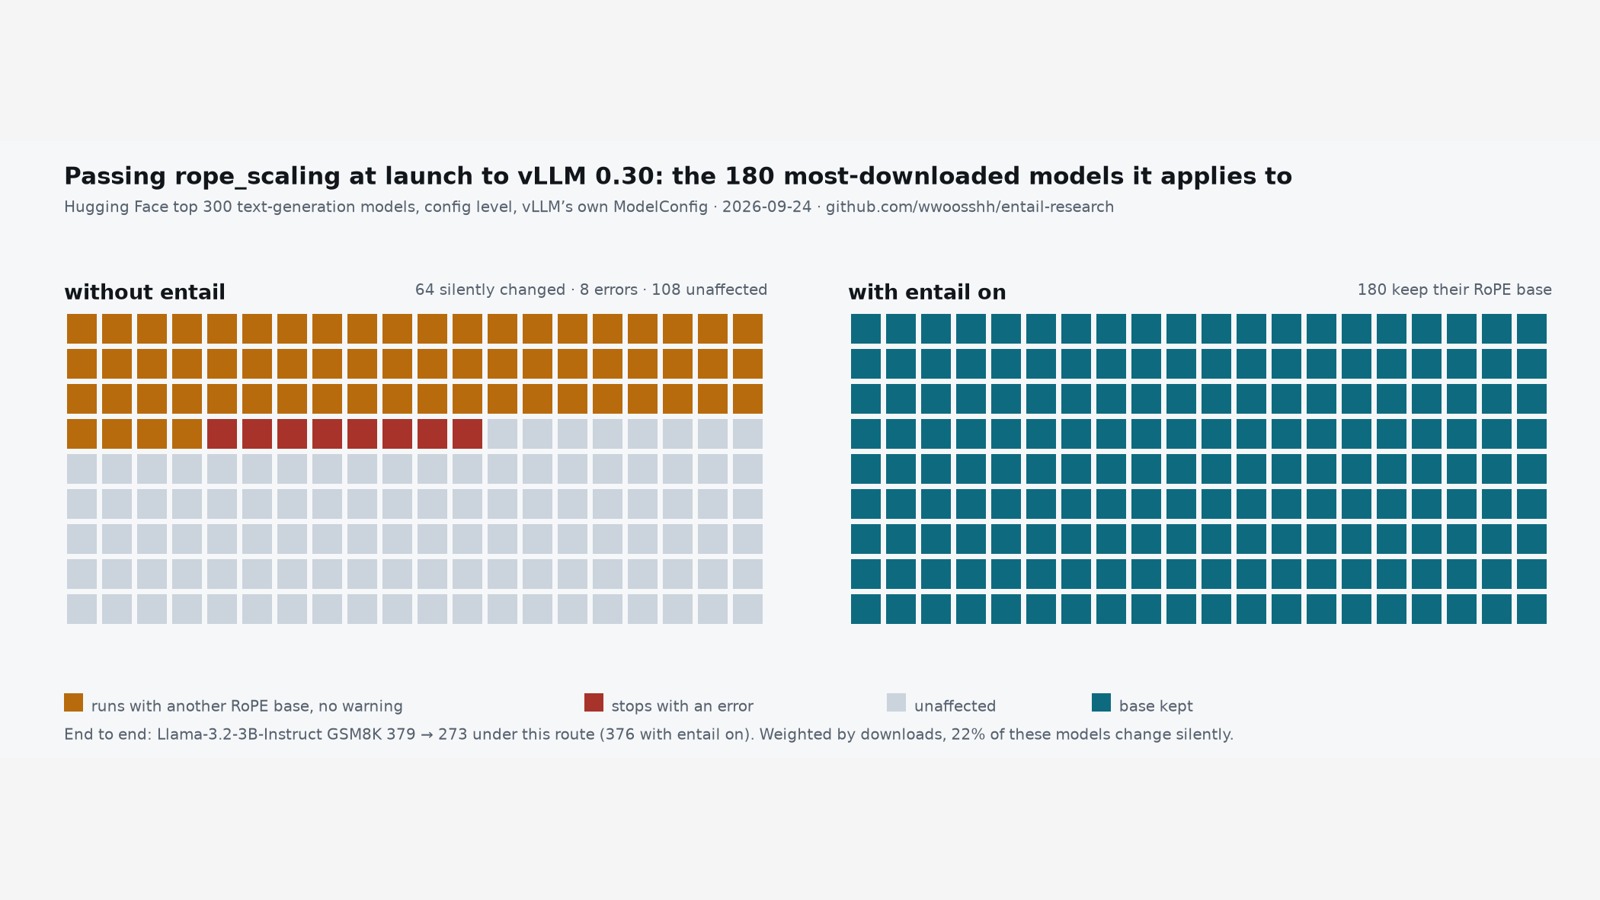
Due issue riproducibili mostrano che, con Transformers v5, alcuni override runtime di rope_scaling possono perdere rope_theta e far ricadere il motore sulla base 10000, mantenendo output fluenti ma peggiorando i risultati.
Limiti da conoscere
Limite: Le issue sono aperte e i benchmark provengono dallo stesso autore del report: il difetto non riguarda ogni esecuzione vLLM o SGLang, ma il percorso specifico di override a runtime sui modelli senza fallback corretto.
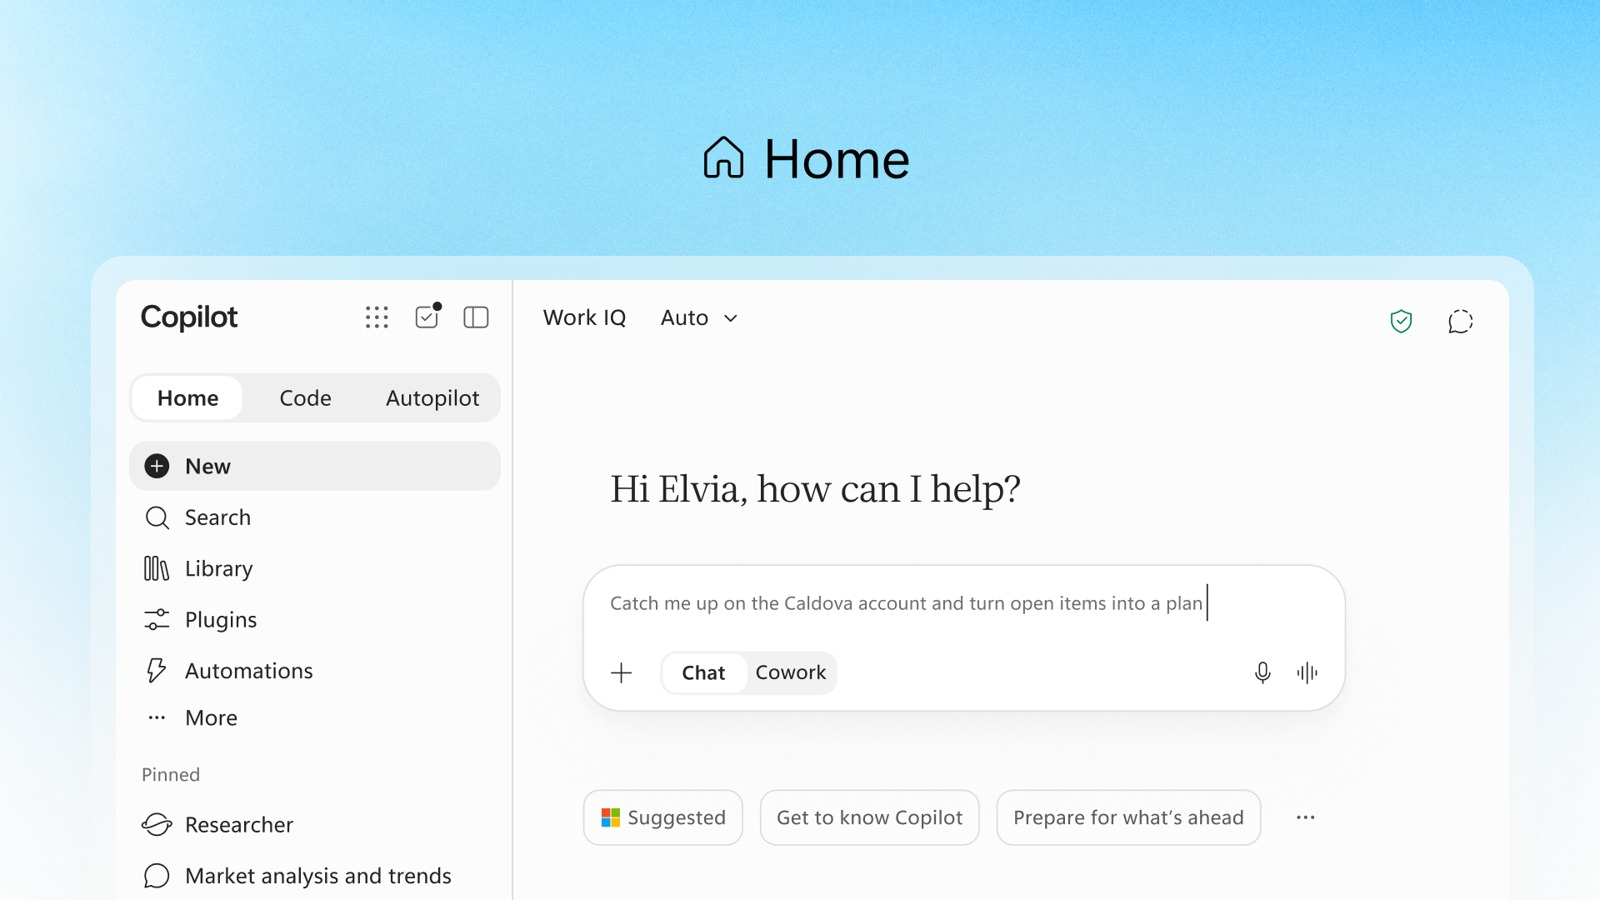
Microsoft presenta un’unica esperienza Copilot con una Home per il lavoro, Code per costruire soluzioni usando la tecnologia di GitHub Copilot e Autopilot per eseguire attività più lunghe, con Excel e PowerPoint integrati.
Limiti da conoscere
Limite: L’annuncio descrive capacità e interfaccia del fornitore, ma non fornisce ancora in questa pagina prezzi, disponibilità dettagliata per ogni piano o prove indipendenti sulla qualità delle attività autonome.
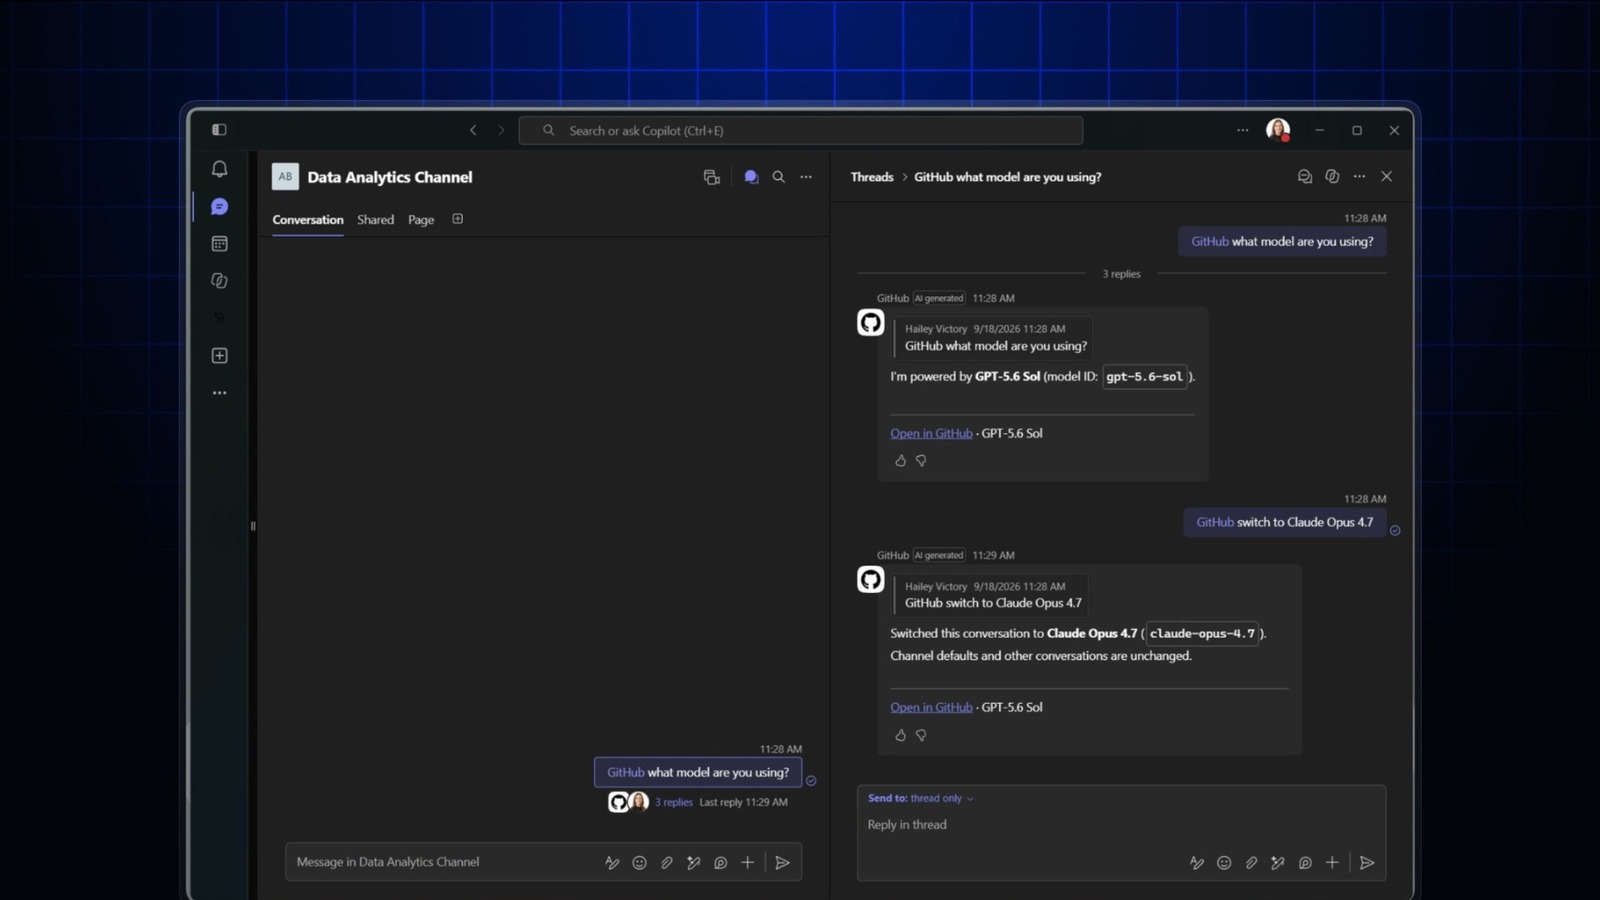
GitHub amplia la preview di Copilot per Slack e Microsoft Teams: file, allegati, immagini e cronologia possono alimentare il coding agent, che controlla issue simili, mantiene i link alla discussione e permette di cambiare modello nella conversazione.
Limiti da conoscere
Limite: La preview richiede Copilot Business o Enterprise, policy amministrative e installazione dell’app GitHub. Alcune funzioni sono in rollout graduale, consumano gli entitlement esistenti e l’esecuzione resta nel cloud agent con cloud sandbox, non nel workspace locale.
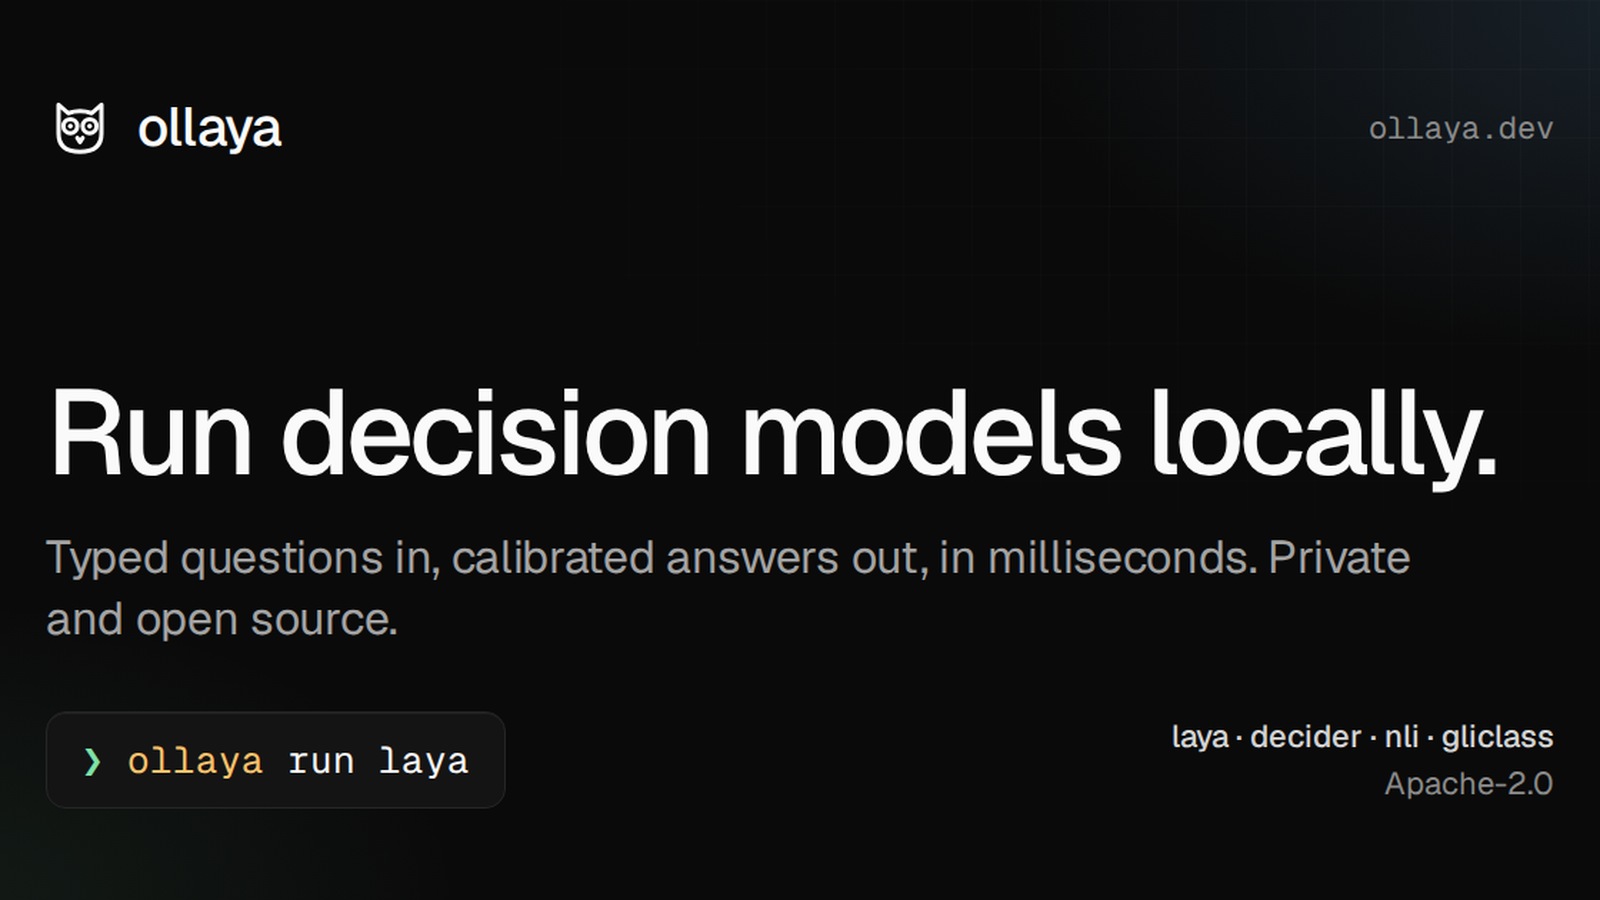
Ollaya 0.5 distribuisce un runtime Apache 2.0 per eseguire in locale modelli decisionali open weight: aggiunge app desktop e supporto Windows, espone API compatibili con TypeSafe e offre pacchetti Linux, macOS, Windows e Docker.
Limiti da conoscere
Limite: Le latenze di 8-10 ms, la calibrazione e i confronti con Jev sono misure dichiarate dal progetto su RTX 4090 e propri set di test, non una replica indipendente. Su macOS, AMD e Intel l’inferenza resta CPU; CUDA richiede driver NVIDIA R580 o successivi.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.