
IL PUNTO SULL’AI
9 novembre 2026
Claude e Muse ampliano gli accessi, Ollama corregge gli input. Strands confronta i costi dei ticket; Fireworks aggiorna il perimetro dei dati.
In questa edizione 16 notizie
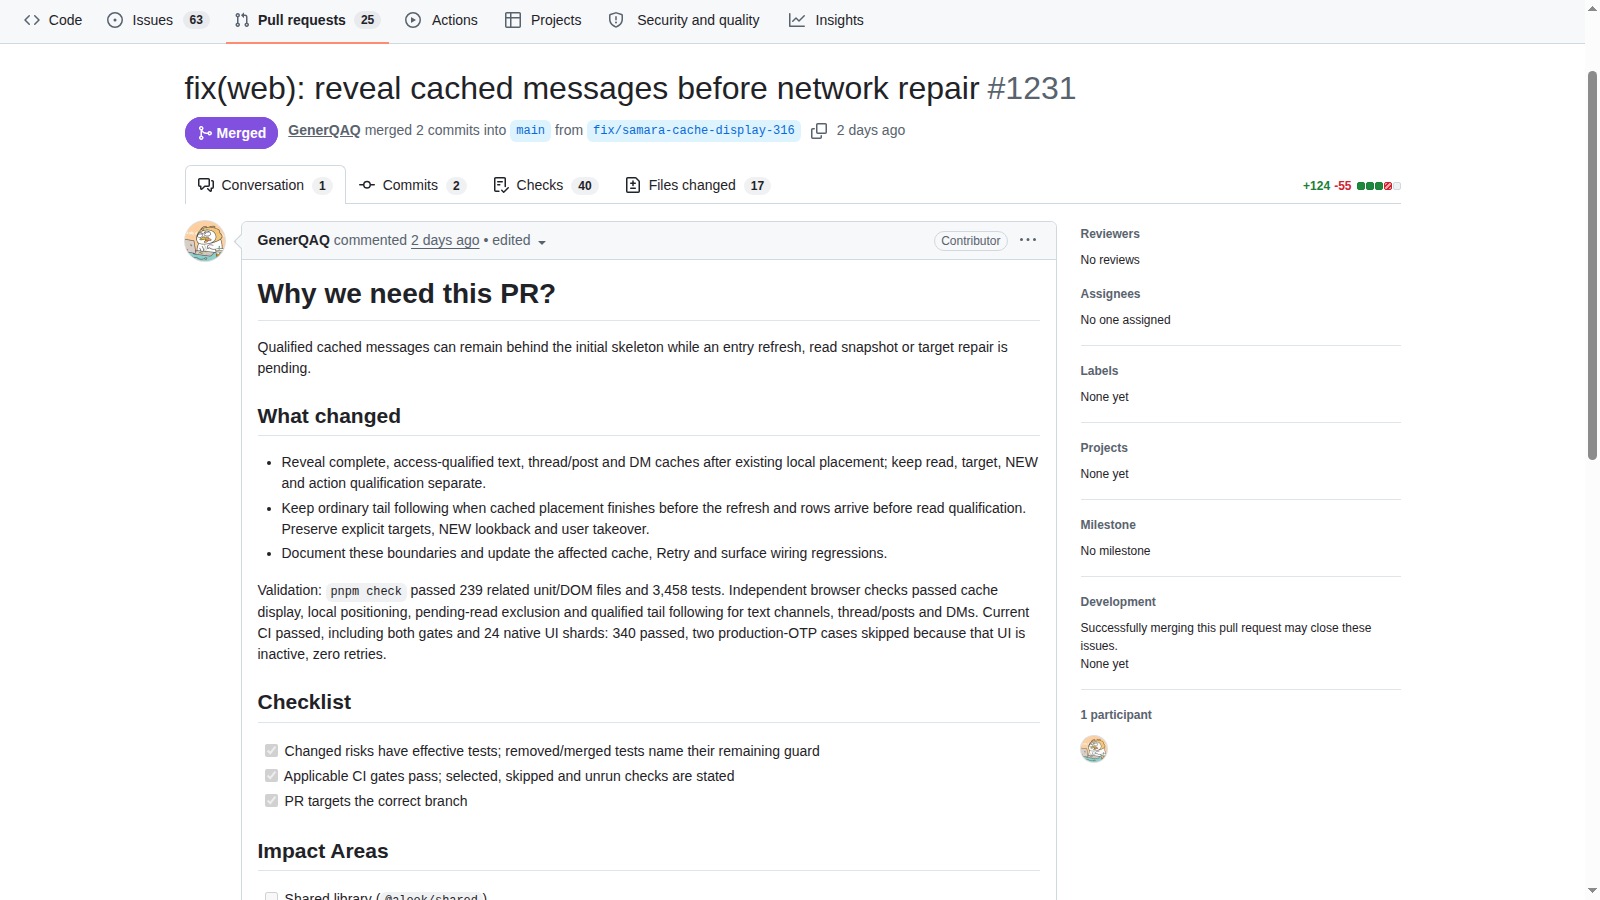
La release 0.1.66 include una correzione del client web: le cache complete e già qualificate per l’accesso possono comparire dopo il posizionamento locale, anche se aggiornamento iniziale, stato di lettura o recupero del messaggio di destinazione sono ancora in attesa. Visualizzare i messaggi e autorizzare le azioni restano due verifiche diverse.
Limiti da conoscere
Limite: La PR interessa l’app web. Serve una cache completa e qualificata per l’accesso; una cache presente non basta a rendere disponibili tutte le azioni. Nessuna verifica indipendente di installazione, sincronizzazione o uso offline completo.
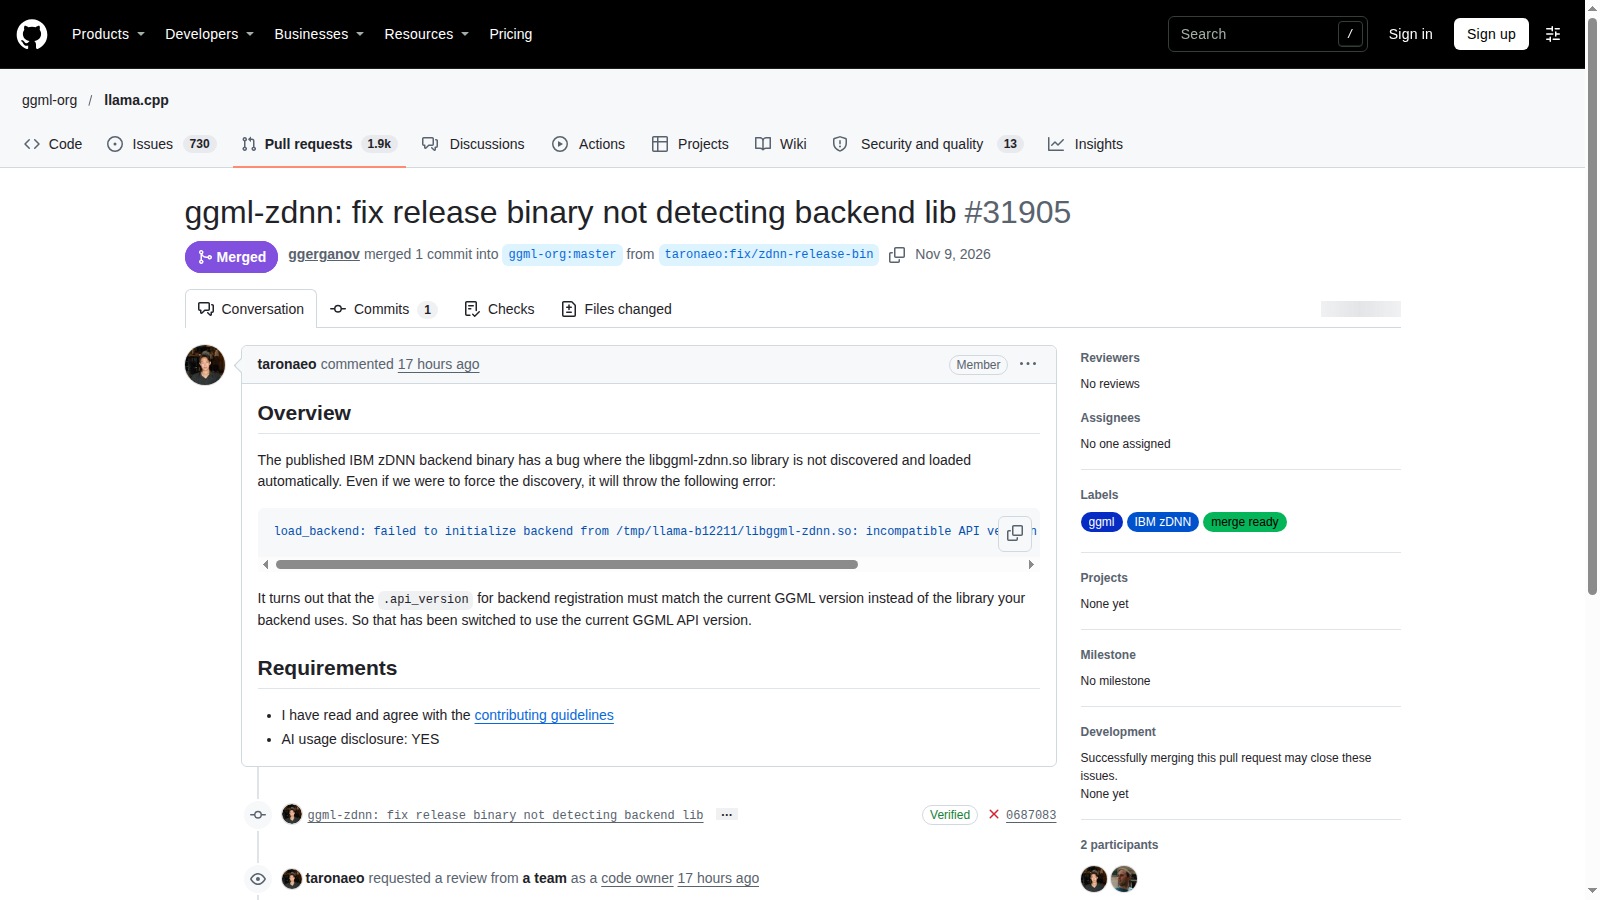
La build b12212 del 9 novembre integra la PR che ripristina la scoperta automatica di libggml-zdnn.so e allinea la registrazione alla versione API di GGML. Riguarda IBM zDNN, non AMD ZenDNN: chi usa quel backend può verificare se il binario ora lo inizializza, senza dedurre aumenti di velocità.
Limiti da conoscere
Limite: Build marcata pre-release. La correzione riguarda IBM zDNN; nessun test indipendente su IBM Z o LinuxONE e nessun aumento di prestazioni misurato.
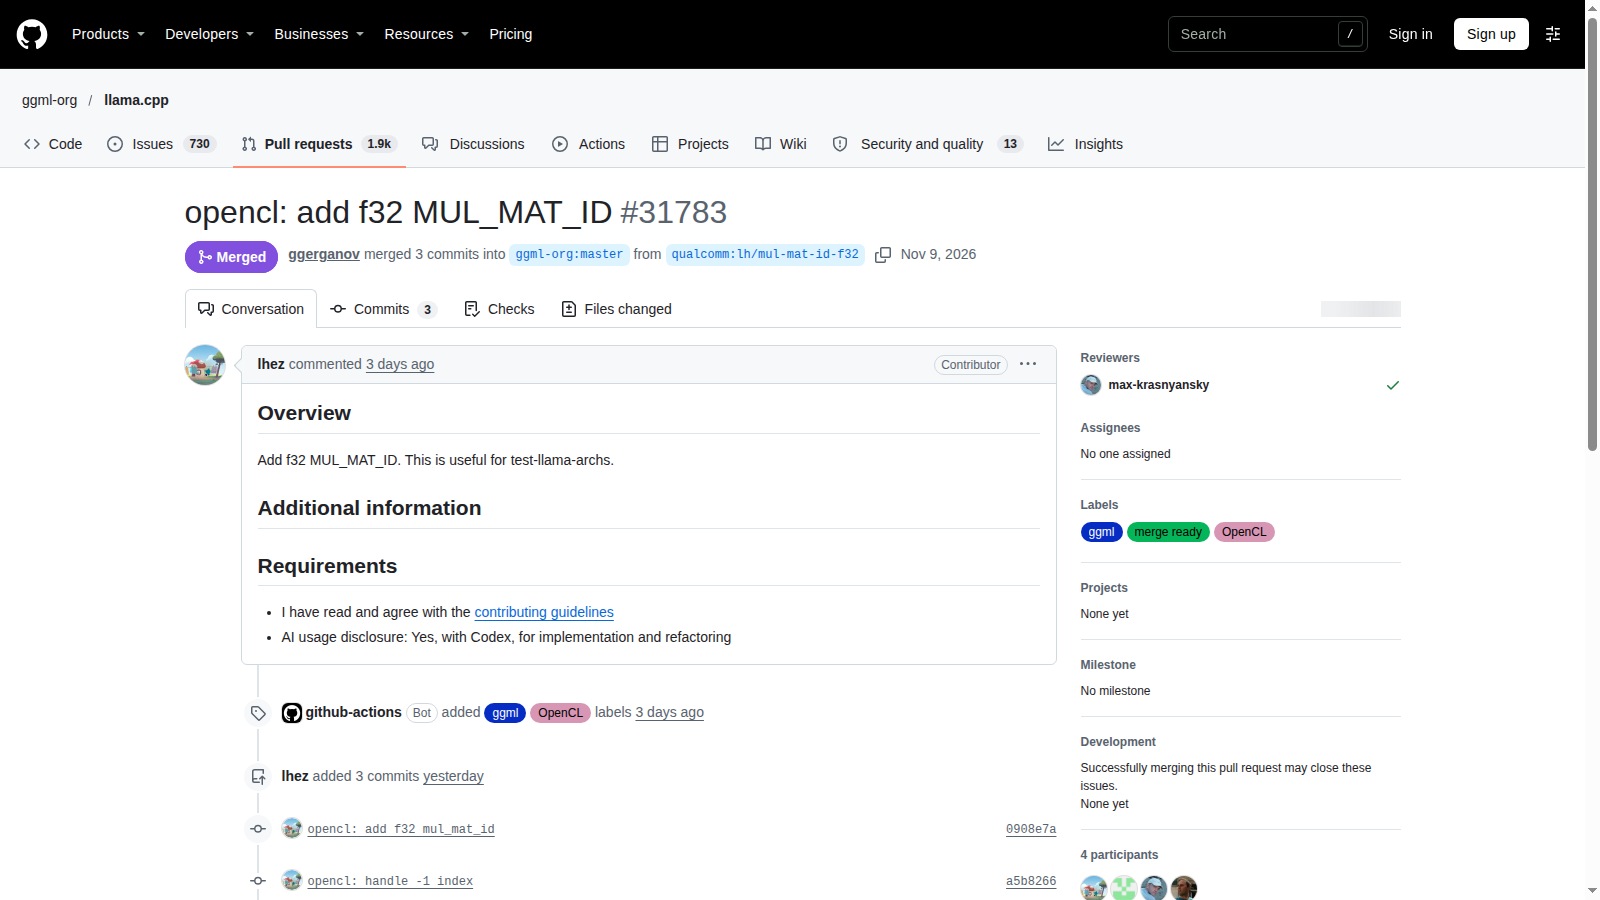
La PR OpenCL integrata il 9 novembre introduce percorsi F32 per MUL_MAT_ID, aggiunge la gestione dell’indice -1 e rende generale il caricamento di moe_sort_by_expert. L’autore indica l’utilità per test-llama-archs: è copertura funzionale verificabile nel codice, non una promessa di accelerazione dei modelli quantizzati.
Limiti da conoscere
Limite: Nessun benchmark indipendente, nessuna misura di velocità e nessuna garanzia per ogni GPU o modello. Pagina del tag verificata; stato stable della release non attestato dall’API.
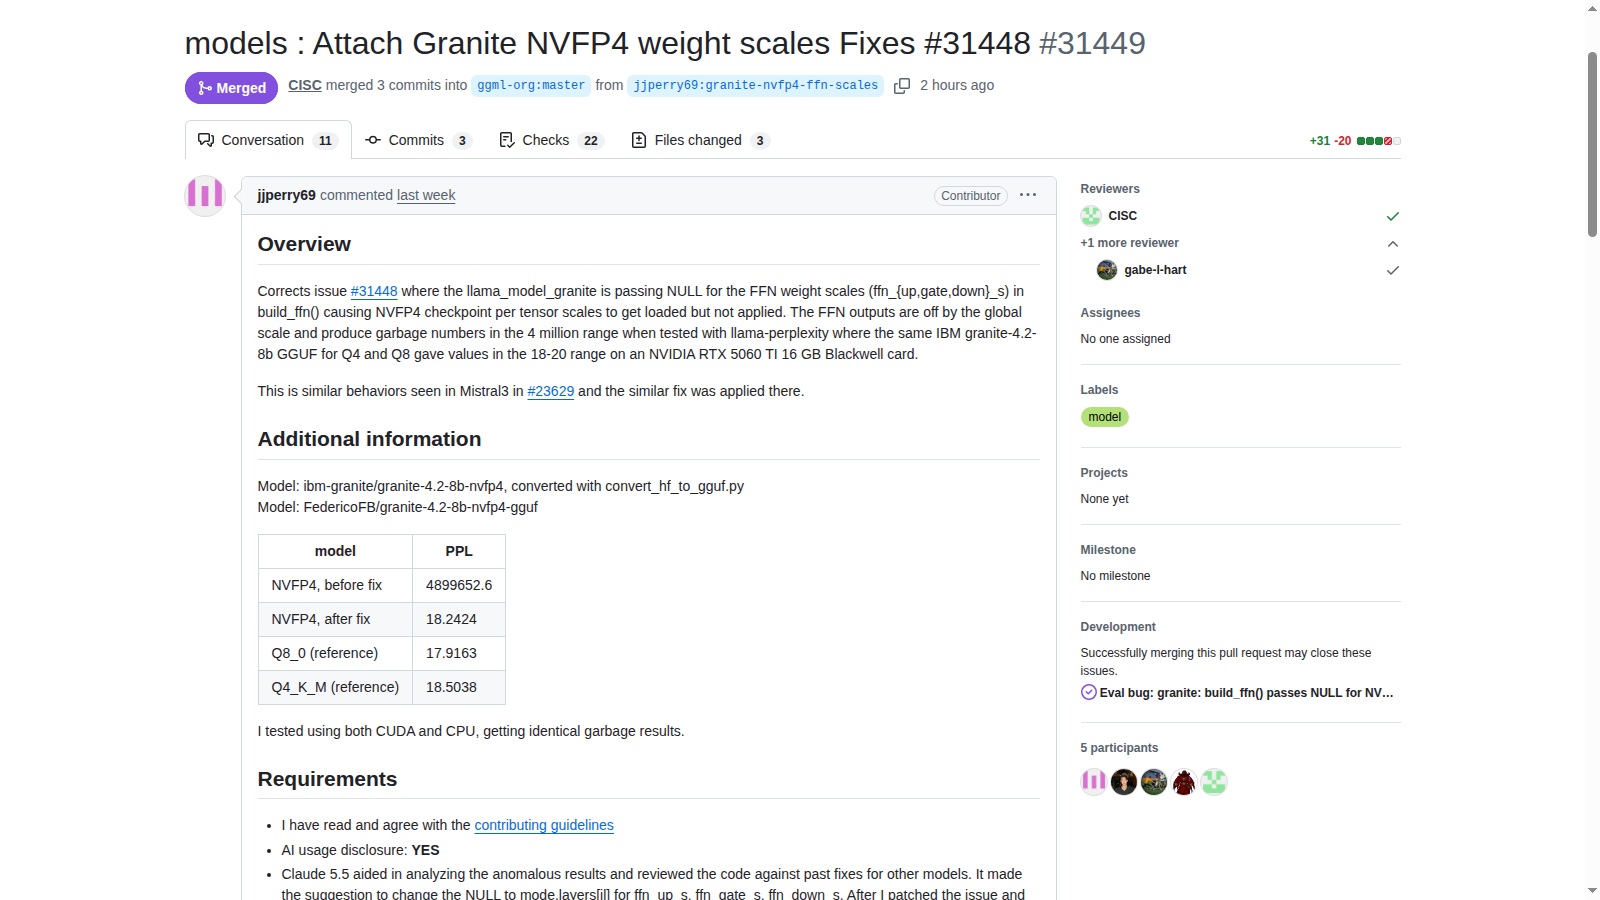
La build b12223 del 9 novembre integra la PR 31449: le scale NVFP4 dei pesi FFN, caricate ma non applicate nei percorsi interessati di Granite, vengono collegate al calcolo. La modifica coinvolge tre file di architettura. È una correzione di correttezza numerica, non il lancio di un checkpoint né una promessa di maggiore velocità.
Limiti da conoscere
Limite: b12223 è marcata pre-release, non stable; esiste già b12224. La perplexity riportata appartiene all'autore della PR: nessuna replica indipendente o misura di velocità.
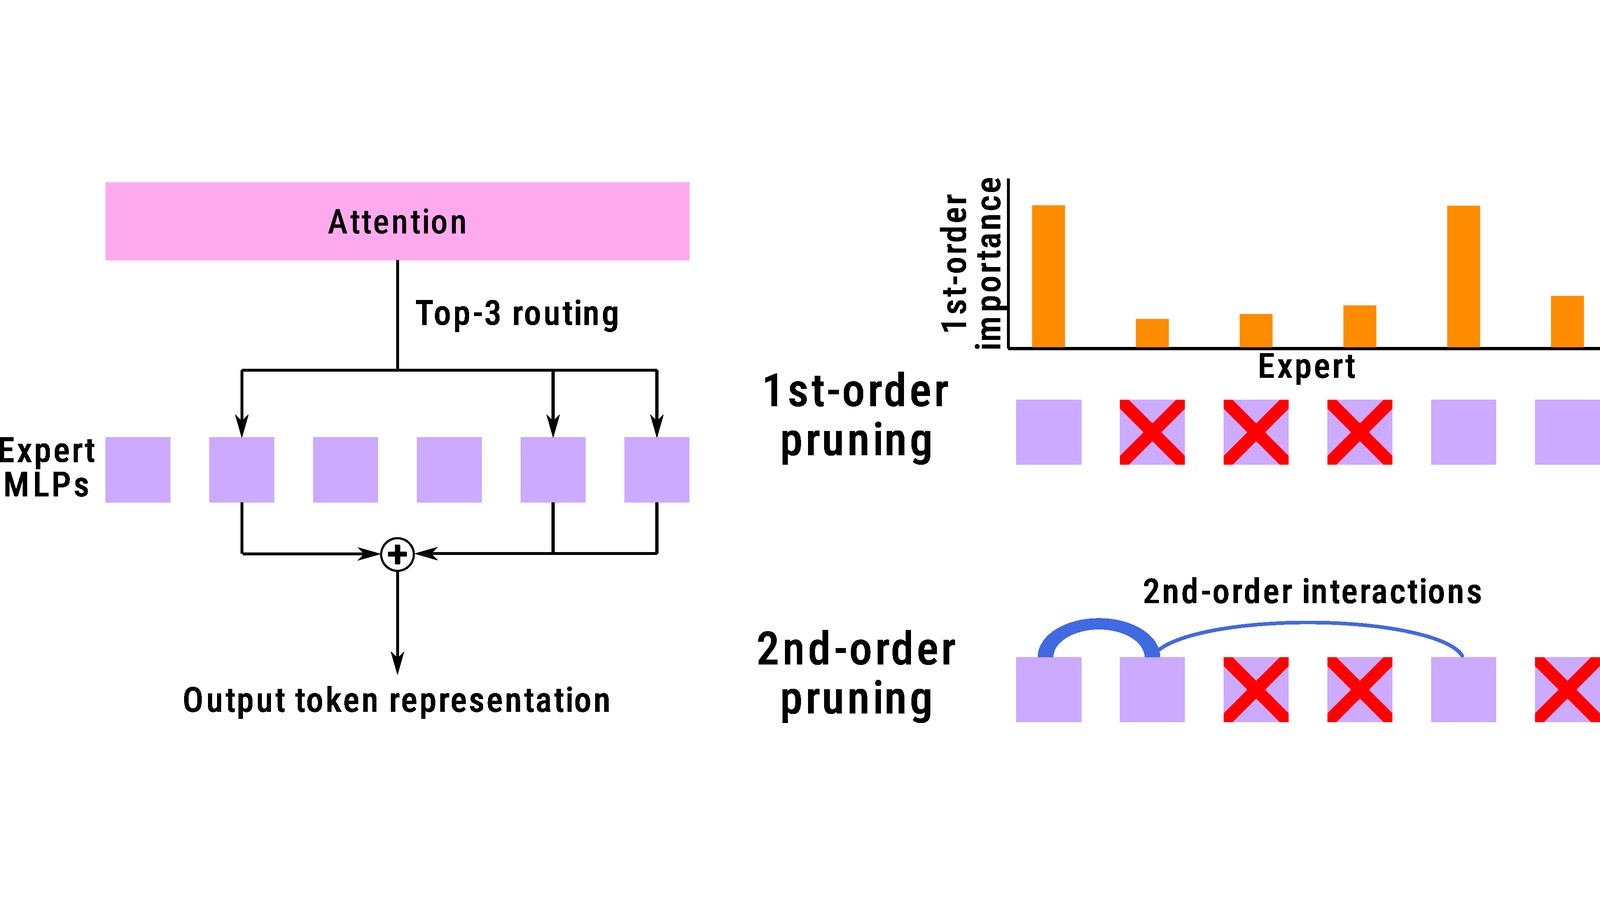
Il nuovo tutorial Amazon su Hugging Face illustra HOPE, che considera interazioni fra coppie di esperti invece di valutarli solo separatamente. Il repository espone la pipeline calibrazione, selezione e pruning per produrre un checkpoint Hugging Face. Il paper è di settembre: la novità del 9 novembre è la spiegazione operativa, non un nuovo modello rilasciato oggi.
Limiti da conoscere
Limite: Paper v1 del 16 settembre, non nuova ricerca di oggi. Risultati degli autori; compatibilità limitata dal layout degli esperti, nessuna prova propria di qualità, memoria o integrazione llama.cpp.
Automattic apre Spacefast al pubblico dopo il soft launch di settembre. Il servizio fornisce hosting, database SQL e versioni raggiungibili con URL permanenti all’agente già scelto dall’utente. API, CLI e MCP sono interfacce dell’infrastruttura: Spacefast non si presenta come un nuovo AI builder. La protezione dell’accesso a uno spazio va distinta dal login interno a un’app.
Limiti da conoscere
Limite: L’annuncio definisce il login nelle app in arrivo; il setup lo indica in Private Beta insieme alle email transazionali. Non sono una garanzia di disponibilità generale. Nessun nostro test operativo o confronto di costo.
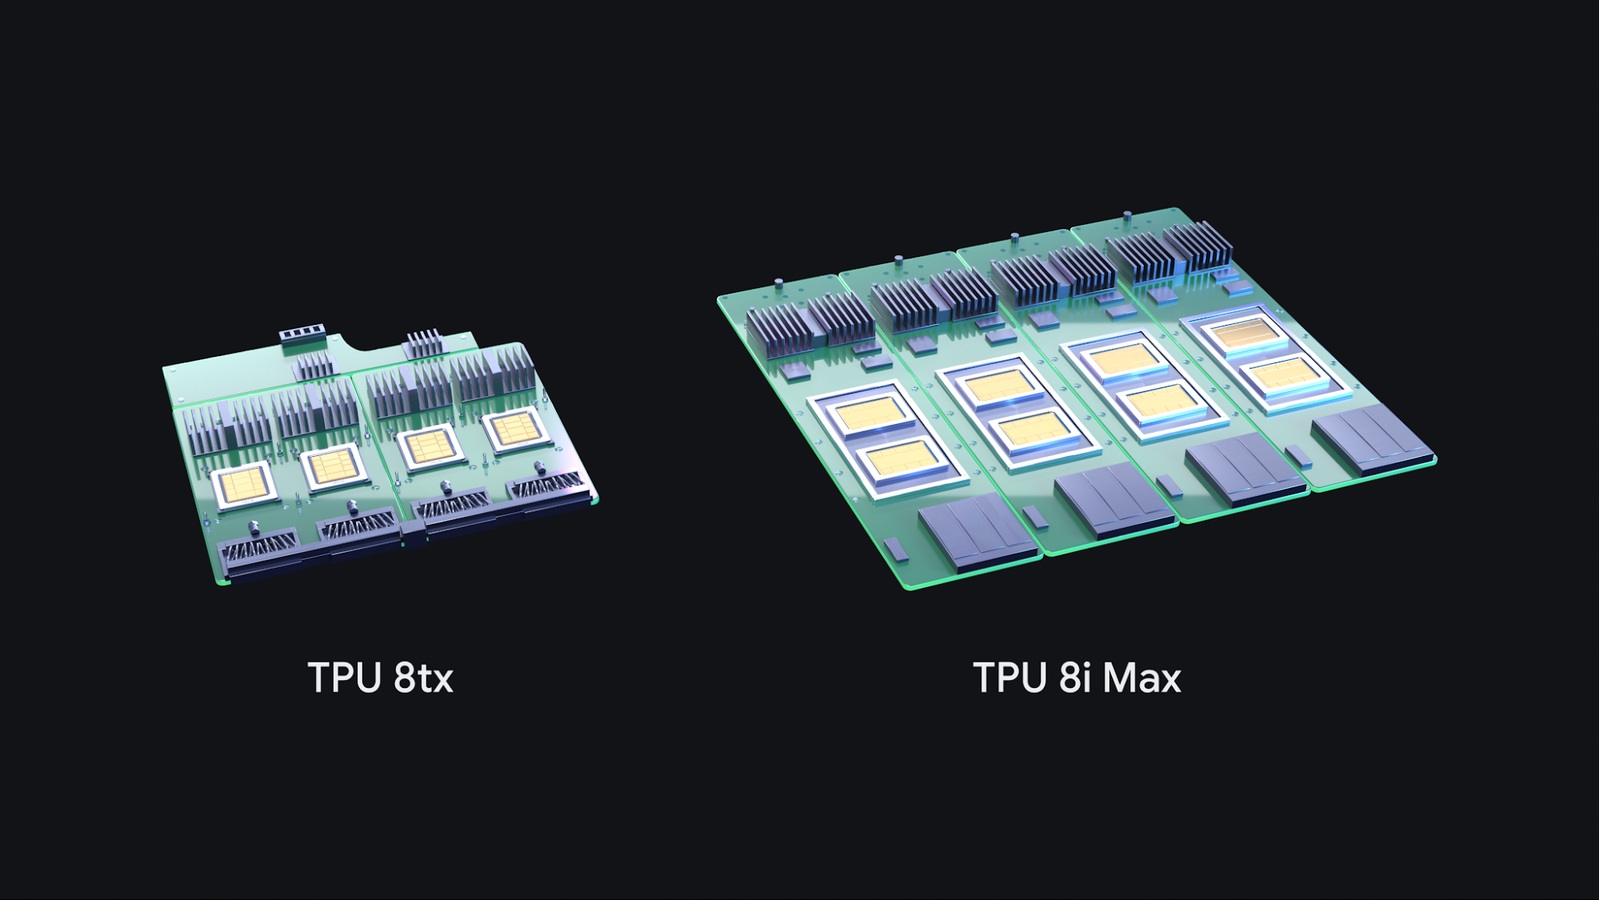
Google presenta due sistemi della stessa generazione TPU con obiettivi diversi. 8tx usa il silicio 8t con host AMD EPYC di quinta generazione e protezioni per l’inferenza riservata. 8i Max riunisce due chip 8i in un package per aumentare risorse di calcolo e memoria. È un annuncio di configurazioni di sistema, non di due nuove architetture di chip.
Limiti da conoscere
Limite: Le prestazioni riportate appartengono a Google. Non sono stati verificati prezzi, regioni, quote o disponibilità acquistabile delle due configurazioni; nessuna conclusione di conformità o risparmio automatico.
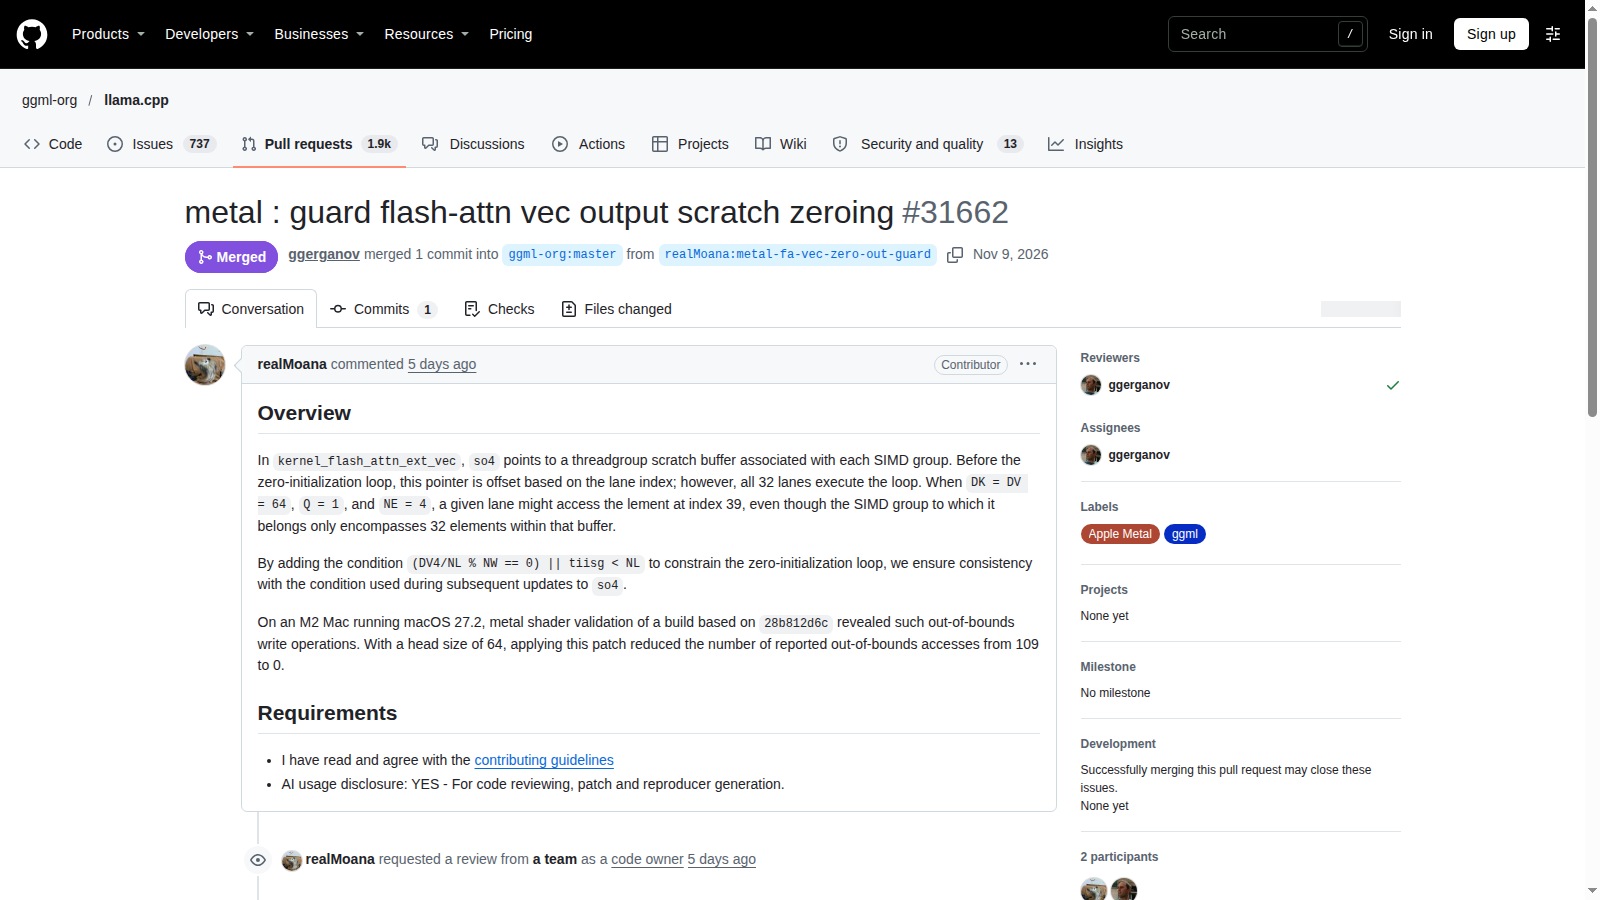
La pre-release b12221 include la PR 31662, che limita il ciclo di azzeramento di un buffer temporaneo nel percorso Metal Flash Attention. L’autore riporta il passaggio da 109 a zero segnalazioni di accesso fuori limite su un M2 con macOS 27.2 e head size 64. È una correzione circoscritta di correttezza della memoria, non un aumento di velocità misurato qui.
Limiti da conoscere
Limite: b12221 è una pre-release e il punto di introduzione del fix, non una dichiarazione sull’ultima build disponibile. Il risultato 109→0 è dell’autore su M2/macOS 27.2; nessuna nostra replica, CVE o promessa di velocità.
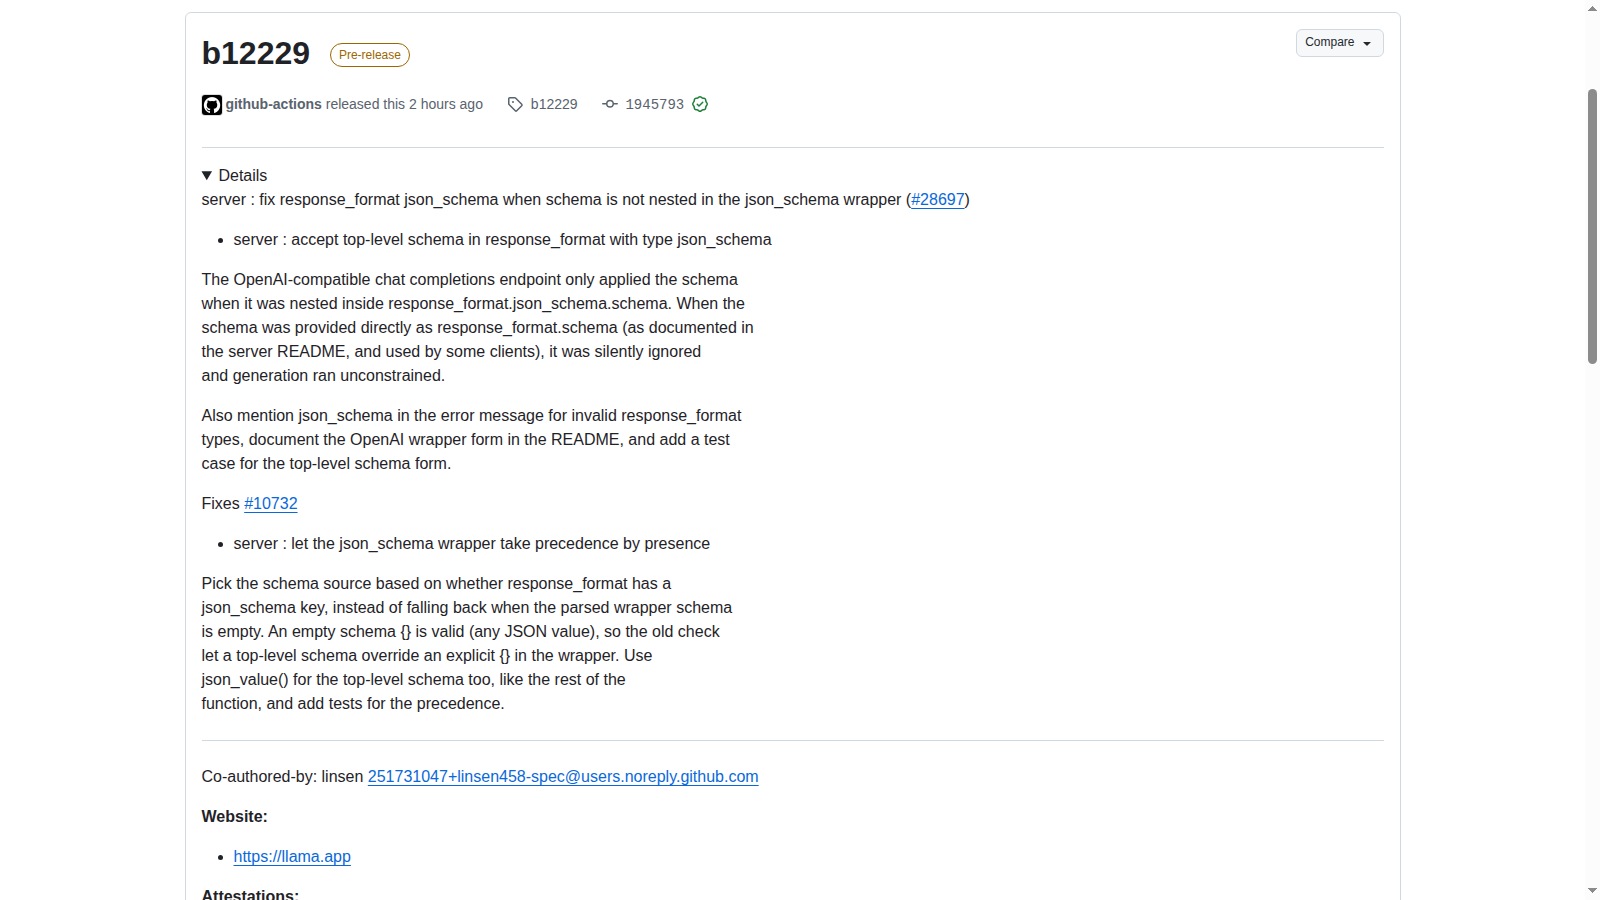
La pre-release b12229 corregge il server quando type è json_schema ma lo schema arriva in response_format.schema, senza il wrapper annidato. Prima quel formato documentato poteva essere ignorato e la generazione risultare non vincolata. La PR aggiunge test anche sulla precedenza: se json_schema è presente prevale sullo schema al livello principale, compreso il caso di schema vuoto.
Limiti da conoscere
Limite: b12229 è marcata pre-release. I test aggiunti sono prova del contratto nel repository, non una nostra esecuzione né una garanzia su tutti gli schemi JSON o su ogni client compatibile.
Anthropic presenta due configurazioni dello stesso modello: Fable con protezioni aggiuntive per cyber e biologia, Mythos con accesso diretto riservato ai programmi di verifica. Il listino ordinario è 8 dollari per milione di token in ingresso e 40 in uscita; la modalità rapida ha un prezzo distinto. Non sono pesi per l’esecuzione locale.
Limiti da conoscere
Limite: I benchmark non sono una nostra prova. Mythos non è aperto indistintamente a tutti; modalità rapida, disponibilità e regole sui dati vanno verificate per lo specifico canale e contratto.
Meta annuncia Muse Ember sulla propria API: fino a 200K token di prompt costa 0,10 dollari per milione di token input e 0,50 per l’output; oltre la soglia, 0,30 e 1,50. La finestra di contesto arriva a un milione di token. Il modello è proposto per strumenti, estrazione e sottocompiti di coding; accesso API e listino non provano pesi scaricabili o un risparmio reale.
Limiti da conoscere
Limite: Nessun benchmark o risparmio replicato. Prezzi base fino a 200K token di prompt; oltre la soglia valgono 0,30 dollari input e 1,50 output per milione. L’annuncio API non dimostra pesi pubblici o inferenza locale.
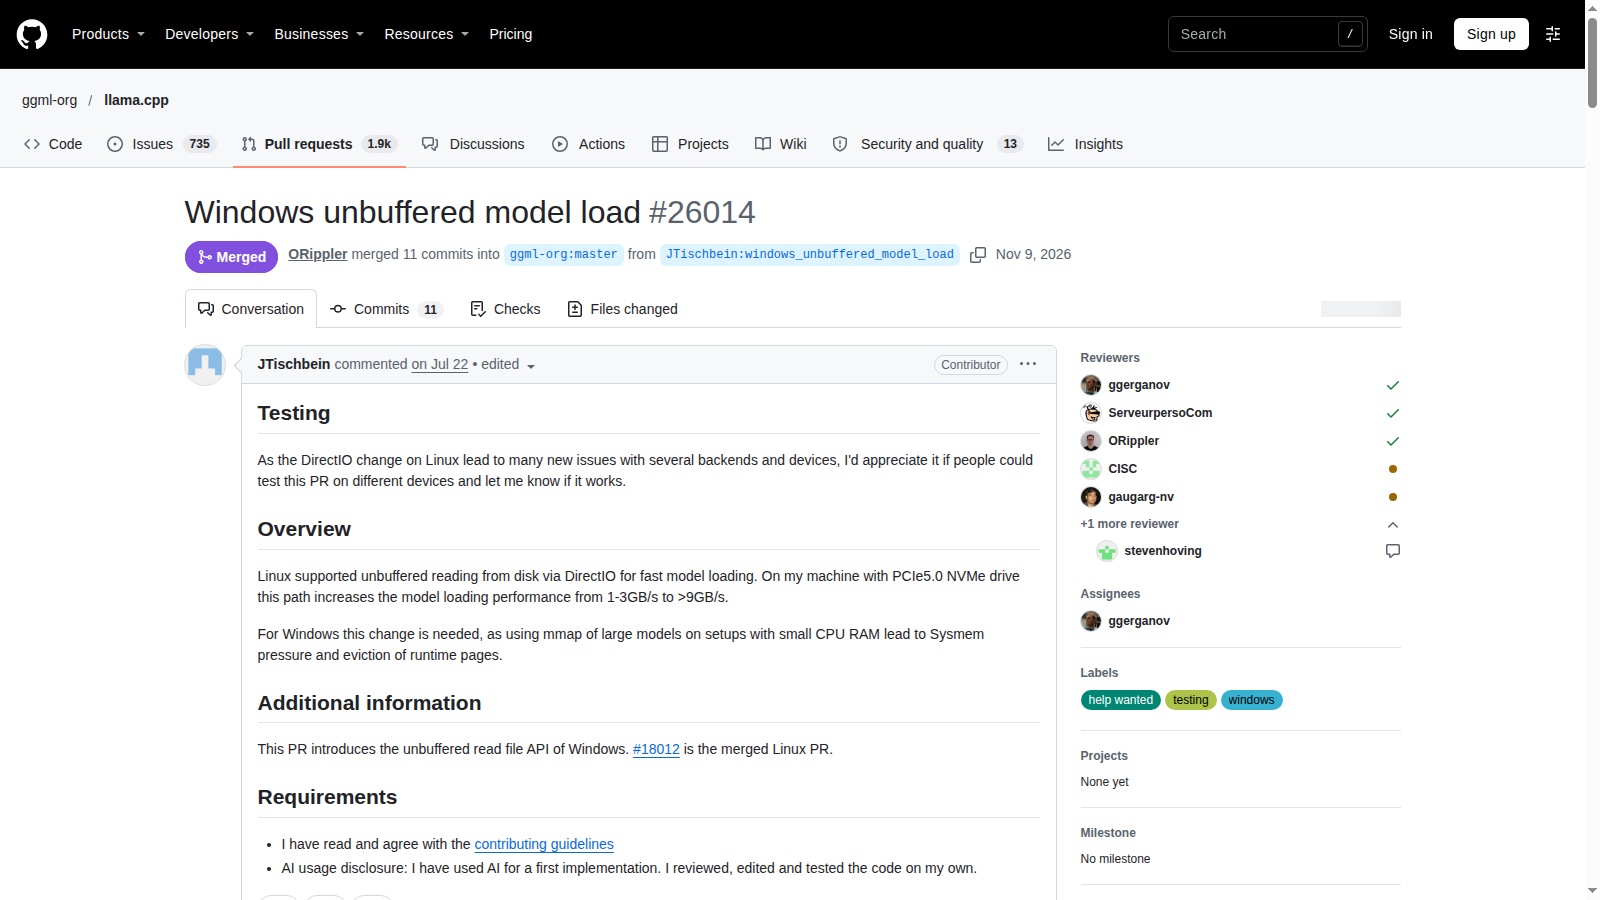
La PR 26014, unita al ramo principale il 9 novembre, introduce l’API Windows per la lettura senza buffer del sistema nel caricamento dei modelli. Il codice gestisce allineamento e ritorno alla lettura con buffer nei casi previsti, con un test dedicato. Il merge è verificato; una release REST b12232 non è confermata dall’endpoint consultato.
Limiti da conoscere
Limite: Nessuna misura Windows replicata. Le velocità citate dall’autore nella descrizione riguardano il precedente percorso Linux sul suo NVMe: non sono risultati Windows. Merge e release distribuibile restano stati distinti.
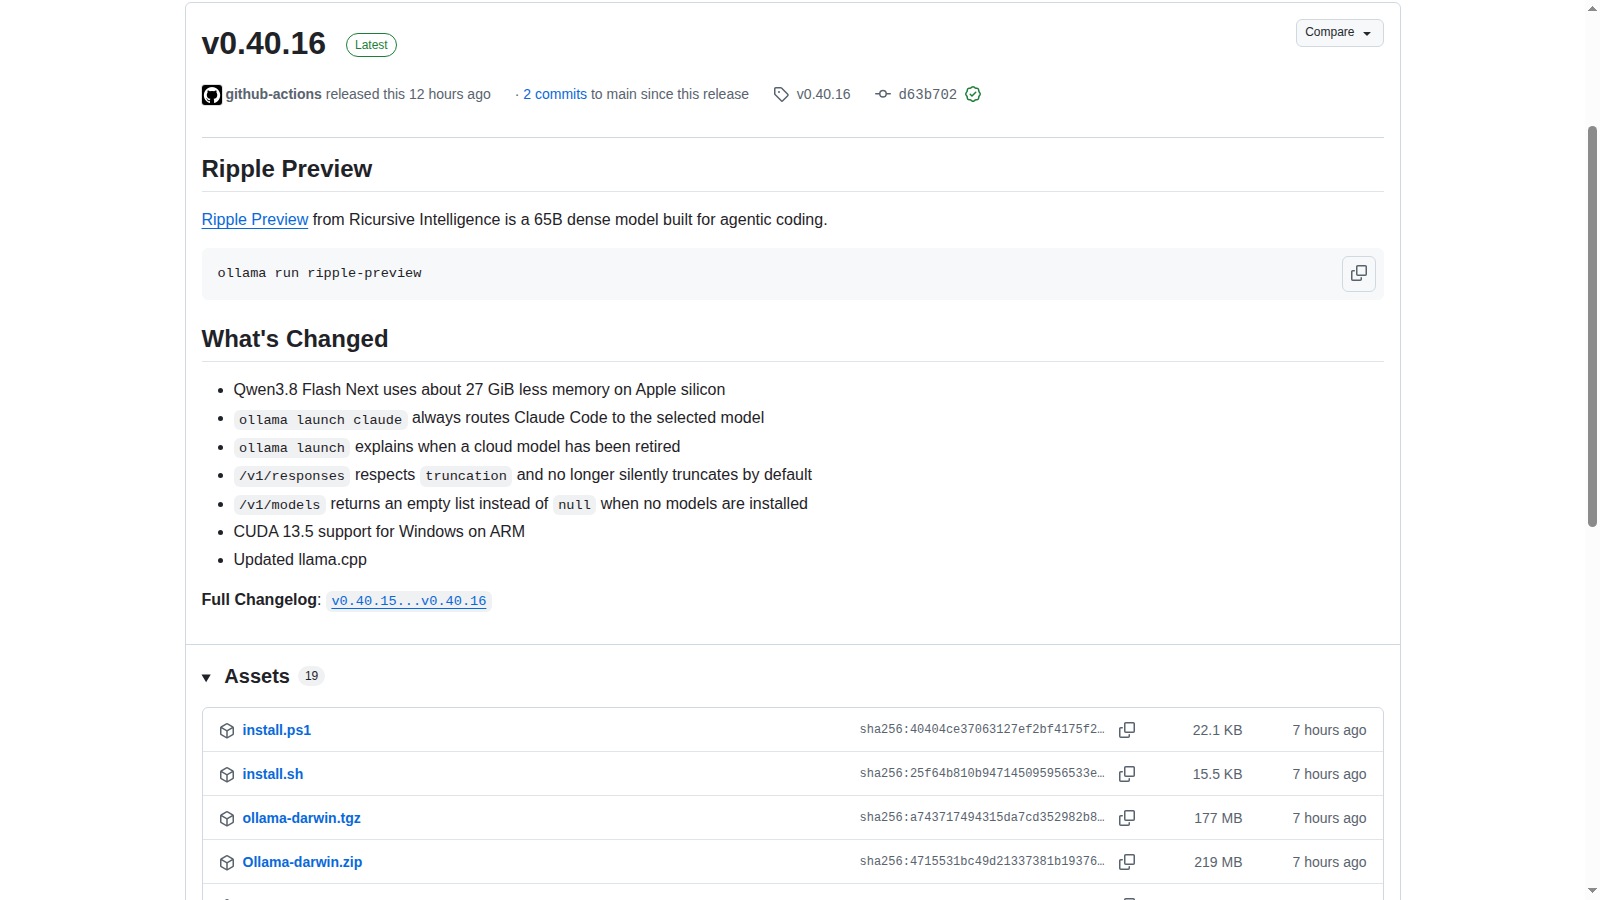
La release stabile 0.40.16 del 9 novembre include la correzione di /v1/responses: truncation viene rispettato e gli input troppo lunghi non sono più accorciati silenziosamente per impostazione predefinita. La PR era stata unita il 6 novembre; il delta qui è la distribuzione nella release stabile, non un contesto più grande.
Limiti da conoscere
Limite: Verifica di release e PR ufficiali, senza inferenza comparativa. La correzione riguarda /v1/responses; memoria disponibile, contesto configurato e comportamento del client restano vincoli separati.
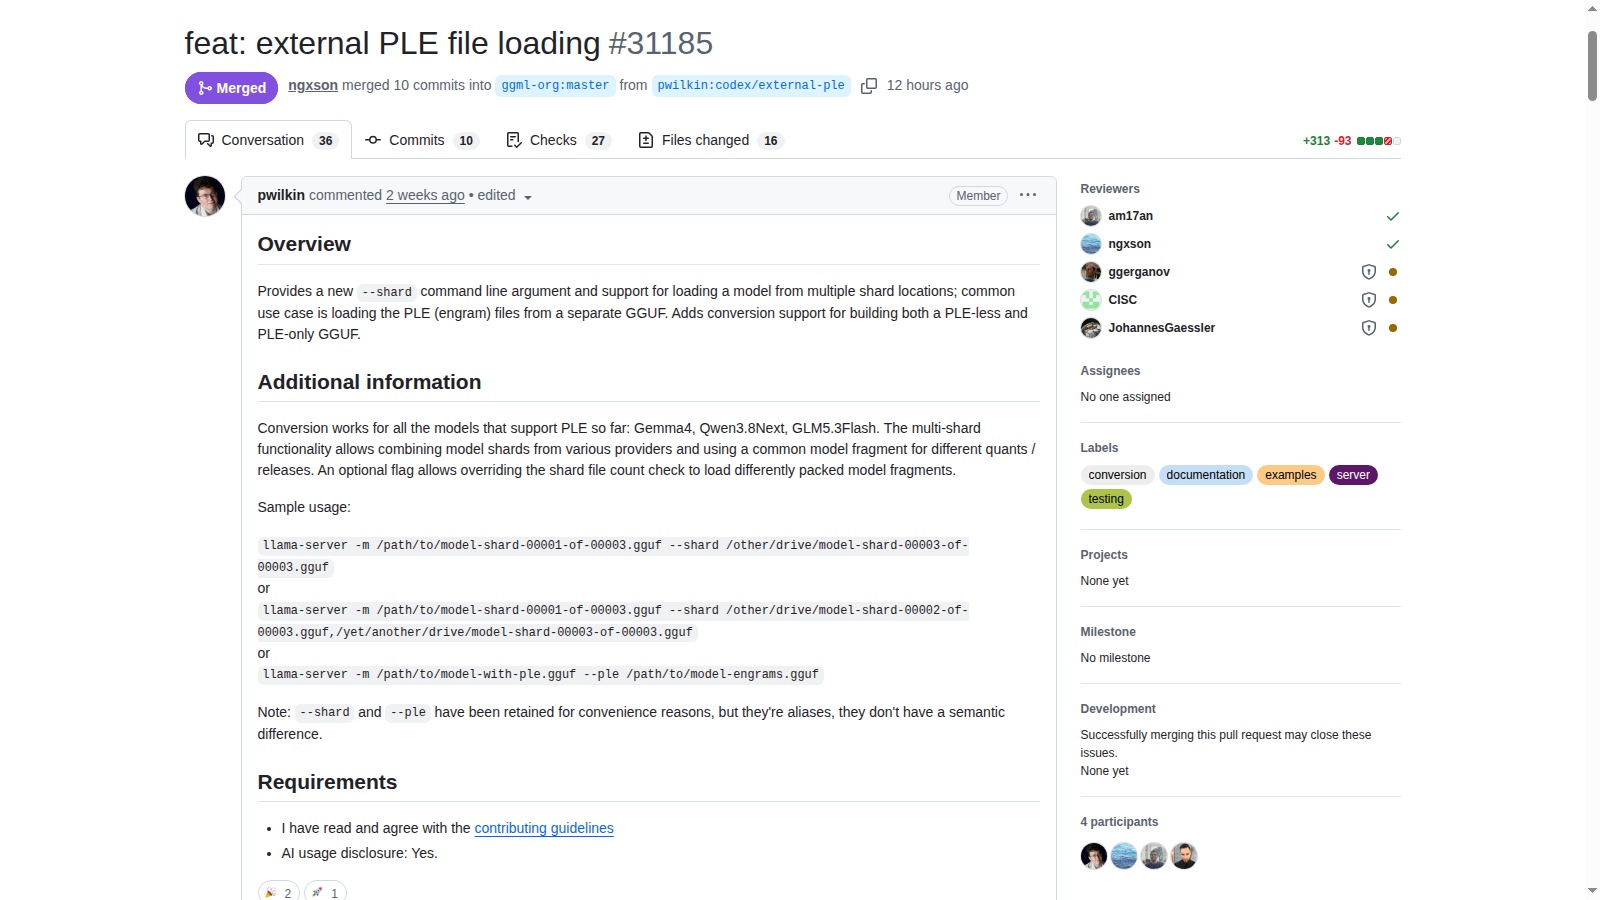
La build b12233 include il caricamento di frammenti del modello da più percorsi e il supporto ai file PLE separati. La PR aggiunge anche conversioni PLE-only e senza PLE per i modelli supportati. --shard e --ple sono alias, non due politiche diverse di gestione della memoria.
Limiti da conoscere
Limite: Build marcata prerelease. Nessuna conversione GGUF, prova di caricamento o misura di memoria eseguita qui. La compatibilità dei frammenti va verificata: percorsi diversi non rendono intercambiabili tensori e metadati arbitrari.
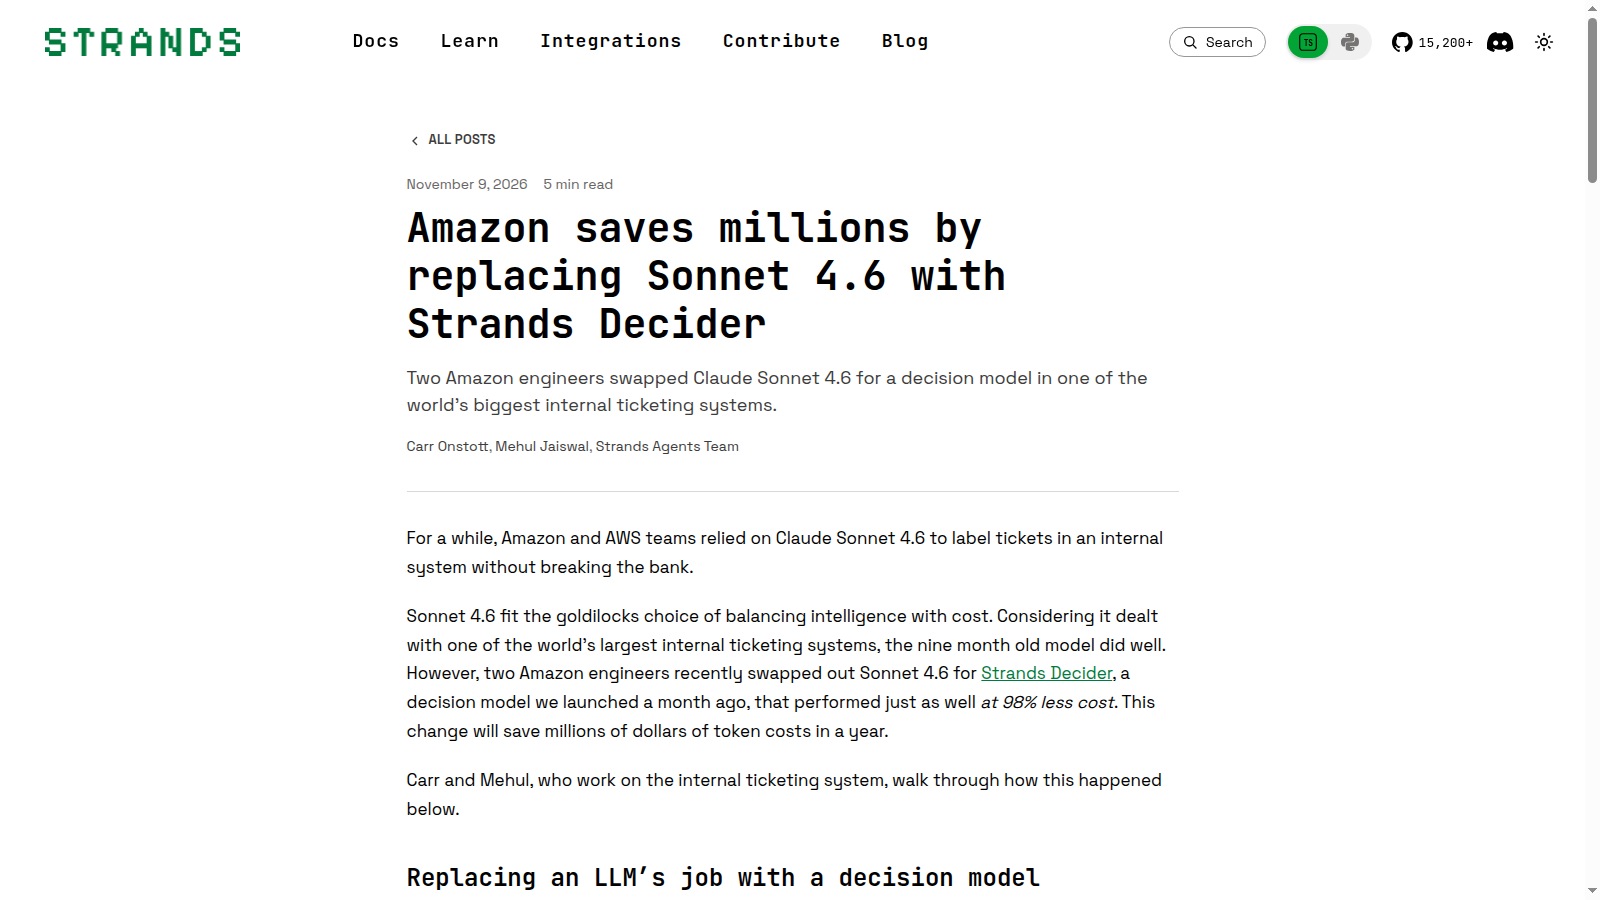
Nel caso pubblicato il 9 novembre, un team Amazon sostituisce Sonnet 4.6 con Strands Decider E4B per scegliere fra venti categorie di ticket. Il team dichiara un costo inferiore del 98% nel proprio scenario ad alto volume: è una scelta chiusa, non la sostituzione generale di un assistente.
Limiti da conoscere
Limite: Nei ticket lunghi il caso elimina i commenti più vecchi per rientrare nel contesto; l'ordine delle chiavi JSON può modificare le probabilità. Il supporto Gemma 4 è dichiarato nel repository main, non ancora nel pacchetto PyPI. Nessuna prestazione italiana verificata.
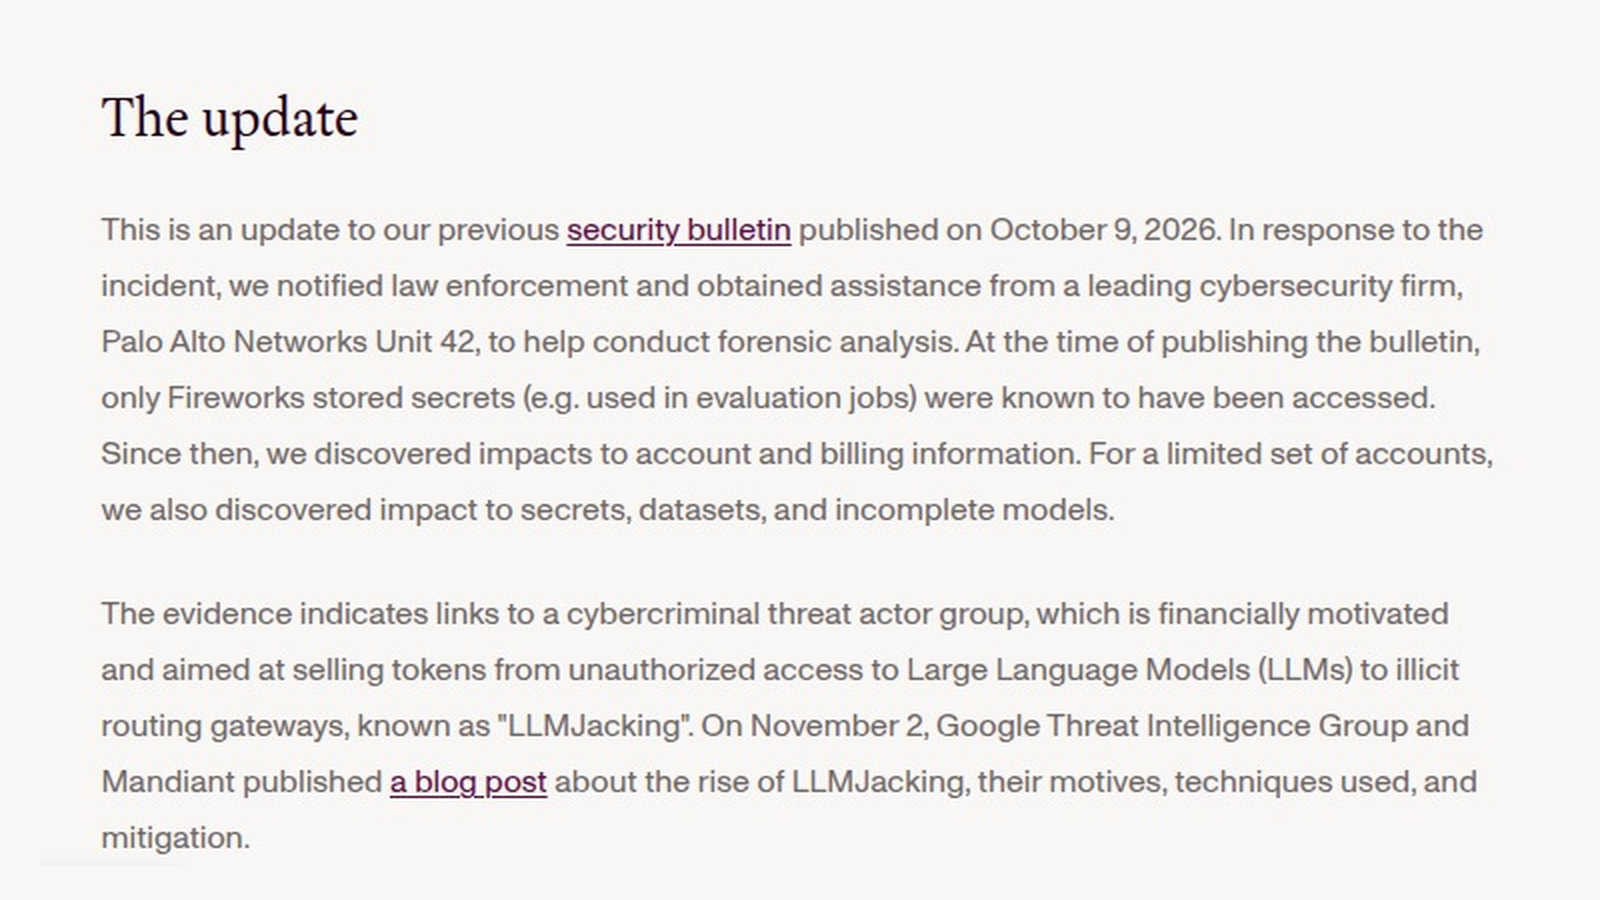
Il bollettino aggiornato il 9 novembre amplia i dati coinvolti a informazioni account e fatturazione; per un insieme limitato di account cita anche segreti, dataset e pesi incompleti. Fireworks ha disabilitato upload e download self-service dei dataset per Batch Inference e training basato su dataset.
Limiti da conoscere
Limite: Fireworks dichiara di non aver rilevato impatti su Inference, Training SDK e Nexus e precisa che l'indagine continua. L'attività aggiuntiva descritta risale al 23 e 24 ottobre. L'assenza di evidenze nel bollettino non certifica l'assenza assoluta di esposizione.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.