
L’ANALISI
llama.cpp Speech API: WAV, PCM e limiti reali
llama.cpp b12238 aggiunge /v1/audio/speech per modelli audio: solo WAV e PCM, voci del modello e velocità 1.0. Nessuna prova TTS eseguita.
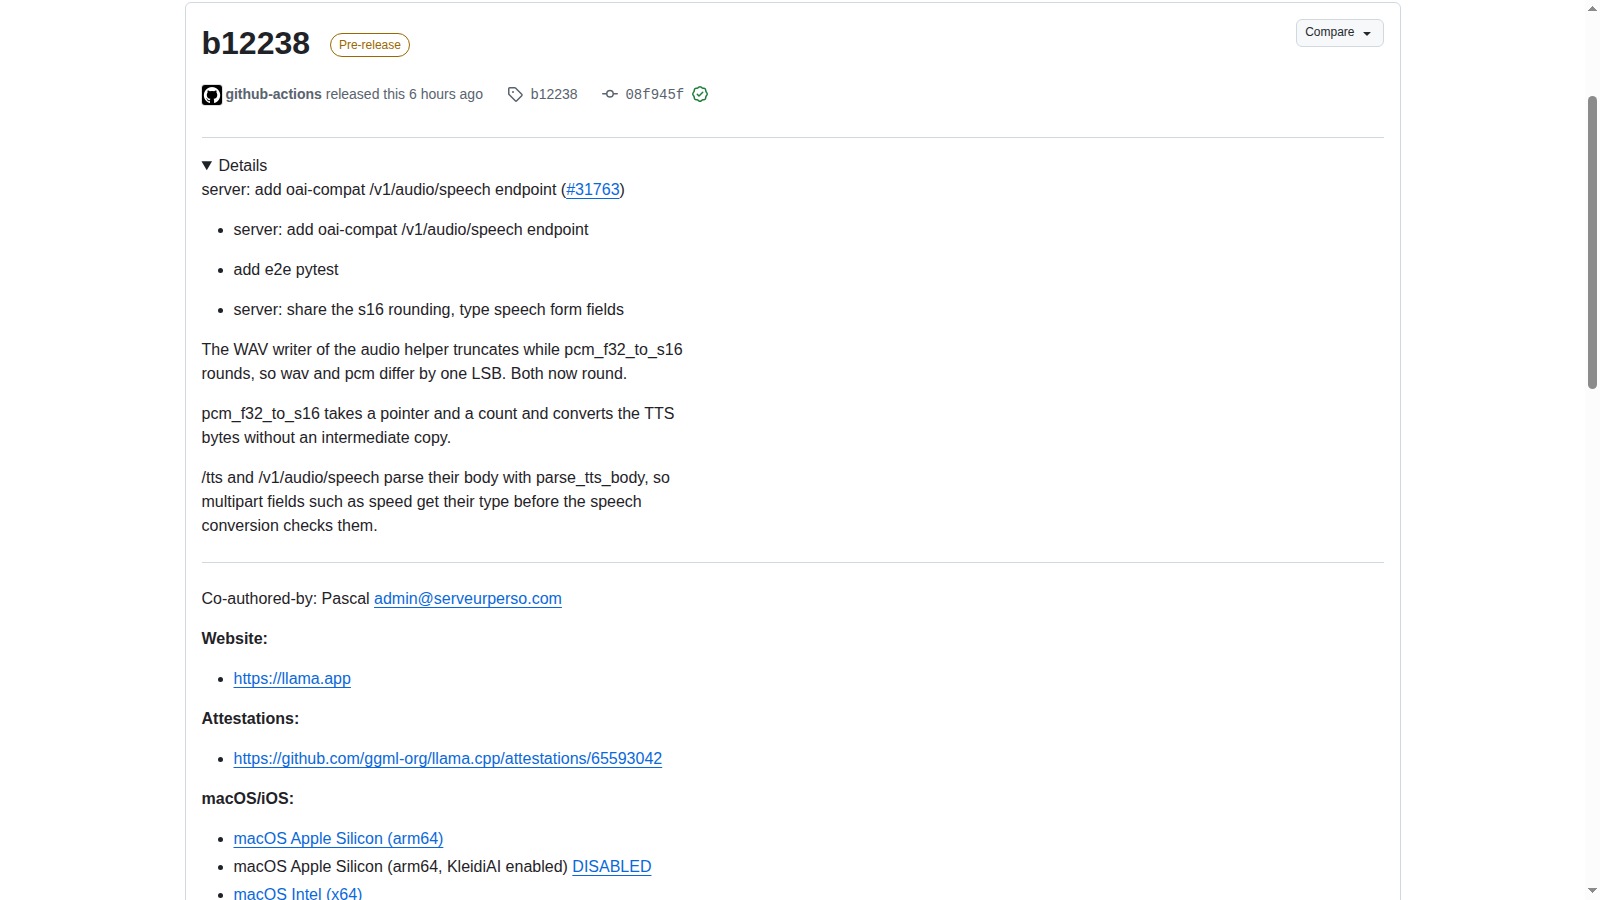
In breve: llama.cpp espone ora /v1/audio/speech per generare parlato con modelli audio compatibili. Il percorso accetta WAV o PCM e velocità 1.0; non trasforma un qualsiasi modello testuale in un sintetizzatore né mappa automaticamente le voci OpenAI. llama.cpp b12238: endpoint audio speech.
Verificati oggetto release e README del server fissato al commit 08f945ffb5c305afad252f7328080be9b46315ad. Nessuna compilazione, inferenza audio o prova end-to-end eseguita.
Serve un modello diverso da un normale LLM testuale?
La documentazione limita la generazione ai modelli capaci di produrre audio. Il nuovo endpoint converte la richiesta nel percorso /tts, del quale può usare opzioni come lang, seed o speaker_ref_b64. Questo chiarisce il confine: la novità è un’interfaccia server, non il rilascio di pesi vocali e non una funzione universale di ogni checkpoint. Prima della prova occorre verificare modello, licenza e configurazione di avvio, senza dedurli dalla sola presenza della route HTTP.
llama.cpp b12238: endpoint audio speech · llama.cpp: contratto Speech API al commit della release.
Quali formati e voci sono davvero accettati?
response_format accetta wav o pcm e usa wav come impostazione predefinita. Il PCM è mono, signed 16-bit little-endian, senza intestazione; il campionamento è quello del modello, non viene automaticamente portato a 24 kHz. Il campo voice deve riferirsi a una voce esposta da GET /props. Un nome OpenAI come alloy non viene tradotto e può essere rifiutato da un modello con voci predefinite. Sono differenze da controllare nel client prima di sostituire il provider.
llama.cpp: contratto Speech API al commit della release.
Streaming e velocità sono equivalenti a OpenAI?
No. La documentazione ammette stream_format audio per trasmettere il contenuto quando disponibile e rifiuta sse; se il campo è omesso la risposta non è trasmessa in streaming. speed accetta soltanto 1.0 e instructions viene ignorato. Un’applicazione che richiede MP3, eventi SSE, istruzioni vocali o velocità variabile deve gestire esplicitamente queste differenze. Una risposta HTTP riuscita con un breve testo non dimostra che tutte le funzioni usate dal client originale siano coperte.
llama.cpp: contratto Speech API al commit della release.
Come impostare una prima prova controllata?
Avviare un modello vocale supportato in un ambiente separato e interrogare prima /props per scegliere una voce valida. Usare una frase italiana breve, richiedere WAV e conservare richiesta, intestazioni e file restituito. Verificare che il file si apra, che durata e campionamento siano leggibili e che il contenuto corrisponda al testo. Solo dopo confrontare PCM e streaming. La qualità linguistica richiede ascolto e criteri propri; questo è un protocollo proposto, non un risultato misurato.
llama.cpp: contratto Speech API al commit della release.
Condizioni e limitazioni
b12238 è marcata prerelease nell’API GitHub. Nessun audio prodotto e nessuna valutazione di qualità o pronuncia italiana. MP3, SSE e variazioni di velocità non sono supportati da questo contratto documentato.
Checklist pratica
- Scegliere modello audio e licenza prima di scaricare i pesi.
- Registrare build e commit del server, distinguendo la prerelease.
- Leggere le voci effettive da /props.
- Provare prima WAV a velocità 1.0 e verificare il file ottenuto.
- Non assumere supporto per MP3, SSE o nomi vocali di altri provider.