
L’ANALISI
llama.cpp: Higgs v3 STT e VibeVoice-ASR in mtmd
llama.cpp b12426 aggiunge Higgs v3 STT e VibeVoice-ASR a mtmd, con convertitori e gestione audio. Il supporto non equivale a un test sul PC.
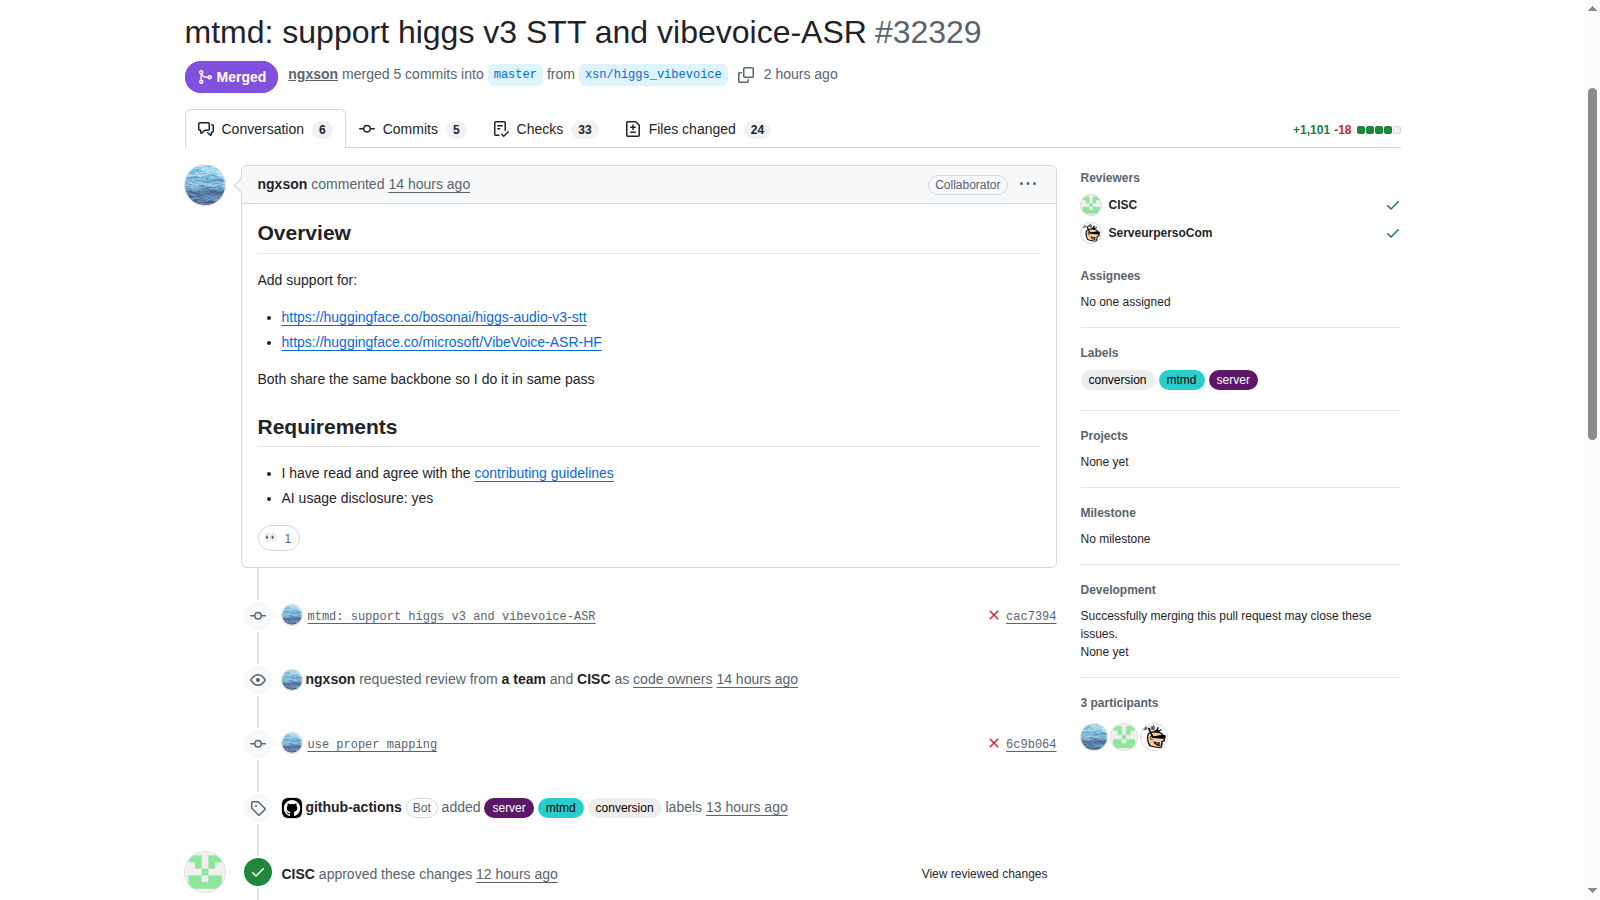
In breve: llama.cpp b12426 aggiunge a mtmd il supporto per Higgs Audio v3 STT e VibeVoice-ASR. La PR introduce convertitori e codice per il percorso audio: non annuncia nuovi pesi. Non dimostra da sola che lingue, durata massima, diarizzazione e prestazioni dichiarate nei backend originali siano già riprodotte nella nuova integrazione. PR 32329: supporto Higgs v3 STT e VibeVoice-ASR.
Verifica documentale del 15 novembre 2026 sulla prerelease b12426, sulla PR 32329 e sui file modificati. Commit di unione: fc504f91d8cfdfcd9b0fedcf14600fd2b0e63420. Lette le model card ufficiali BosonAI e Microsoft. Nessun audio trascritto e nessun test hardware eseguito.
Qual è il nuovo artefatto disponibile?
Il delta datato 15 novembre è la prerelease b12426 del runtime llama.cpp. La PR 32329, unita prima della pubblicazione, collega esplicitamente i repository bosonai/higgs-audio-v3-stt e microsoft/VibeVoice-ASR-HF. L’autore spiega di aver affrontato insieme i due percorsi perché condividono lo stesso backbone. È quindi un aggiornamento di compatibilità nel runtime, non il debutto dei modelli o una nuova licenza dei pesi. Chi aveva escluso questa strada per assenza del supporto ha ora codice primario da esaminare, non un risultato già garantito sul proprio hardware.
PR 32329: modelli di origine e commit di unione · Prerelease llama.cpp: b12426 e data di pubblicazione.
Che cosa comprende il diff?
I file aggiunti includono conversion/higgs_audio.py, conversion/vibevoice_asr.py e tools/mtmd/models/vibevoice-asr.cpp. Sono modificati anche la gestione audio, gli helper multimediali, la costruzione del modello e i percorsi server-chat e server-realtime. Questa ampiezza aiuta a identificare il perimetro della nuova integrazione, ma non dimostra che ogni interfaccia esponga tutte le capacità dei modelli. La presenza di codice in server-realtime, per esempio, non è una misura di latenza né una promessa generale di trascrizione in tempo reale.
Convertitori, componenti mtmd e integrazione server.
Le model card valgono anche per questa integrazione?
La card BosonAI descrive un modello da 2,68 miliardi di parametri, encoder Whisper-Large-v3 e decoder Qwen3; segnala inoltre che vecchi risultati di valutazione non rappresentano necessariamente il checkpoint aggiornato. Microsoft descrive per VibeVoice-ASR trascrizioni con parlante e tempi e un percorso Transformers. Sono dichiarazioni e istruzioni dei rispettivi progetti. Il supporto appena aggiunto a llama.cpp va verificato separatamente per output strutturato, lingue, durata, memoria ed errori. Copiare limiti o benchmark da un backend diverso darebbe al lettore una garanzia che questa analisi non ha misurato.
Model card BosonAI Higgs Audio v3 STT · Model card Microsoft VibeVoice-ASR-HF.
Quale prima prova ha senso fare?
Il protocollo proposto fissa runtime, checkpoint e conversione, poi usa un breve audio proprio con trascrizione manuale. Prima si controllano caricamento, encoder e artefatti multimediali richiesti; poi si confronta il testo prodotto. Parlanti e timestamp si valutano solo se il percorso scelto li restituisce davvero. Una seconda fase può introdurre rumore o più voci, conservando gli stessi input per un confronto ripetibile. Non occorre partire da un’ora di registrazione: ridurre le variabili rende più leggibile un errore di conversione o di integrazione. Nessuno di questi passaggi è stato eseguito per questa notizia.
Convertitori, componenti mtmd e integrazione server · Model card BosonAI Higgs Audio v3 STT · Model card Microsoft VibeVoice-ASR-HF.
Checklist pratica proposta
- Fissare b12426 o una revisione che includa la PR 32329.
- Annotare la revisione del checkpoint e il convertitore usato.
- Controllare caricamento e percorso audio prima di misurare la qualità.
- Usare un breve audio autorizzato e una trascrizione manuale.
- Verificare separatamente testo, tempi e parlanti effettivamente restituiti.
- Non trasferire automaticamente limiti o benchmark da Transformers a llama.cpp.
Condizioni e limitazioni
Prerelease e analisi documentale. Conversione, inferenza, accuratezza, diarizzazione, durata massima, latenza e consumi nel percorso llama.cpp non sono stati verificati qui.