
L’ANALISI
llama.cpp: corretto il caricamento di Qwen3-ForcedAligner
llama.cpp b12425 legge da output.weight la dimensione della testa Qwen3: il fix riguarda anche ForcedAligner con 5.000 classi temporali.
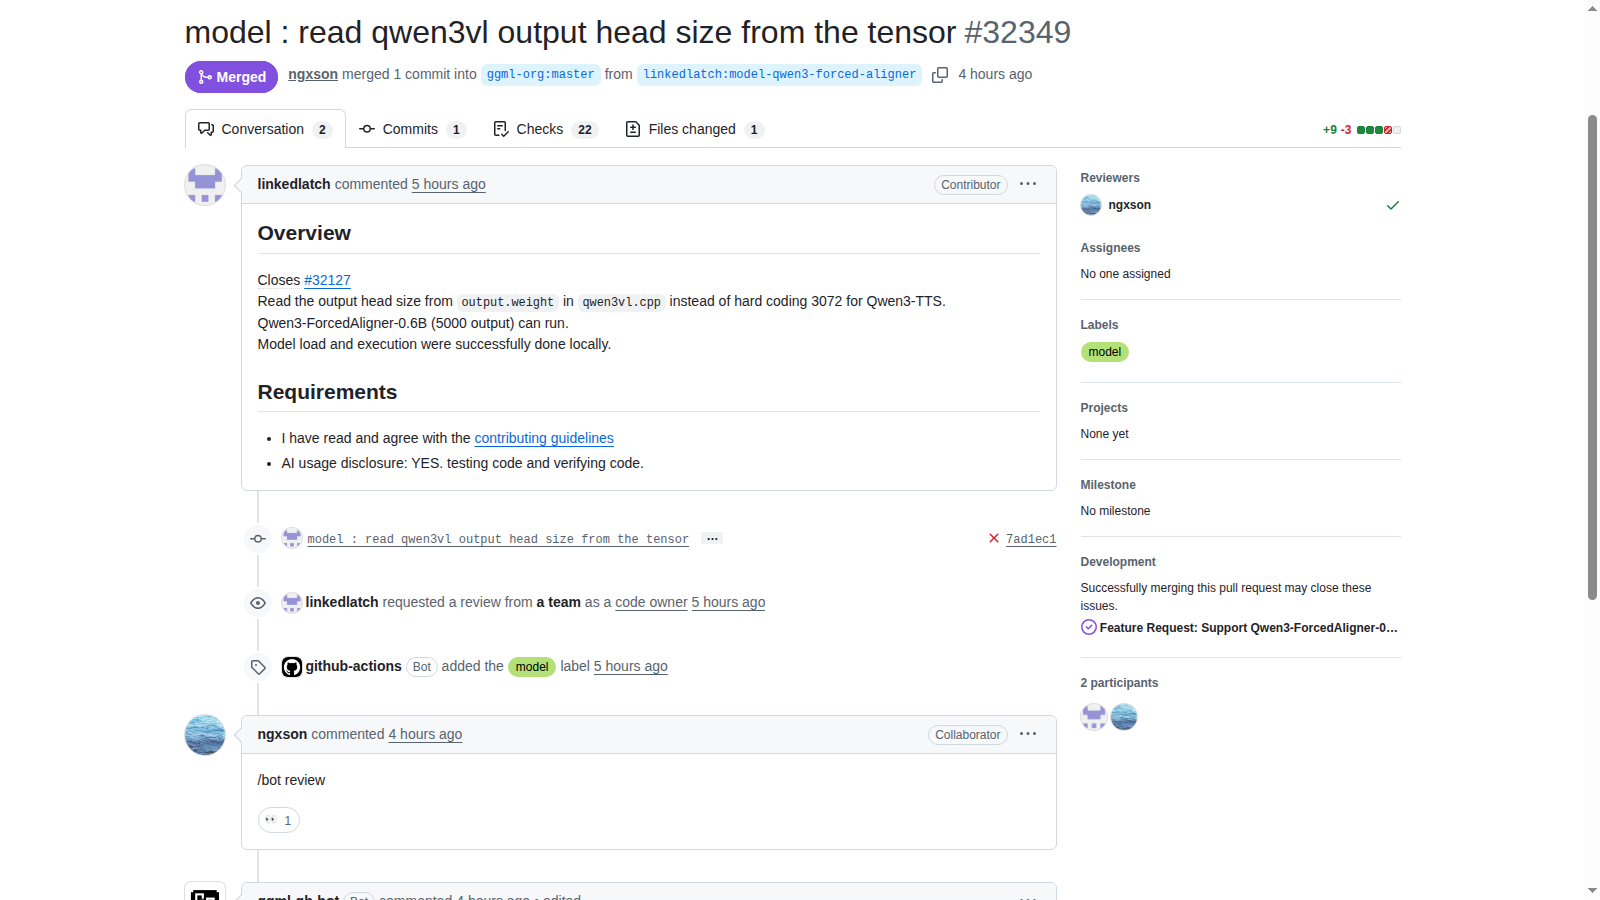
In breve: llama.cpp b12425 legge la dimensione della testa di output Qwen3 dal tensore output.weight. La PR collega il fix a Qwen3-ForcedAligner-0.6B e alle sue 5.000 classi temporali. È una correzione del caricamento: non un nuovo modello, una prova di accuratezza o un flusso completo di sottotitolazione verificato qui. PR 32349: dimensione della testa Qwen3 dal tensore.
Verifica documentale del 15 novembre 2026 sulla prerelease b12425, sulla PR 32349 e sul relativo diff. Commit di unione: 18b74fa41dcac1f55ae1371fe58153f7225941f6. Letta anche la model card ufficiale Qwen. Nessuna conversione GGUF, compilazione o inferenza eseguita.
Che cosa cambia nel caricamento?
Nel diff di src/models/qwen3vl.cpp la dimensione di output viene letta dai metadati del tensore output.weight, quando presenti. Il percorso mantiene un ripiego specifico da 3.072 uscite per Qwen3-TTS se quei metadati non sono disponibili. Aggiunge inoltre un controllo: una dimensione inferiore a uno o superiore al vocabolario genera un errore. La conseguenza pratica è distinguere il vocabolario di ingresso dalle uscite effettive del modello. Non è una modifica del numero di parametri né una riduzione della memoria misurata.
Diff del caricamento Qwen3 e controllo delle dimensioni.
Perché riguarda i timestamp di ForcedAligner?
Le note della prerelease citano Qwen3-ForcedAligner con una testa da 5.000 classi temporali, più piccola del vocabolario. L’autore della PR dichiara di aver completato caricamento ed esecuzione in locale: è una prova riportata dal contributore, non riprodotta per questo articolo. La model card Qwen descrive separatamente il forced alignment e la trascrizione ASR. Allineare un testo all’audio per ricavarne i tempi non equivale a dimostrare che il modello riconosca correttamente ogni parola di un audio sconosciuto.
PR 32349: descrizione e commit di unione · Prerelease llama.cpp: b12425 e data di pubblicazione · Model card ufficiale Qwen3-ForcedAligner-0.6B.
Basta aggiornare per avere sottotitoli affidabili?
No: il fix rimuove un ostacolo preciso nella rappresentazione della testa di output. Restano da verificare conversione del checkpoint, artefatti richiesti, integrazione del percorso audio e correttezza dei timestamp nel proprio caso d’uso. La model card include esempi di altri backend: non vanno presentati come comandi llama.cpp già collaudati. Prima di cambiare una pipeline conviene annotare formato del modello, revisione del runtime e punto esatto in cui fallisce il caricamento. Una partenza riuscita resta distinta da una valutazione della qualità.
Diff del caricamento Qwen3 e controllo delle dimensioni · Model card ufficiale Qwen3-ForcedAligner-0.6B.
Come progettare una prova controllata?
Il protocollo proposto usa una breve registrazione propria o autorizzata e una trascrizione controllata manualmente. Si fissano revisione, checkpoint e conversione, quindi si confrontano prima i log di caricamento e poi i tempi restituiti con un riferimento manuale. Parole saltate, segmenti sovrapposti e timestamp fuori intervallo vanno registrati come errori, non nascosti in una media. Solo dopo si può provare materiale più lungo o rumoroso. Questa è una procedura da eseguire: qui non vengono pubblicati tempi, tassi di errore o risultati sul dispositivo di Francesco.
PR 32349: descrizione e commit di unione · Model card ufficiale Qwen3-ForcedAligner-0.6B.
Checklist pratica proposta
- Fissare la prerelease b12425 o un commit che contenga la PR 32349.
- Registrare checkpoint, conversione e dimensioni della testa di output.
- Separare il successo del caricamento dalla qualità dei timestamp.
- Usare una registrazione propria o autorizzata con testo verificato.
- Confrontare i tempi con un riferimento manuale e conservare gli errori.
- Non attribuire alla redazione il test locale dichiarato dal contributore.
Condizioni e limitazioni
Prerelease e verifica del codice, non test end-to-end. Il contributore dichiara un’esecuzione locale; non sono stati riprodotti conversione, inferenza o misure di accuratezza.