
IL PUNTO SULL’AI
11 novembre 2026
BotPsy offre pesi da 0,8B; llama.cpp aggiunge OCP FP8 a CUDA, cache KV FP8 e un fix JSON Schema per Muse Spark. Disponibilità e limiti verificati.
In questa edizione 4 notizie
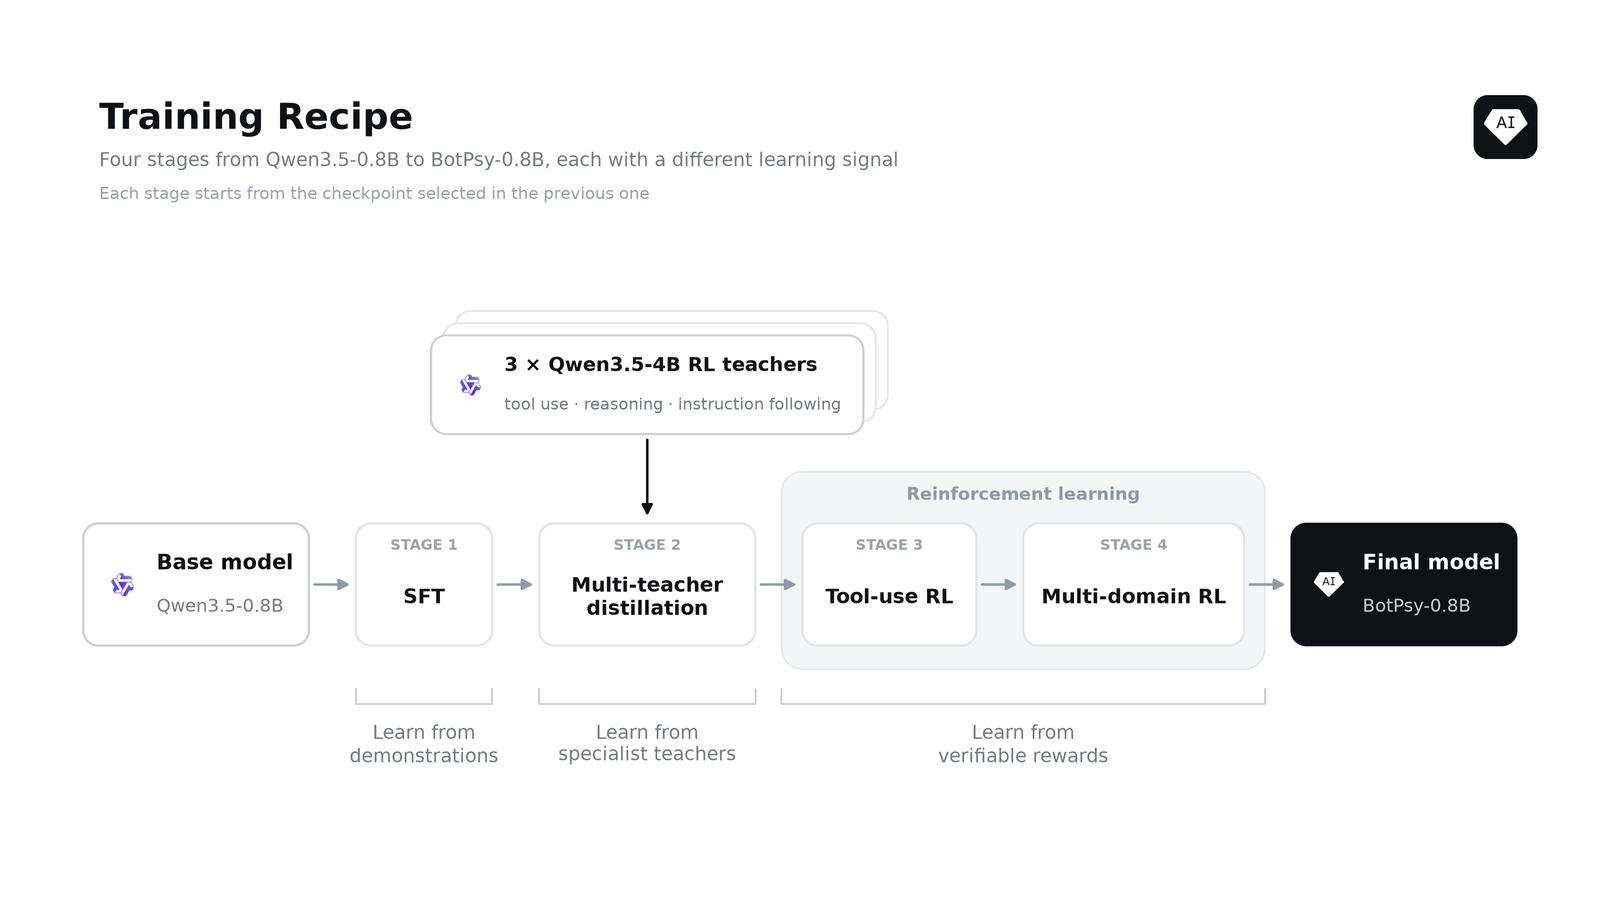
Tether AI Research presenta BotPsy, un modello per chiamare strumenti in locale. I pesi sono pubblici, ma integrare le azioni e controllarne i permessi resta lavoro dello sviluppatore.
Limiti da conoscere
Limite: I benchmark sono degli autori, non nostri test indipendenti. L'inglese è la lingua raccomandata; gli autori escludono impieghi critici e applicazioni con denaro, dati personali o salute. Non abbiamo misurato RAM, latenza, consumi o affidabilità sul dispositivo dell'utente.
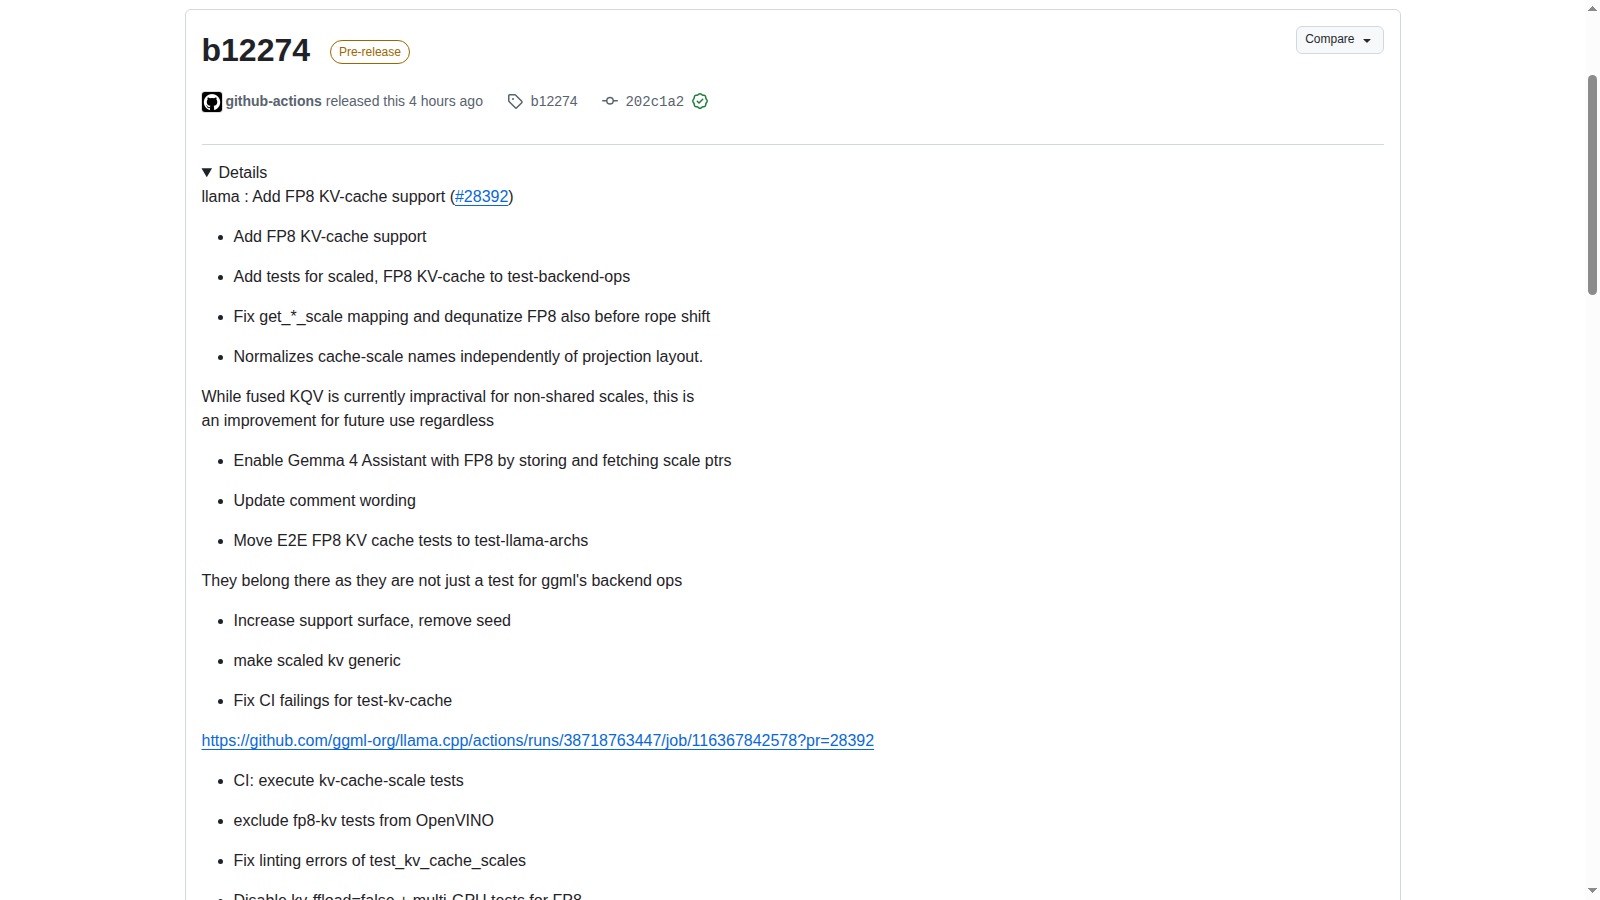
La release b12274 aggiunge il supporto a cache KV basate su OCP FP8, con scale opzionali. È una prerelease: non dimostra risparmi di memoria o accelerazioni validi per ogni modello e backend.
Limiti da conoscere
Limite: Non abbiamo verificato la disponibilità operativa di FP8 per ogni architettura o backend. Il changelog contiene esclusioni di test e modifiche per casi specifici: non è una matrice universale di supporto. Memoria complessiva, latenza, throughput e qualità non sono stati misurati qui; i test citati nelle fonti appartengono al progetto.
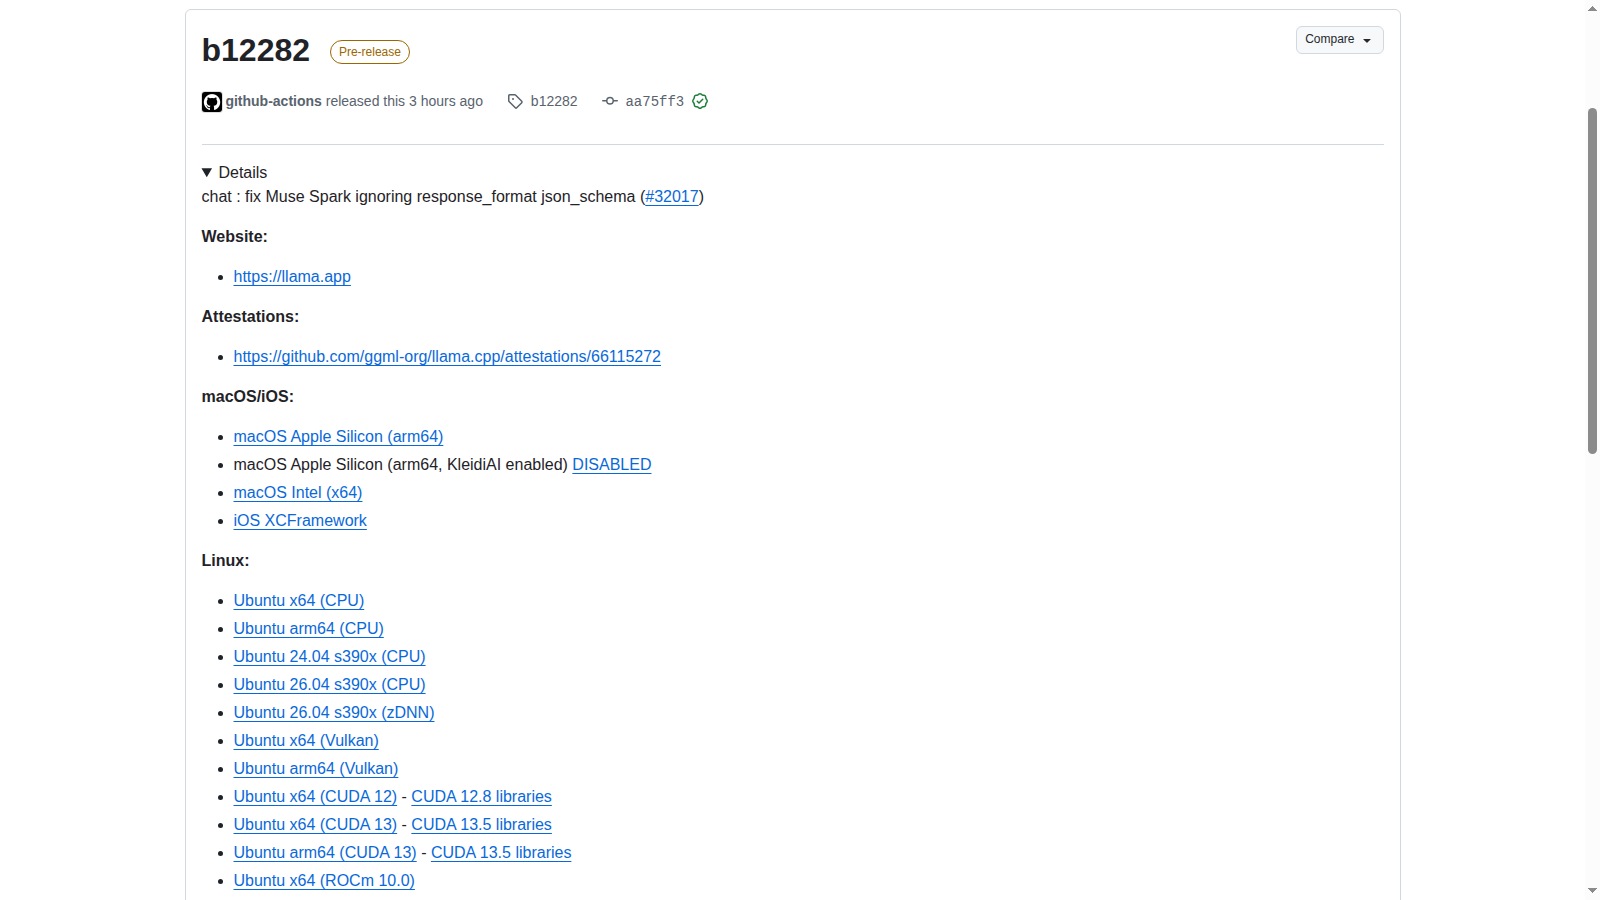
b12282 corregge il parser Muse Spark, che poteva ignorare response_format json_schema. Il vincolo viene applicato al messaggio finale, lasciando libero il ragionamento; la PR dichiara di non avere provato il modello reale.
Limiti da conoscere
Limite: La PR dichiara due test del parser, non una prova sul modello reale. Il percorso GBNF grezzo rimane invariato. Non abbiamo misurato affidabilità, compatibilità di ogni schema o comportamento dei client: il perimetro confermato è la correzione documentata per Muse Spark.
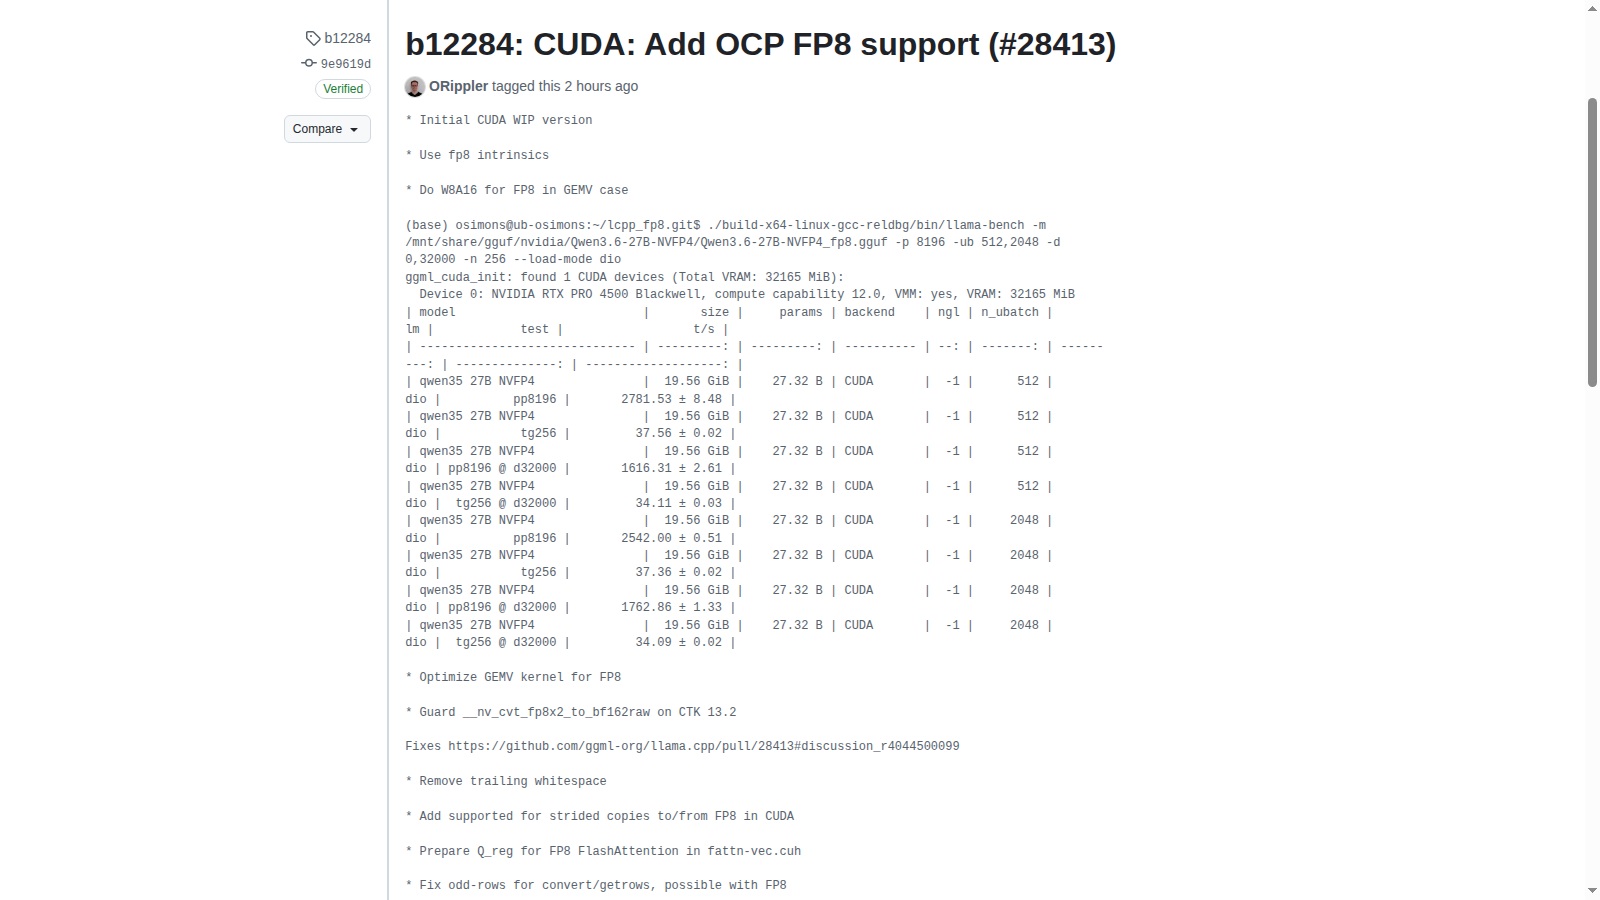
La PR 28413 integra OCP FP8 nel backend CUDA di llama.cpp. Il merge dell’11 novembre è verificato e il tag b12284 è raggiungibile; l’endpoint REST della release restituisce invece 404. Non è una nuova release stabile confermata.
Limiti da conoscere
Limite: Nessun test locale eseguito. I numeri della PR appartengono alla configurazione dell’autore; kernel MoE e parte del prefill sono rinviati. Il 404 REST non autorizza a chiamare b12284 release stabile.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.