
L’ANALISI
BotPsy: agente AI locale, pesi e limiti del rilascio
BotPsy pubblica pesi da 0,8B e GGUF Q4 da 0,53 GB. Cosa include il rilascio Apache 2.0, limiti dei benchmark e integrazione locale.
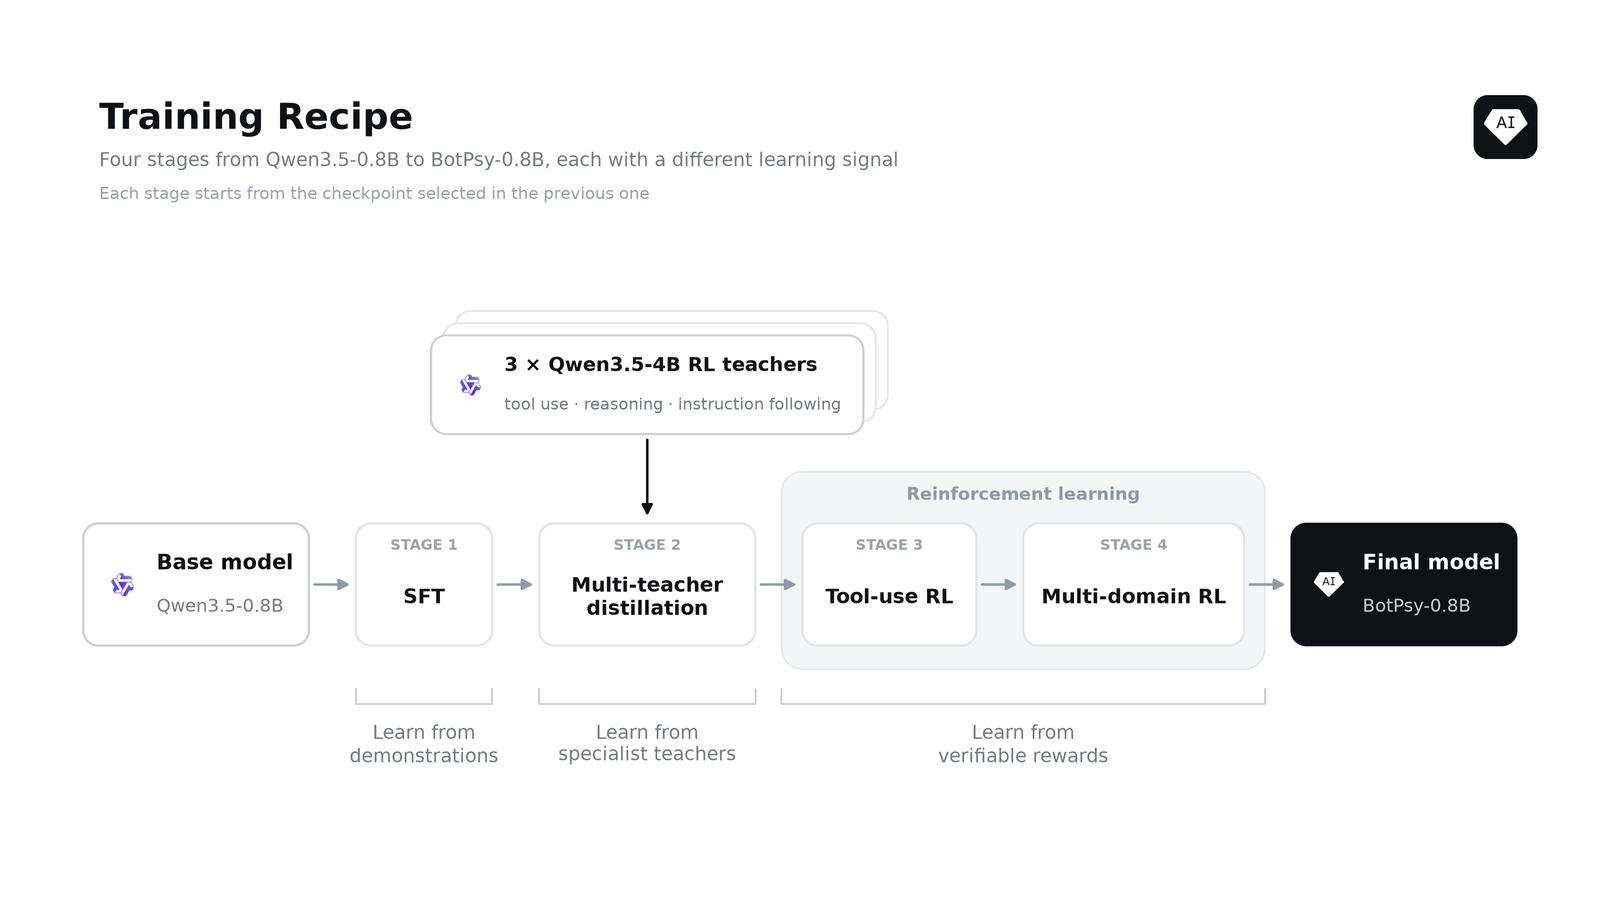
In breve: BotPsy è un modello di Tether AI Research da 0,8 miliardi di parametri, derivato da Qwen3.5-0.8B e specializzato nel chiamare strumenti, pensato per sviluppatori di assistenti locali. Sono pubblici pesi BF16 e GGUF sotto Apache 2.0, non un assistente personale già collegato alle proprie app: runtime, connettori e autorizzazioni vanno integrati. BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model, 11 novembre 2026.
Revisione dell'11 novembre 2026: articolo letto integralmente, schede, API dei repository, licenze e documentazione SDK confrontate; accesso ai pesi verificato con richieste HEAD. Nessuna inferenza o prova end-to-end eseguita. Diagramma ufficiale sottoposto anche a revisione visiva indipendente.
Che cosa è davvero disponibile l'11 novembre?
In breve: pesi BF16 in safetensors nel repository BotPsy; esportazioni GGUF BF16, Q8_0 e Q4_K_M nell'altro repository; file LICENSE Apache 2.0 in entrambi; codice e dati di addestramento esclusi dal rilascio secondo la scheda. Le API indicano repository pubblici, senza gating, creati il 10 novembre 2026; questo non prova quando siano diventati pubblici. L'articolo è dell'11 novembre e usa ancora il futuro per il rilascio, ma i file risultano già accessibili al controllo. La distinzione utile: è un rilascio di pesi utilizzabili, non la pubblicazione di tutta la filiera di addestramento. La citazione tecnica rimanda al blog, non a un paper BotPsy separato collegato nelle fonti consultate.
BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model, 11 novembre 2026 · BotPsy-0.8B: pesi BF16, uso, addestramento e limiti · API Hugging Face: visibilità, revisione e date del repository BotPsy-0.8B · API Hugging Face: visibilità, revisione e date del repository BotPsy-0.8B-GGUFs · Albero pubblico del repository: safetensors, tokenizer, configurazione e licenza · Albero pubblico del repository GGUF: nomi, dimensioni e hash dichiarati · File LICENSE del repository BotPsy-0.8B: Apache License 2.0 · File LICENSE del repository BotPsy-0.8B-GGUFs: Apache License 2.0.
I benchmark dimostrano un assistente affidabile?
Gli autori riportano BFCL v4 a 44,0 contro 23,4 della base e BrowseComp-Plus a 4,5: il miglioramento relativo non cancella il risultato basso nella ricerca complessa. Sono valutazioni in modalità thinking; quelle della serie BF16 con API esterne risalgono al 3 novembre 2026. Per i GGUF la scheda descrive prove del 6 e 7 novembre su GPU NVIDIA H100 e non include ToolSandbox. Non leggerei quindi quei numeri come una misura di velocità su smartphone o come verifica dell'intero flusso di un'app. Li userei per selezionare un candidato da provare su compiti limitati, non per autorizzare autonomia generale.
BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model, 11 novembre 2026 · BotPsy-0.8B-GGUFs: formati, benchmark e integrazione llama.cpp e QVAC.
Quanto pesa e che cosa bisogna configurare?
I GGUF pubblicati occupano circa 1,52 GB in BF16, 0,81 GB in Q8_0 e 0,53 GB in Q4_K_M con calibrazione imatrix. La scheda raccomanda Q8_0 e segnala un compromesso qualitativo per Q4: sceglierei il formato dopo aver verificato i propri compiti, non soltanto il download più piccolo. Il peso del file non è una misura della RAM totale durante l'esecuzione. Un dettaglio operativo cambia anche il confronto: il template parte senza thinking, mentre le valutazioni lo abilitano. Gli esempi ufficiali mostrano come attivarlo; un confronto sensato dovrebbe registrare anche contesto, impostazioni di generazione e motore, senza attribuire ogni differenza alla quantizzazione.
BotPsy-0.8B: pesi BF16, uso, addestramento e limiti · BotPsy-0.8B-GGUFs: formati, benchmark e integrazione llama.cpp e QVAC · Albero pubblico del repository GGUF: nomi, dimensioni e hash dichiarati.
Inferenza locale significa anche azioni private e sicure?
Nell'esempio SDK della scheda GGUF la chiamata create_event viene stampata, non eseguita sul calendario: il confine tra generazione e azione è concreto. Lo sviluppatore deve decidere che cosa collegare e con quali permessi. Eseguire il modello sul dispositivo non dimostra che uno strumento remoto non invii dati fuori. Inoltre gli autori riportano ancora il 31% di risposte non sicure sotto prompt injection nel loro test: non è una garanzia di protezione. Terrei credenziali e autorizzazioni fuori dalle decisioni del modello e chiederei conferma prima di ogni scrittura. Le estensioni Hypersearch e la delega ad altri dispositivi descritte nella visione futura non vanno confuse con funzioni già dimostrate dal rilascio dei pesi.
BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model, 11 novembre 2026 · BotPsy-0.8B-GGUFs: formati, benchmark e integrazione llama.cpp e QVAC · QVAC SDK JavaScript e TypeScript: requisiti, installazione e quickstart.
Come lo valuterei: procedura proposta, non eseguita
Partirei da un calendario fittizio e da strumenti simulati, senza account reali, per separare qualità delle chiamate e conseguenze delle azioni. Fisserei revisione dei pesi e configurazione, poi confronterei richieste complete, date ambigue, strumenti mancanti e risultati contenenti istruzioni ostili. Considererei un errore anche una scrittura non autorizzata quando la risposta finale sembra corretta. Solo dopo passerei a misurare sul dispositivo reale memoria, latenza e comportamento in italiano, usando sempre dati sintetici. La soglia proposta per proseguire è nessuna scrittura senza conferma nei casi di prova; non equivale a una garanzia di sicurezza. Questa è una procedura editoriale proposta: non abbiamo avviato il modello né eseguito test end-to-end.
BotPsy: On-Device Personal Assistant with a Sub-Billion-Parameter Agentic Language Model, 11 novembre 2026 · BotPsy-0.8B: pesi BF16, uso, addestramento e limiti · BotPsy-0.8B-GGUFs: formati, benchmark e integrazione llama.cpp e QVAC.
Checklist pratica
- Procedura proposta, non eseguita: usare soltanto dati sintetici, strumenti simulati e un calendario fittizio.
- Registrare revisione del repository, nome del file, checksum verificato dopo il download e licenza, senza usare main come riferimento immutabile.
- Annotare formato, motore, contesto e impostazioni; abilitare esplicitamente il thinking come indicato dalla scheda.
- Confrontare Q8_0 e Q4_K_M sugli stessi compiti prima di scegliere il file più piccolo.
- Includere richieste incomplete, fusi orari ambigui, nessuno strumento adatto e prompt injection nei risultati degli strumenti.
- Validare nomi e argomenti delle chiamate fuori dal modello; consentire solo strumenti autorizzati e confermare ogni scrittura.
- Misurare RAM, latenza, consumi e qualità in italiano sull'hardware di destinazione prima di decidere se proseguire.
- Tenere disconnessi account, dati personali, pagamenti e applicazioni critiche; non interpretare l'esito dei casi di prova come certificazione.
Condizioni e limitazioni
I benchmark sono degli autori, non nostri test indipendenti. L'inglese è la lingua raccomandata; gli autori escludono impieghi critici e applicazioni con denaro, dati personali o salute. Non abbiamo misurato RAM, latenza, consumi o affidabilità sul dispositivo dell'utente.