
L’ANALISI
llama.cpp: b12282 corregge JSON Schema in Muse Spark
llama.cpp b12282 corregge response_format json_schema per Muse Spark. Risposta finale vincolata e ragionamento libero, senza test sul modello reale.
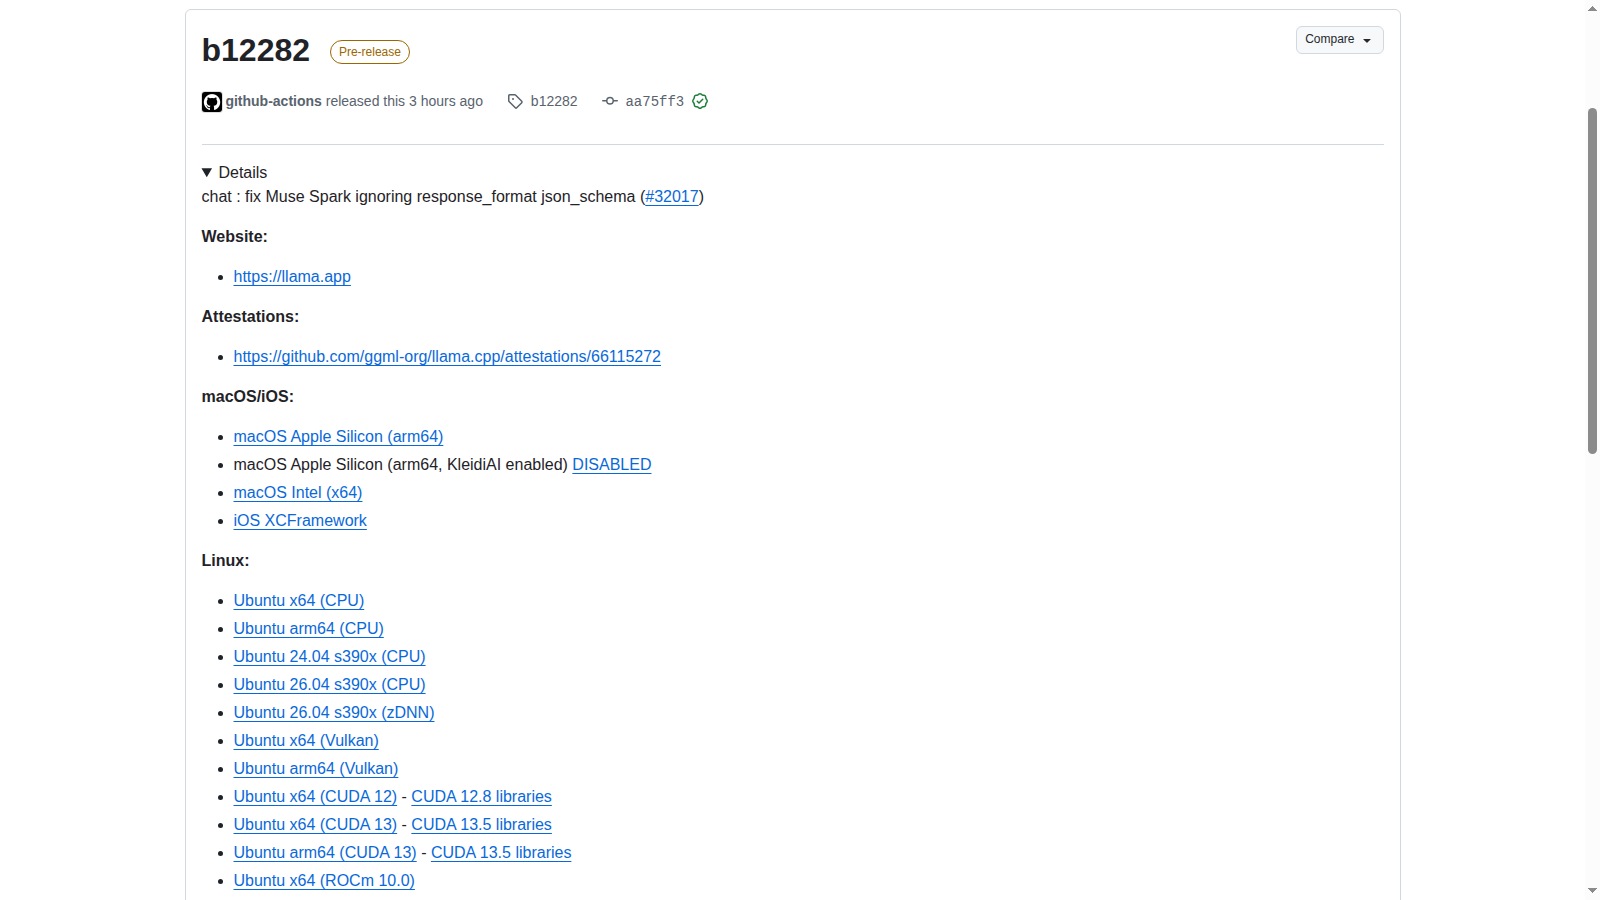
In breve: llama.cpp b12282, pubblicata l'11 novembre 2026, include la correzione di Muse Spark per response_format json_schema: la grammatica vincola il messaggio finale e lascia libero il ragionamento. Non modifica il comportamento di una grammatica GBNF grezza e non è una correzione generica per tutti i modelli. La release è prerelease e l'autore della PR dichiara di non averla provata sul modello reale. llama.cpp b12282: fix Muse Spark ignoring response_format json_schema.
Revisione documentale dell'11 novembre 2026: GET della pagina release, dei metadati b12282 e della PR 32017, confrontati con le copie primarie recenti. Verificate data di pubblicazione, marcatura prerelease e corrispondenza del commit con il merge. Nessuna installazione, richiesta al modello o esecuzione dei test del parser effettuata da noi.
Perché Muse Spark ignorava response_format json_schema?
In breve: la release b12282 è dell'11 novembre; include la PR 32017; riguarda il parser Muse Spark; resta una prerelease. La PR descrive un parser che costruiva una grammatica quando erano presenti strumenti, ma non applicava correttamente lo schema del formato di risposta. Il ripiego sul percorso di schema del server poteva anche fallire sul prefisso di generazione con un errore 400. Per chi indaga un malfunzionamento, distinguerei quindi uno schema non applicato da uno schema applicato a una porzione di messaggio incompatibile: i sintomi non richiedono necessariamente di riscrivere il prompt.
llama.cpp b12282: fix Muse Spark ignoring response_format json_schema · API GitHub: published_at 11 novembre 2026, stato prerelease e commit della release b12282 · PR 32017: grammatica del messaggio finale, due test del parser e nessuna prova sul modello reale.
Come vengono separati ragionamento e risposta finale?
La modifica costruisce una regola del formato di risposta per il messaggio finale quando json_schema è impostato, applicando una grammatica eager e lasciando il ragionamento libero. Il confine importante è quindi quale tratto dell'output riceve il vincolo, non la promessa che ogni token dell'intera conversazione sia JSON. Per un'integrazione proporrei di mantenere distinti il canale di ragionamento e l'oggetto finale destinato al programma. La validazione dell'applicazione dovrebbe riguardare il contenuto previsto dal contratto, senza includere prefissi o messaggi che non ne fanno parte.
PR 32017: grammatica del messaggio finale, due test del parser e nessuna prova sul modello reale.
Si può estendere il risultato a GBNF o a tutti i modelli?
No: l'autore precisa che una grammatica GBNF grezza non viene modificata dalla PR e continua ad applicarsi dal primo token. Il titolo e la descrizione circoscrivono il cambiamento a Muse Spark. Eviterei perciò formule come JSON Schema ora affidabile su ogni modello: farebbero sparire differenze tra parser, template e percorso di risposta. Anche la correzione allOf di b12254 è un altro strato, relativo alla conversione dello schema. Nella diagnosi proposta terrei separati formato inviato dal client, traduzione in grammatica e delimitazione del messaggio finale.
PR 32017: grammatica del messaggio finale, due test del parser e nessuna prova sul modello reale · PR 31834: correzione distinta della conversione allOf con tipi semplici.
Che cosa è stato provato dagli autori e che cosa no?
La PR riporta due casi test-chat: risposta finale diretta e risposta finale dopo un messaggio di ragionamento, descritti come fallenti prima della modifica e riusciti dopo. Dice però esplicitamente che il modello reale non è stato provato. Sono evidenze sul comportamento del parser, non una dimostrazione completa del servizio con pesi, client e streaming. Il merge risale al 10 novembre alle 22:30:15 UTC; la pubblicazione di b12282 è dell'11 novembre alle 03:31:06 UTC. Per raccontare la disponibilità della build uso quest'ultima data, senza trasformare il merge in un rilascio anticipato.
API GitHub: published_at 11 novembre 2026, stato prerelease e commit della release b12282 · PR 32017: grammatica del messaggio finale, due test del parser e nessuna prova sul modello reale.
Come controllerei l'integrazione: procedura proposta
Preparerei uno schema minimo con pochi campi e un validatore esterno, poi distinguerei una risposta finale diretta da una preceduta da ragionamento. Registrerei template, revisione, formato inviato e separazione dei messaggi. Solo dopo proporrei casi con strumenti, streaming e schemi più articolati, tenendo il percorso GBNF come confronto distinto e non come esito previsto della stessa patch. Un errore HTTP e un JSON non conforme andrebbero annotati separatamente. Questa procedura è proposta, non eseguita: non abbiamo avviato Muse Spark né verificato risposte reali.
API GitHub: published_at 11 novembre 2026, stato prerelease e commit della release b12282 · PR 32017: grammatica del messaggio finale, due test del parser e nessuna prova sul modello reale.
Checklist pratica
- Procedura proposta, non eseguita: fissare revisione, pesi, template e client prima di una verifica end-to-end.
- Controllare il formato response_format json_schema effettivamente inviato, senza confonderlo con GBNF grezzo.
- Separare i casi di risposta finale diretta e risposta finale dopo ragionamento.
- Validare soltanto il contenuto finale previsto dal contratto con un controllo esterno al modello.
- Registrare separatamente errori HTTP, schema ignorato e contenuto finale non conforme.
- Non generalizzare i test del parser a tutti i modelli o a un risultato sul modello reale non effettuato.
Condizioni e limitazioni
La PR dichiara due test del parser, non una prova sul modello reale. Il percorso GBNF grezzo rimane invariato. Non abbiamo misurato affidabilità, compatibilità di ogni schema o comportamento dei client: il perimetro confermato è la correzione documentata per Muse Spark.