
L’ANALISI
llama.cpp: shard e file PLE da percorsi diversi
llama.cpp b12233 aggiunge il caricamento da più percorsi e file PLE separati. --shard e --ple sono alias: non è una misura di risparmio RAM.
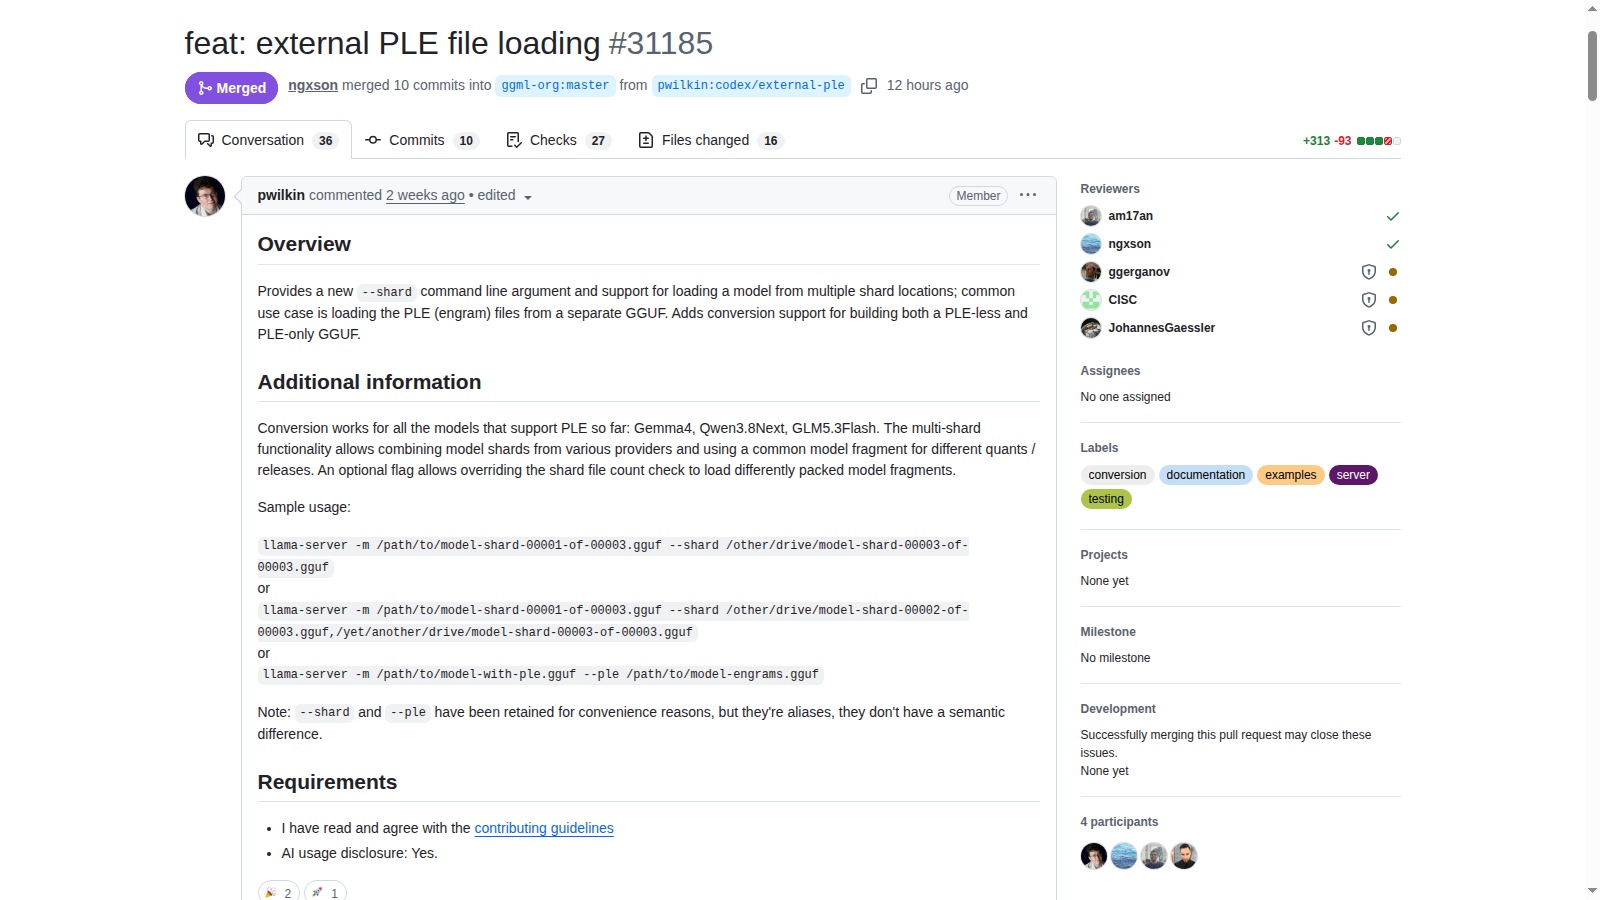
In breve: llama.cpp b12233 consente di fornire shard da percorsi separati, anche per caricare un file PLE distinto dal modello. --shard e --ple sono alias: il cambiamento riguarda l’organizzazione dei file, non dimostra meno RAM occupata o maggiore velocità. llama.cpp: PR 31185, caricamento di file PLE esterni.
Verificati PR 31185, merge del 9 novembre e note della release b12233. Nessun binario compilato, peso scaricato o comando di conversione eseguito.
Quale organizzazione dei file diventa possibile?
La PR introduce il caricamento da più posizioni: un frammento può rimanere nel percorso principale e un altro su una posizione diversa. Il caso d’uso indicato è separare i file PLE, chiamati anche engram nella descrizione, in un GGUF distinto. Il lavoro include conversioni con PLE separati o esclusi per i modelli supportati. Non è il rilascio di un nuovo checkpoint e non dimostra che frammenti di modelli non corrispondenti possano essere combinati senza controlli.
llama.cpp: PR 31185, caricamento di file PLE esterni · llama.cpp b12233: note e stato della release.
--shard e --ple hanno comportamenti diversi?
La descrizione precisa che i due nomi sono conservati per comodità ma sono alias, senza differenza semantica. Le note della release mostrano anche la gestione di più percorsi e la deduplicazione dei file. Questo conta quando si prepara una configurazione: usare --ple non è una richiesta implicita di consumare meno memoria, né un meccanismo di offload distinto. Occorre verificare il caricamento effettivo degli stessi tensori e conservare un manifesto dei file forniti al server.
llama.cpp: PR 31185, caricamento di file PLE esterni · llama.cpp b12233: note e stato della release.
Quali numeri non si possono dedurre dalla novità?
Il fatto di separare un file o spostarlo su un altro disco non dimostra una riduzione della memoria necessaria al modello o un miglioramento della generazione. Tempo di caricamento, memoria dei pesi e token al secondo sono misure diverse. Per un confronto occorrono gli stessi contenuti, lo stesso hardware e log che mostrino quali frammenti sono stati caricati. Qui non è stato eseguito alcun benchmark: la novità verificata è il percorso di configurazione descritto dal progetto.
llama.cpp: PR 31185, caricamento di file PLE esterni · llama.cpp b12233: note e stato della release.
Come preparare una prova senza alterare gli originali?
Usare copie dei file e conservare hash, origine e ordine dei frammenti. Partire da una configurazione nota funzionante e cambiare solo la loro collocazione, controllando che il binario contenga la modifica. Leggere l’help di quel binario prima di usare le opzioni perché una descrizione di PR può includere passaggi intermedi del lavoro. Verificare caricamento completo e risposta di controllo, poi misurare separatamente tempi e memoria. Tenere intatta la configurazione precedente per il ripristino.
llama.cpp: PR 31185, caricamento di file PLE esterni · llama.cpp b12233: note e stato della release.
Condizioni e limitazioni
Build marcata prerelease. Nessuna conversione GGUF, prova di caricamento o misura di memoria eseguita qui. La compatibilità dei frammenti va verificata: percorsi diversi non rendono intercambiabili tensori e metadati arbitrari.
Checklist pratica
- Registrare build e stato prerelease.
- Conservare origine, ordine e hash dei frammenti.
- Leggere l’help del binario realmente usato.
- Trattare --shard e --ple come alias, non come ottimizzazioni diverse.
- Verificare caricamento e risposta prima di confrontare memoria o velocità.