
L’ANALISI
llama.cpp su Windows: caricamento senza buffer di sistema
llama.cpp integra la PR 26014 per leggere i modelli senza buffer su Windows. Fallback e test nel codice, nessun benchmark Windows replicato.
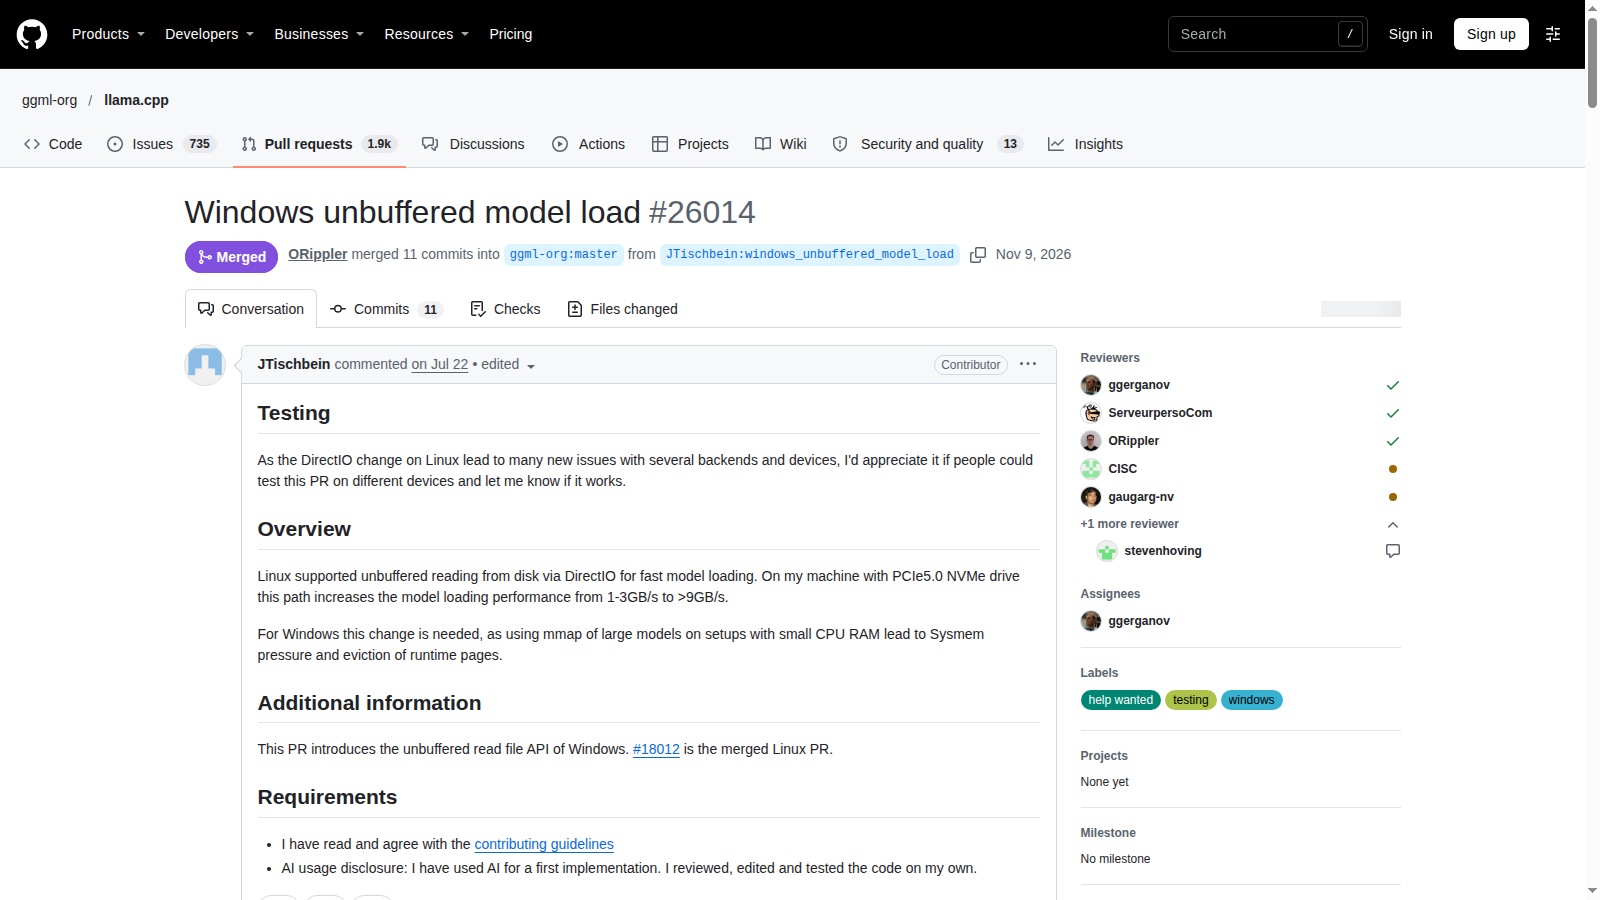
In breve: llama.cpp ha integrato il percorso di lettura Windows senza buffer del sistema nella PR 26014. La novità riguarda il caricamento del file: non dimostra da sola più token al secondo, meno memoria per i pesi o compatibilità con ogni disco e backend. llama.cpp: PR 26014, Windows unbuffered model load.
Verifica della PR unita, dell’hash di merge e dei tre file modificati. Nessuna compilazione o esecuzione Windows e nessun test su disco o modello eseguiti. Il tag apparso nel feed non è trattato come release REST verificata.
Cosa è stato integrato il 9 novembre?
La PR risulta unita con hash 9d340ec341e079d2c28afd50871afce358cdbf48 e modifica tre file. L’autore motiva il lavoro con il caricamento di grandi modelli su configurazioni Windows con poca RAM di sistema. È una modifica del percorso di lettura, non un checkpoint nuovo. Per provarla occorre sapere quale commit contiene davvero il binario usato: la sola comparsa di un numero di build nel feed non basta a identificare contenuto e stato della distribuzione.
llama.cpp: PR 26014, Windows unbuffered model load.
Come gestisce allineamento e ritorno al buffer?
Il diff mantiene un handle con buffer per il cursore logico e ne apre uno separato per l’I/O diretto. Controlla i requisiti di allineamento, legge tramite un buffer allineato e prevede il ritorno al percorso con buffer per specifici errori. Questo dettaglio conta nel test: un caricamento riuscito può aver usato il fallback. Conservare i log e verificare il percorso effettivo prima di attribuire un tempo migliore alla nuova modalità.
llama.cpp: diff e test dei file modificati.
Perché non è un benchmark Windows?
La descrizione della PR riporta velocità osservate dall’autore per il precedente DirectIO Linux, non una comparazione Windows eseguita qui. Non trasferire quei numeri fra sistemi. Inoltre tempo di apertura del modello, picco di memoria e velocità di generazione sono misure diverse. Il protocollo proposto separa caricamento a cache fredda e calda e registra hardware, modello, opzioni e percorso I/O; senza queste condizioni un singolo tempo non consente un confronto riproducibile.
llama.cpp: PR 26014, Windows unbuffered model load · llama.cpp: diff e test dei file modificati.
Come preparare una prova senza cambiare produzione?
Usare un ambiente Windows separato, lo stesso modello e due binari identificati per commit. Salvare hash del file e configurazione, poi confrontare il caricamento senza aggiornare insieme driver o backend. Il diff include un test dedicato alla lettura: la sua presenza non equivale a una nostra esecuzione. Prima di adottare la modifica verificare caricamento completo, log del fallback e una risposta di controllo. Conservare il binario precedente per tornare indietro se il percorso non si comporta come atteso.
llama.cpp: diff e test dei file modificati.
Condizioni e limitazioni
Nessuna misura Windows replicata. Le velocità citate dall’autore nella descrizione riguardano il precedente percorso Linux sul suo NVMe: non sono risultati Windows. Merge e release distribuibile restano stati distinti.
Checklist pratica
- Identificare il commit del binario e l’hash del modello.
- Usare un ambiente separato con configurazione invariata.
- Registrare nei log I/O diretto e eventuale fallback.
- Separare caricamento freddo, caldo e generazione.
- Verificare la risposta di controllo e conservare il vecchio binario.