
LA SETTIMANA IN AI
9–15 novembre 2026
Ollama e llama.cpp cambiano API e inferenza; Strands distingue costo e compito, Fireworks i percorsi dati. OpenAI chiede valutazioni formative.
In questa settimana 24 notizie
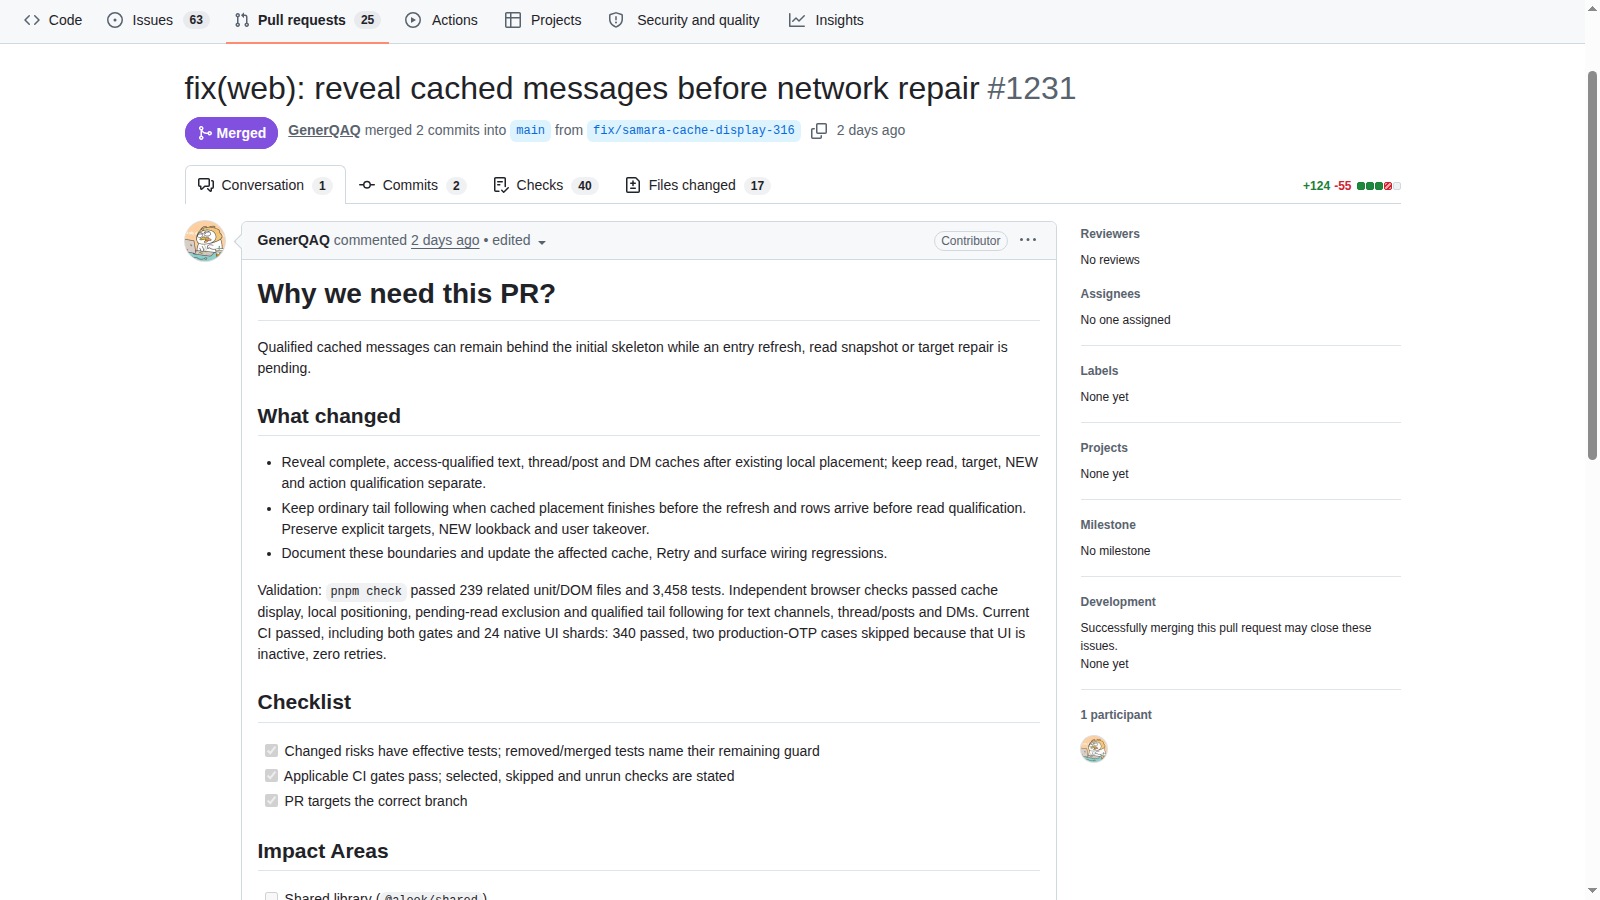
Alook separa due stati spesso confusi nelle interfacce per collaborare con gli agenti: contenuto locale già mostrabile e azioni ancora da abilitare. Il delta 0.1.66 riguarda la disponibilità visiva della cache web, non una promessa di funzionamento integralmente offline.
Limiti da conoscere
Limite: La PR interessa l’app web. Serve una cache completa e qualificata per l’accesso; una cache presente non basta a rendere disponibili tutte le azioni. Nessuna verifica indipendente di installazione, sincronizzazione o uso offline completo.
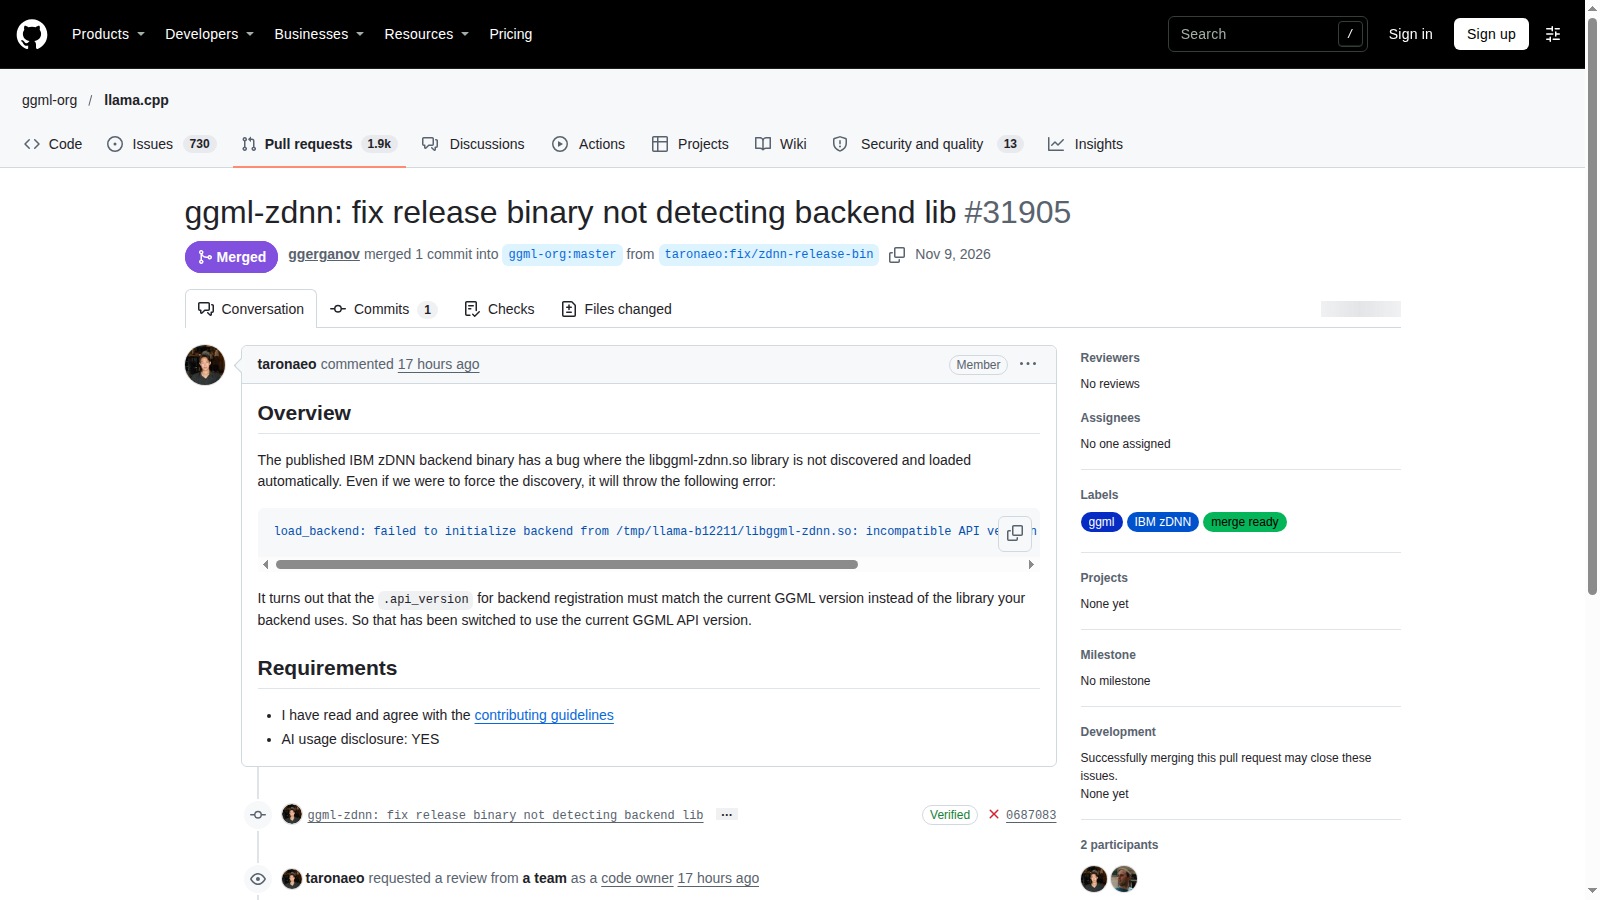
La correzione IBM zDNN chiude un problema prima di ogni benchmark: se la libreria non viene caricata, la presenza del binario non prova che l’acceleratore sia in uso. b12212 è indicata come pre-release.
Limiti da conoscere
Limite: Build marcata pre-release. La correzione riguarda IBM zDNN; nessun test indipendente su IBM Z o LinuxONE e nessun aumento di prestazioni misurato.
OpenCL amplia la copertura delle operazioni per i test delle architetture, mentre zDNN corregge il caricamento del backend. Sono due livelli diversi della compatibilità: nessuno dei due sostituisce una misura sul proprio hardware.
Limiti da conoscere
Limite: Nessun benchmark indipendente, nessuna misura di velocità e nessuna garanzia per ogni GPU o modello. Pagina del tag verificata; stato stable della release non attestato dall’API.
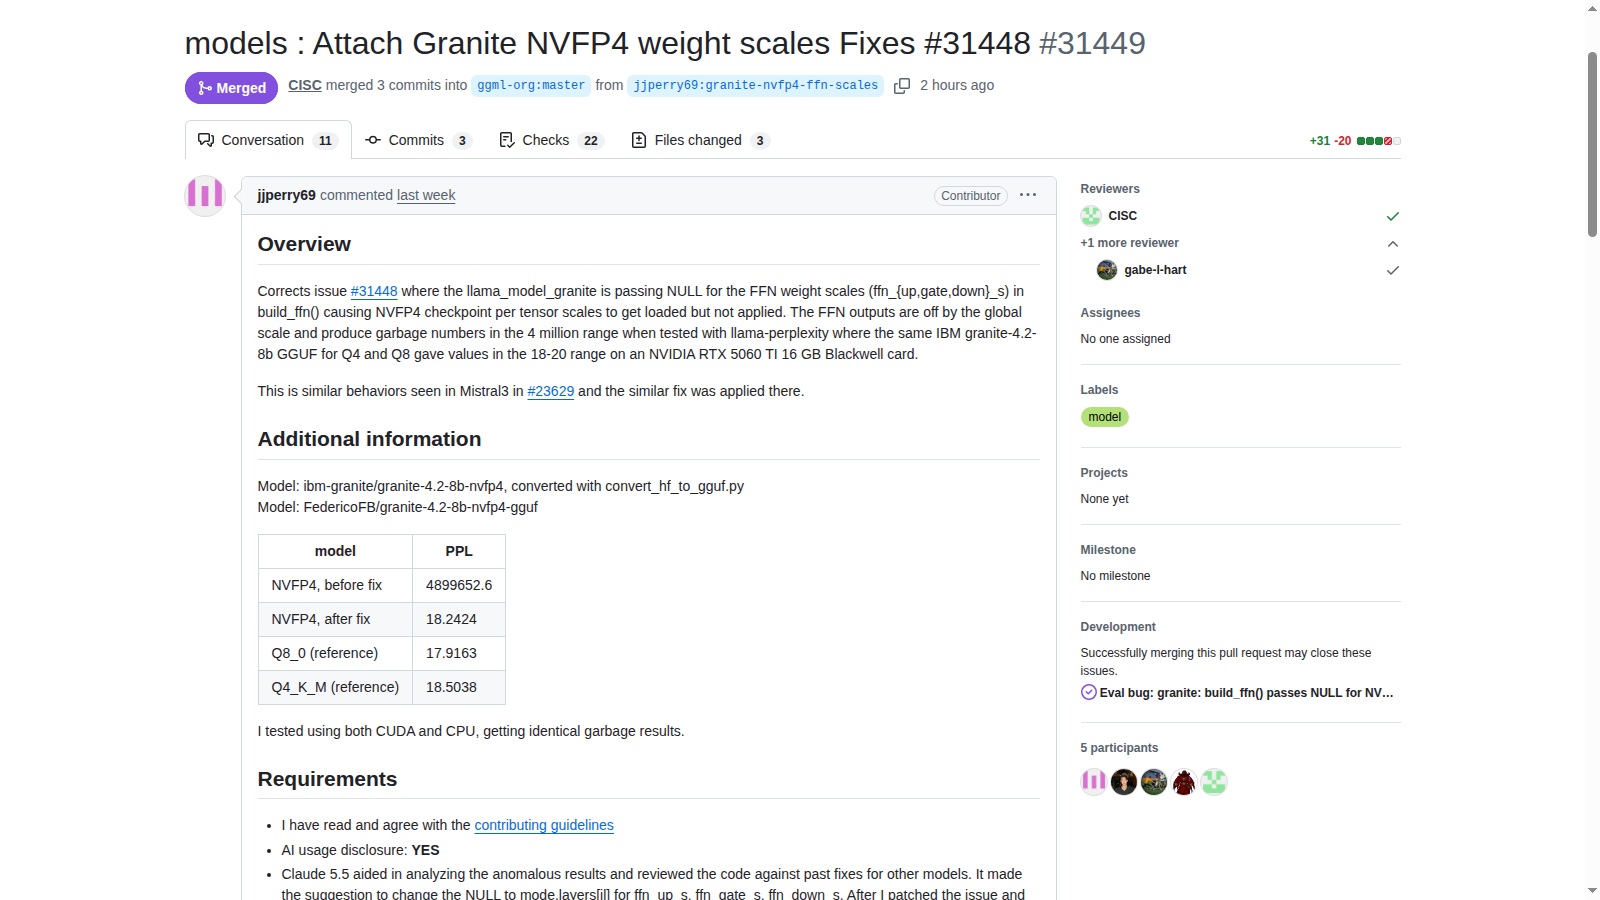
Dopo i fix di caricamento zDNN e copertura OpenCL, Granite NVFP4 mette a fuoco un terzo livello: un modello può avviarsi ma applicare male le scale. Prima del confronto prestazionale va controllata la correttezza dell'output.
Limiti da conoscere
Limite: b12223 è marcata pre-release, non stable; esiste già b12224. La perplexity riportata appartiene all'autore della PR: nessuna replica indipendente o misura di velocità.
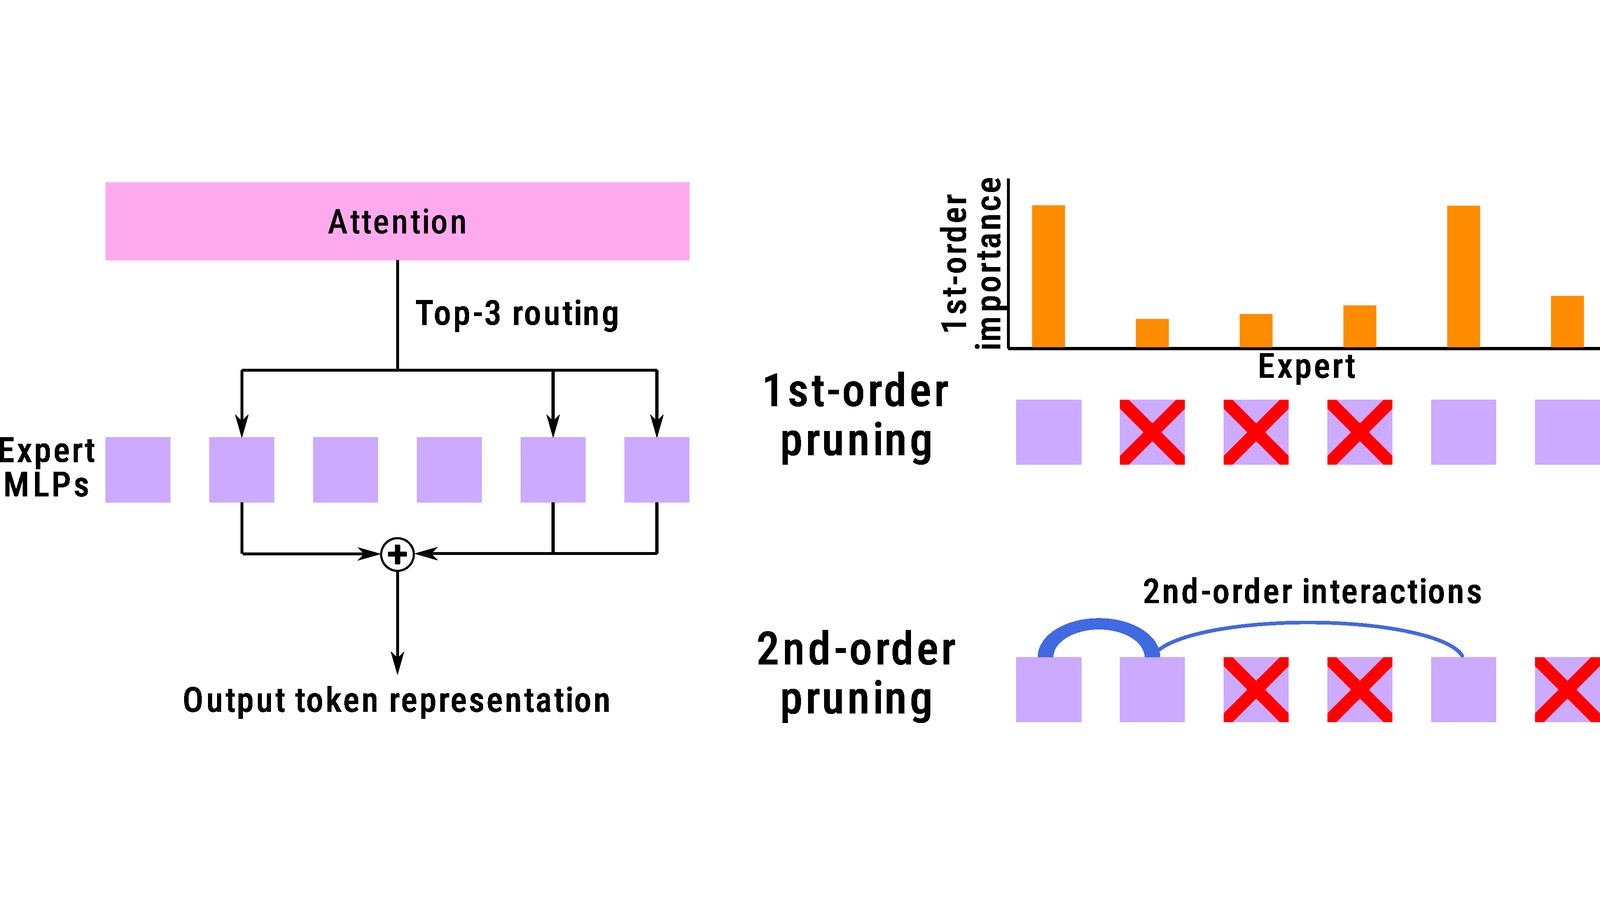
HOPE sposta il confronto dalla sola quantizzazione alla scelta degli esperti da conservare. Il tutorial del 9 novembre documenta una pipeline, ma la sua utilità va verificata sul proprio carico: metodo pubblicato a settembre e risultati degli autori non equivalgono a una riduzione di costo già misurata qui.
Limiti da conoscere
Limite: Paper v1 del 16 settembre, non nuova ricerca di oggi. Risultati degli autori; compatibilità limitata dal layout degli esperti, nessuna prova propria di qualità, memoria o integrazione llama.cpp.
Spacefast affronta ciò che viene dopo la generazione del codice: pubblicazione, accesso e ritorno a una versione precedente. Rispetto ai fix dei runtime locali cambia il livello della decisione: un’infrastruttura gestita dal fornitore, non un agente o un modello da eseguire in casa.
Limiti da conoscere
Limite: L’annuncio definisce il login nelle app in arrivo; il setup lo indica in Private Beta insieme alle email transazionali. Non sono una garanzia di disponibilità generale. Nessun nostro test operativo o confronto di costo.
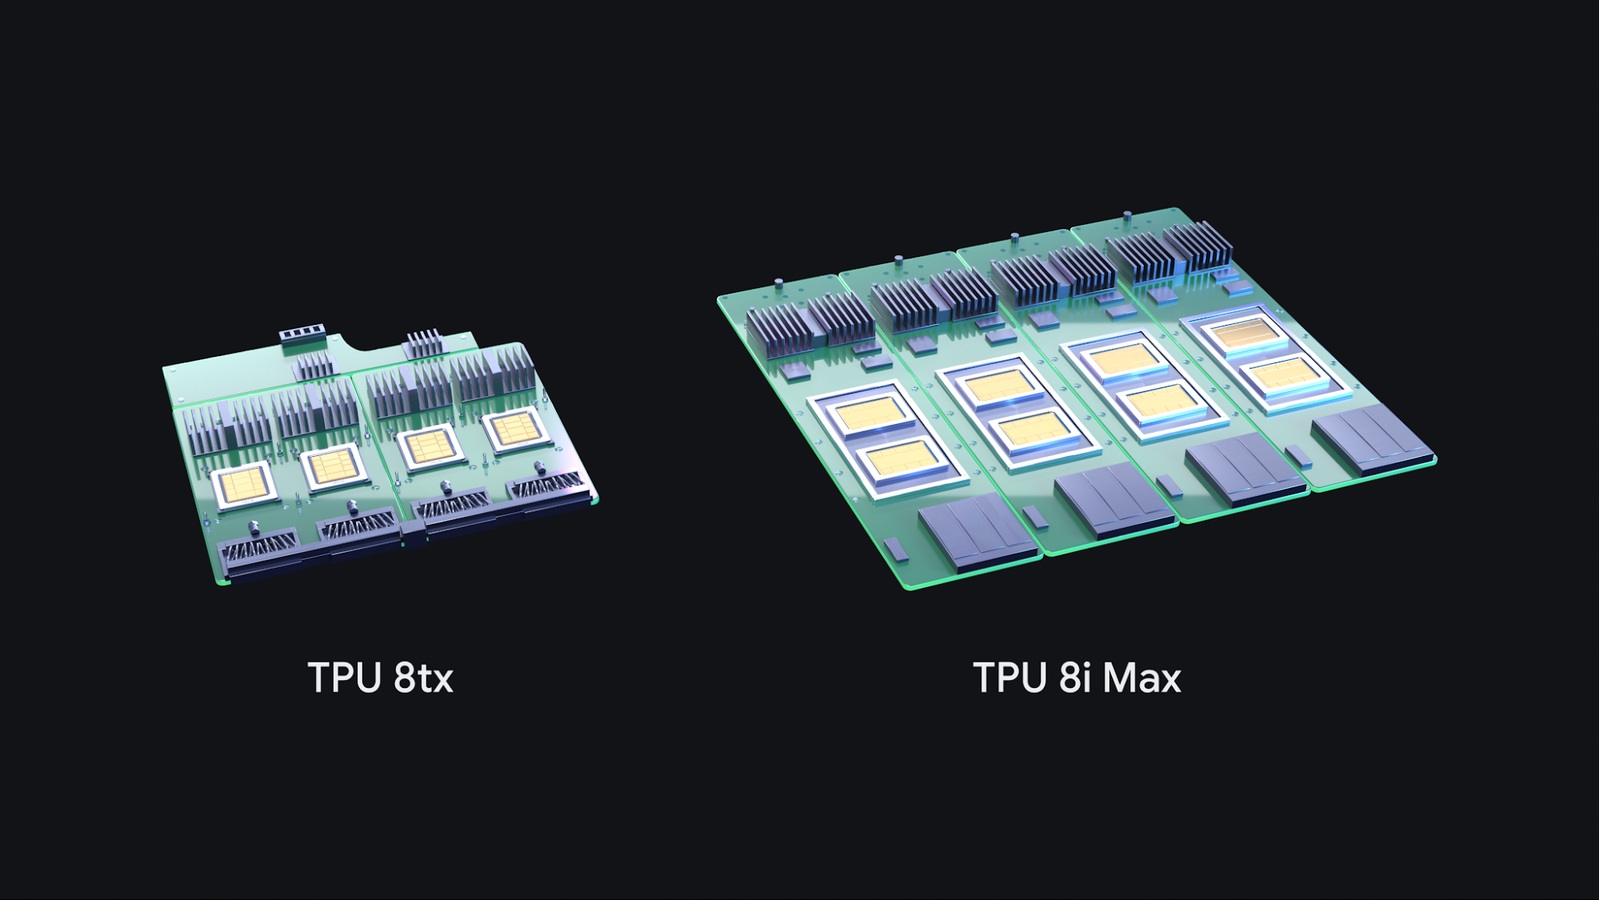
Google separa due colli di bottiglia: proteggere dati e pesi durante l’elaborazione, oppure sostenere contesti estesi con più risorse di memoria. Queste configurazioni non sostituiscono i test sul proprio runtime e non dimostrano automaticamente un risparmio per chi esegue modelli locali.
Limiti da conoscere
Limite: Le prestazioni riportate appartengono a Google. Non sono stati verificati prezzi, regioni, quote o disponibilità acquistabile delle due configurazioni; nessuna conclusione di conformità o risparmio automatico.
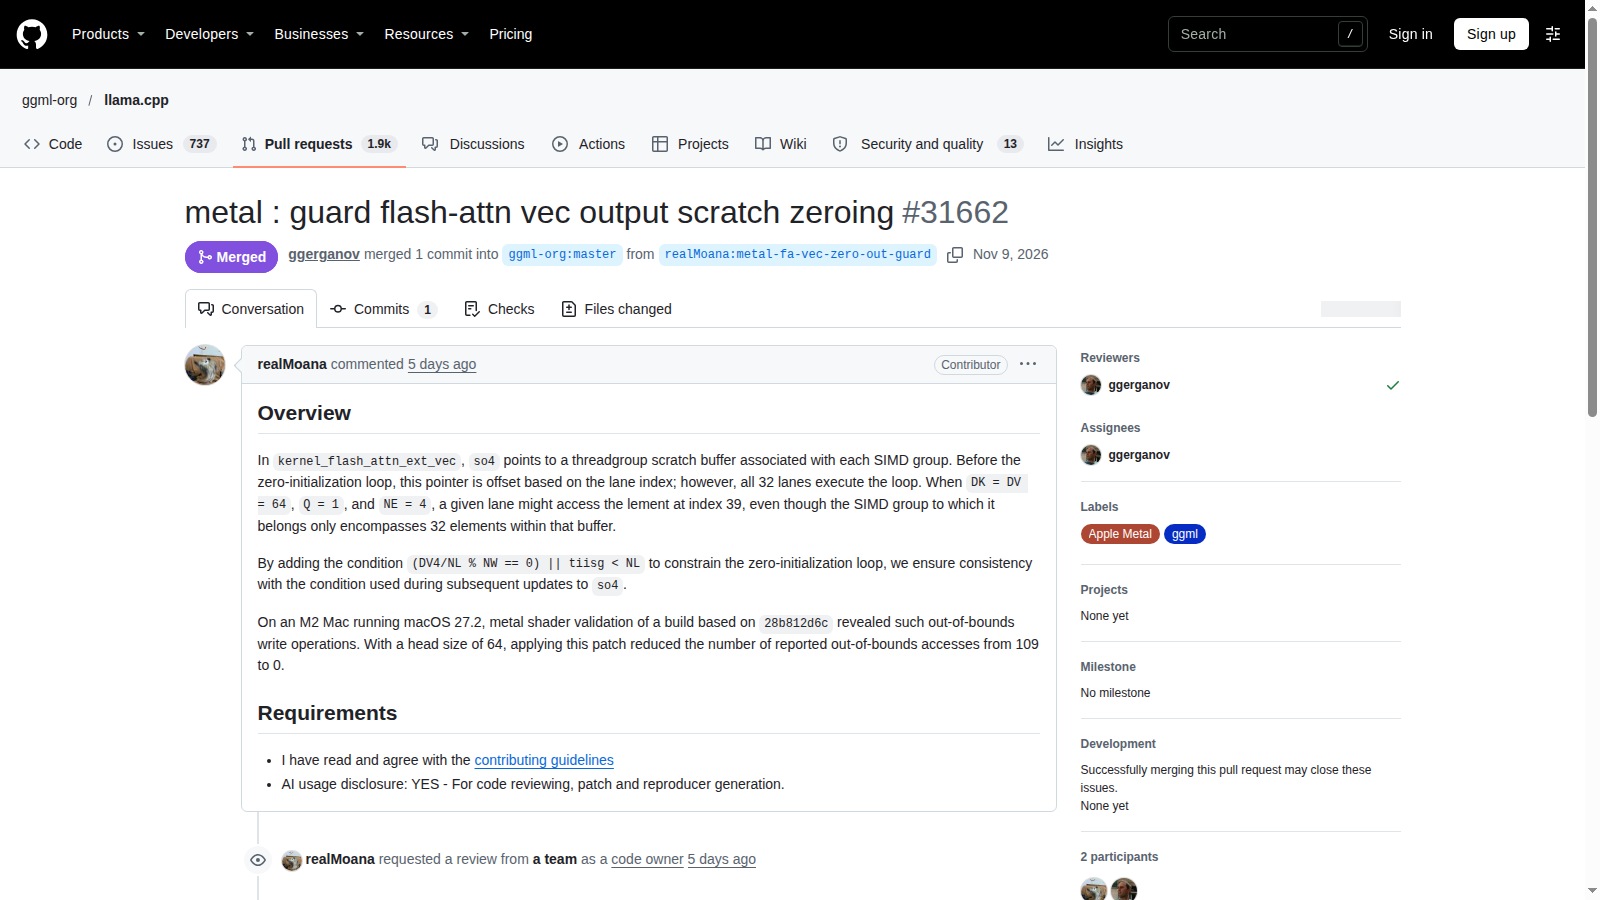
Dopo avvio dei backend e scale numeriche, la correzione Metal aggiunge un altro controllo di correttezza: le scritture del kernel devono restare nei limiti del buffer. Il risultato M2 è quello dell’autore; va tenuto separato da prestazioni e stabilità dell’intera applicazione.
Limiti da conoscere
Limite: b12221 è una pre-release e il punto di introduzione del fix, non una dichiarazione sull’ultima build disponibile. Il risultato 109→0 è dell’autore su M2/macOS 27.2; nessuna nostra replica, CVE o promessa di velocità.
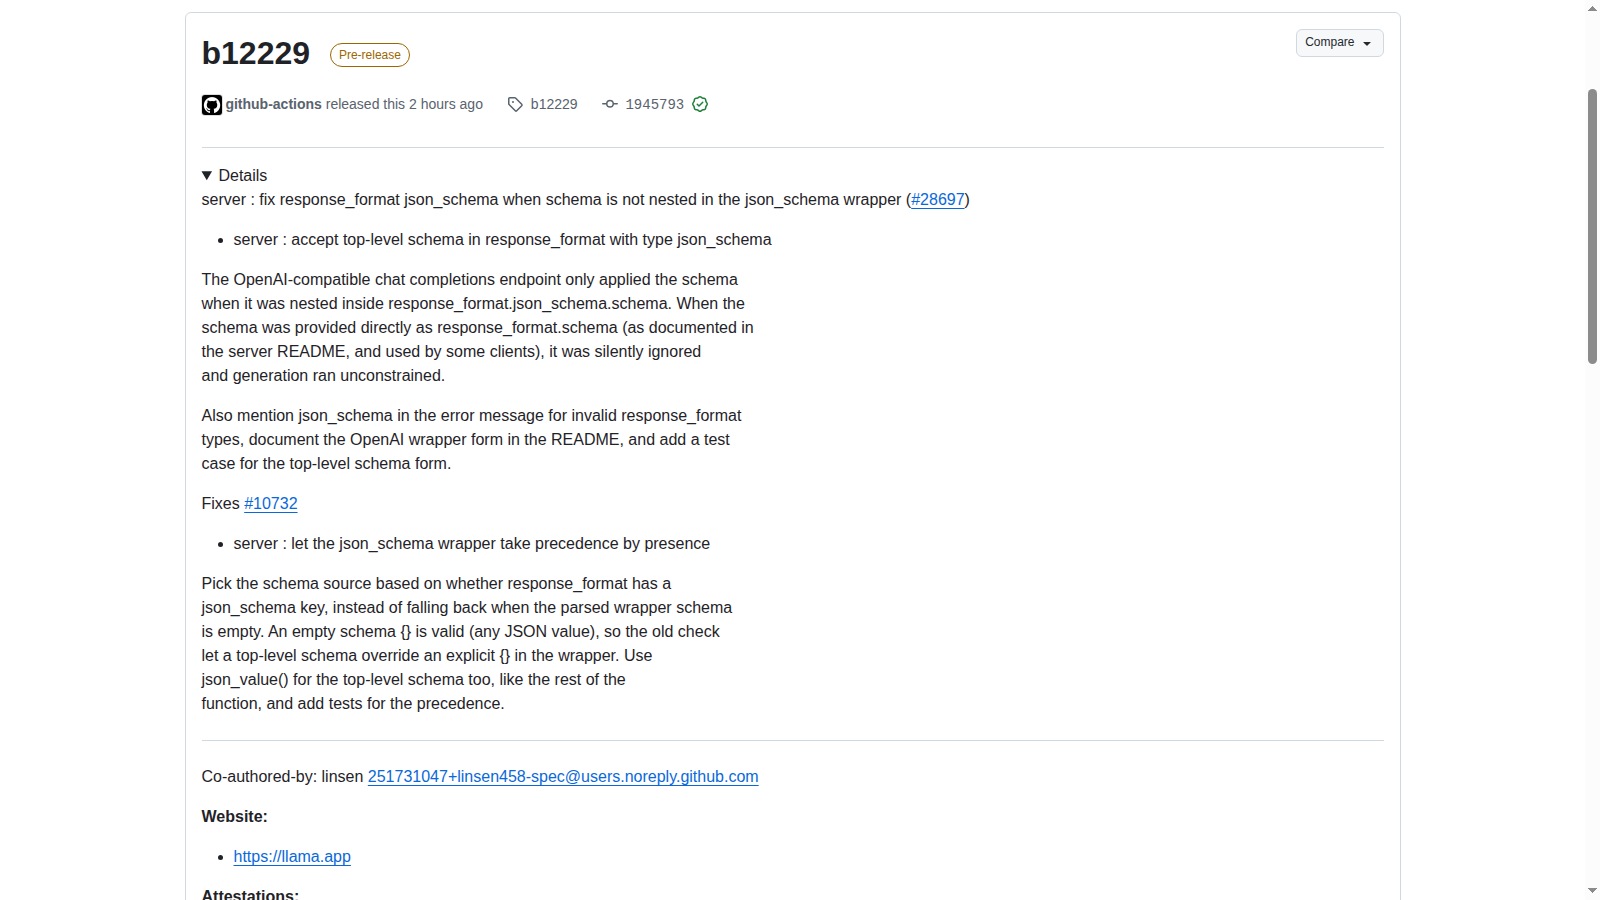
Il fix JSON sposta il controllo dalla memoria del backend al contratto fra client e server: una richiesta può essere accettata senza applicare il vincolo atteso. Per gli agenti che consumano dati strutturati, validare il risultato resta necessario anche dopo una correzione del parsing.
Limiti da conoscere
Limite: b12229 è marcata pre-release. I test aggiunti sono prova del contratto nel repository, non una nostra esecuzione né una garanzia su tutti gli schemi JSON o su ogni client compatibile.
Fable e Mythos 5.2 spostano la scelta dal solo punteggio al perimetro di accesso: stesso modello di base, protezioni diverse e modalità rapida separata nel listino. Prima del confronto con Muse Ember serve definire il compito, non soltanto il costo di un token.
Limiti da conoscere
Limite: I benchmark non sono una nostra prova. Mythos non è aperto indistintamente a tutti; modalità rapida, disponibilità e regole sui dati vanno verificate per lo specifico canale e contratto.
Muse Ember affronta i molti passaggi piccoli di un agente, mentre Fable 5.2 punta ai lavori tecnici più complessi. Il confronto utile è un instradamento controllato fra compiti, non una sostituzione generale basata sul solo prezzo per token.
Limiti da conoscere
Limite: Nessun benchmark o risparmio replicato. Prezzi base fino a 200K token di prompt; oltre la soglia valgono 0,30 dollari input e 1,50 output per milione. L’annuncio API non dimostra pesi pubblici o inferenza locale.
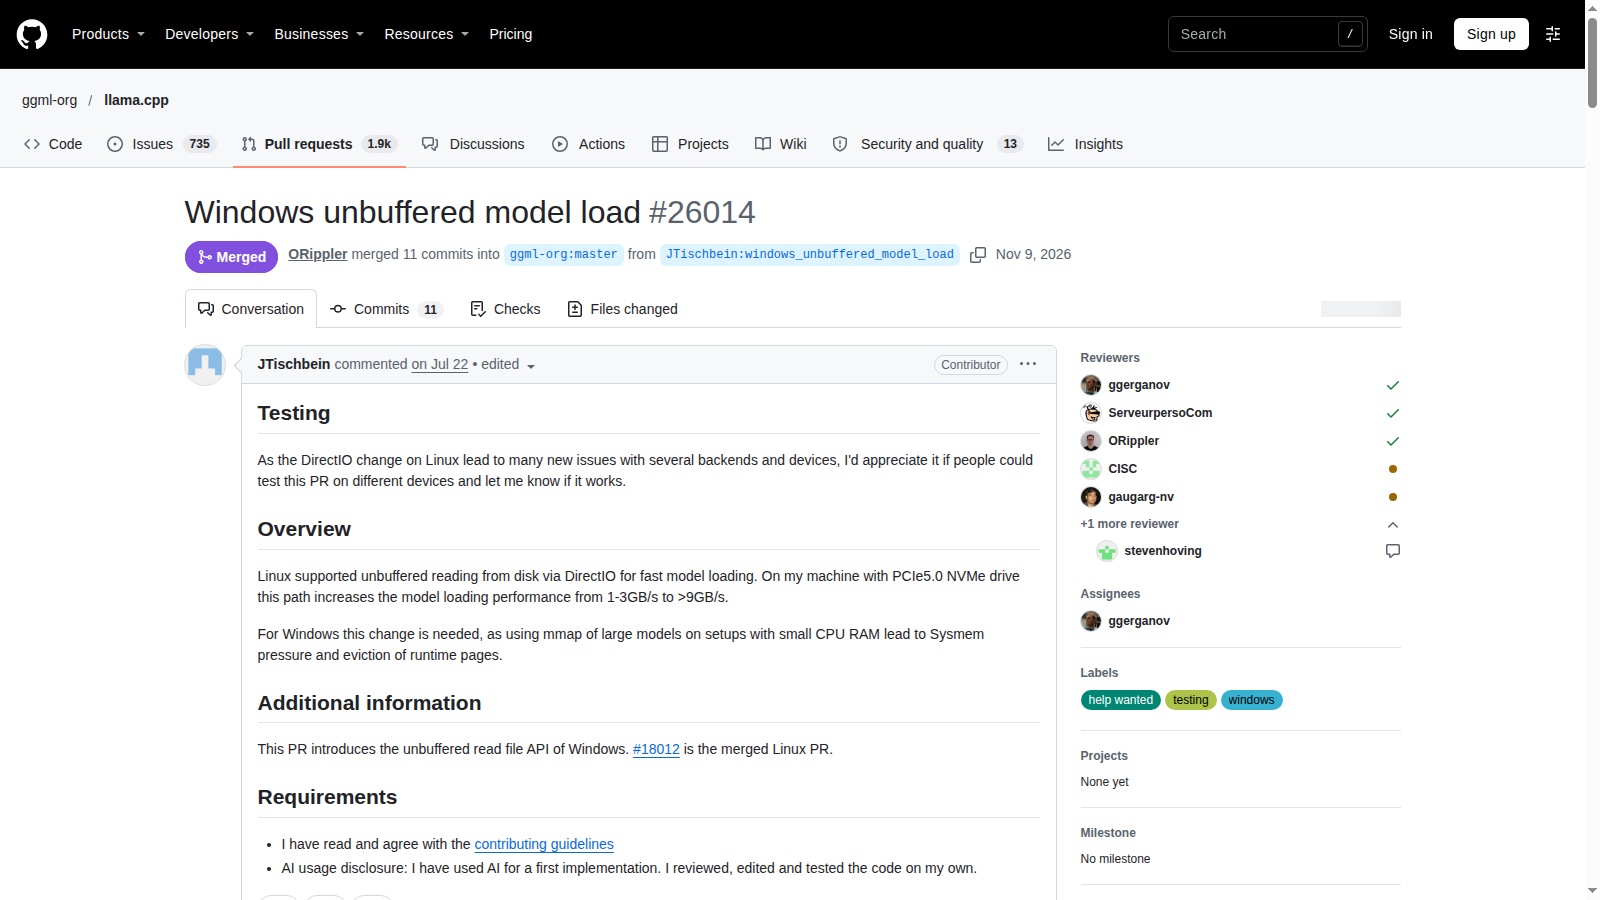
Dopo le correzioni a backend e calcolo, llama.cpp interviene anche sul percorso di caricamento Windows. È un cambiamento di I/O: va misurato prima del primo token e distinto sia dalla qualità numerica sia dalla velocità di generazione.
Limiti da conoscere
Limite: Nessuna misura Windows replicata. Le velocità citate dall’autore nella descrizione riguardano il precedente percorso Linux sul suo NVMe: non sono risultati Windows. Merge e release distribuibile restano stati distinti.
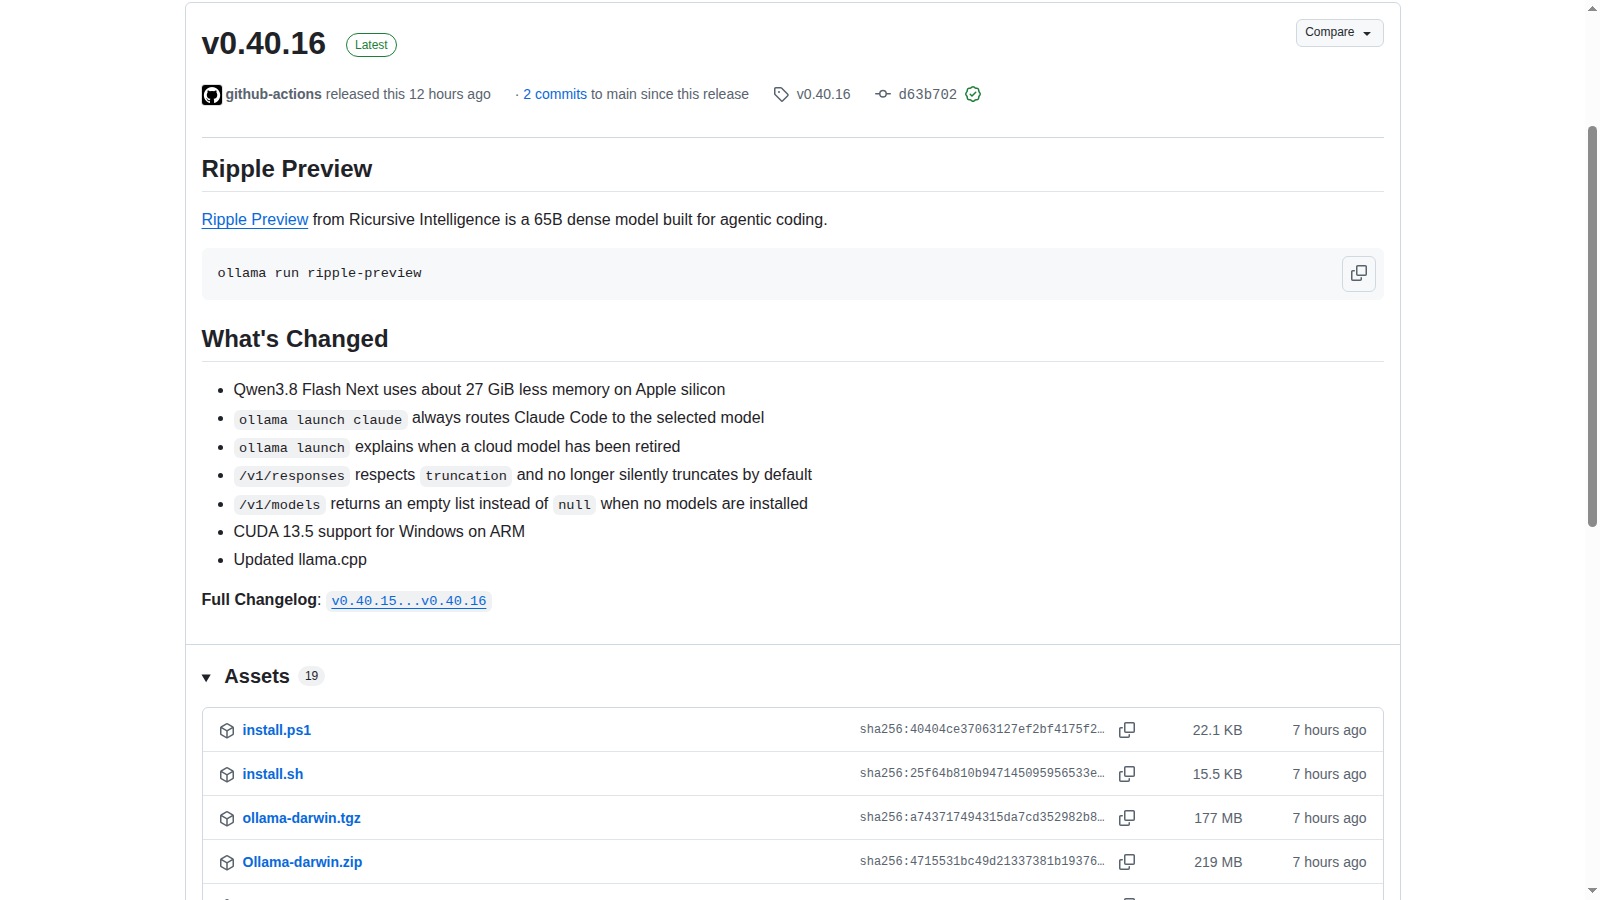
Ollama corregge un comportamento che poteva nascondere una perdita di input. Il punto pratico non è avere un contesto illimitato, ma rendere esplicita la scelta di troncamento e controllare cosa succede quando il documento supera il limite configurato.
Limiti da conoscere
Limite: Verifica di release e PR ufficiali, senza inferenza comparativa. La correzione riguarda /v1/responses; memoria disponibile, contesto configurato e comportamento del client restano vincoli separati.
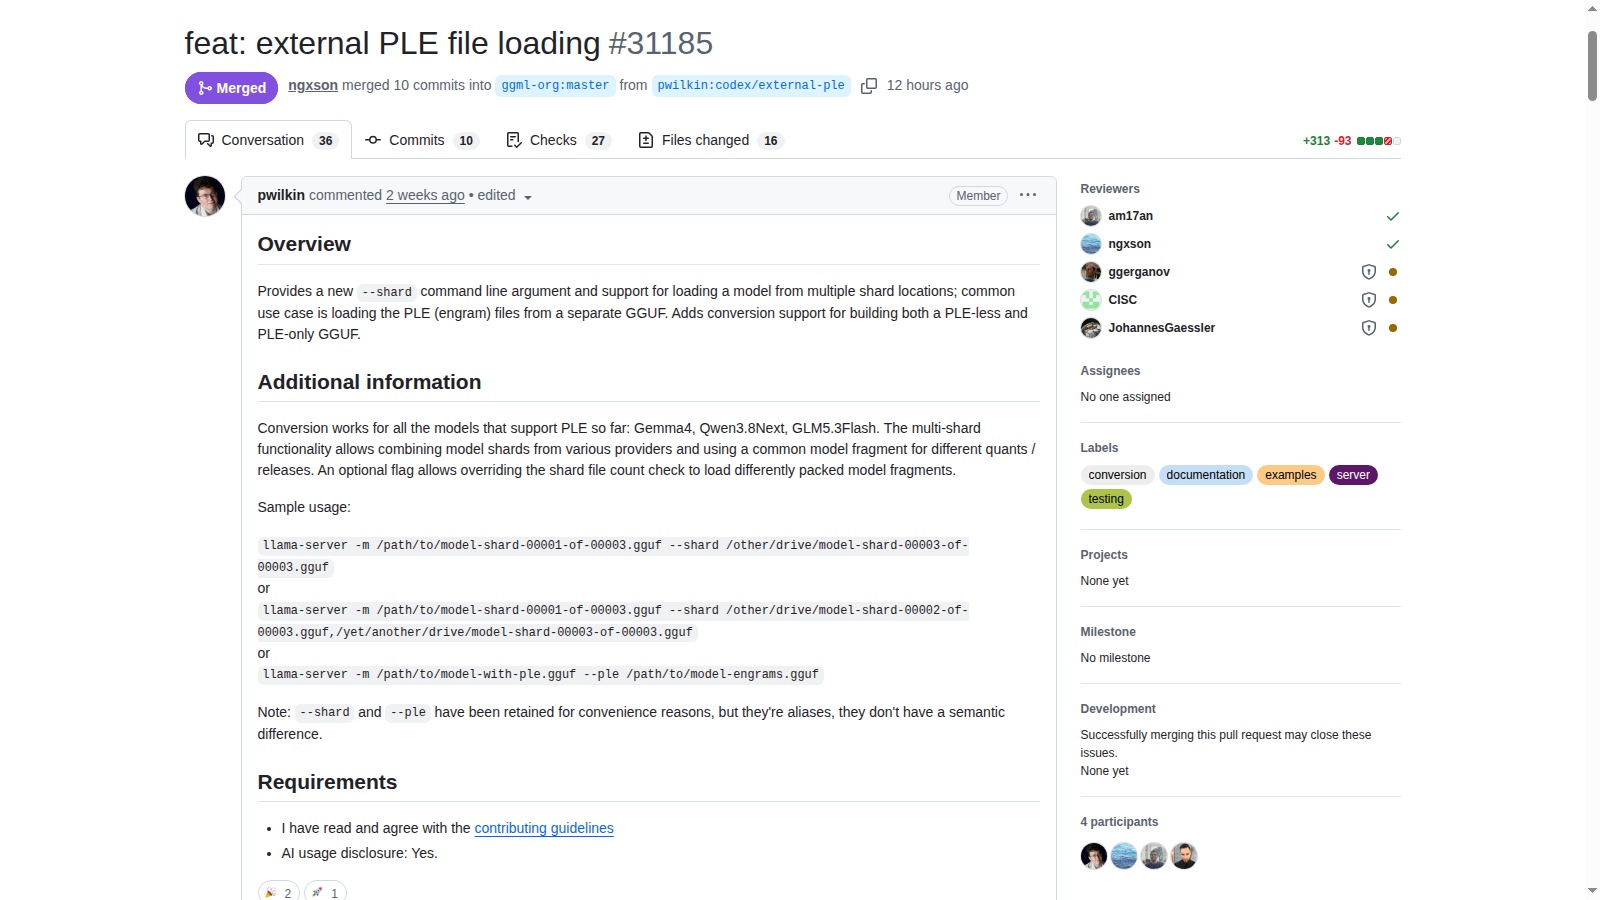
Il caricamento multipercorso cambia come organizzare gli artefatti, mentre il fix Windows già coperto cambia il percorso I/O. Sono delta distinti e nessuno dei due, da solo, prova una riduzione di memoria o un aumento della velocità di generazione.
Limiti da conoscere
Limite: Build marcata prerelease. Nessuna conversione GGUF, prova di caricamento o misura di memoria eseguita qui. La compatibilità dei frammenti va verificata: percorsi diversi non rendono intercambiabili tensori e metadati arbitrari.
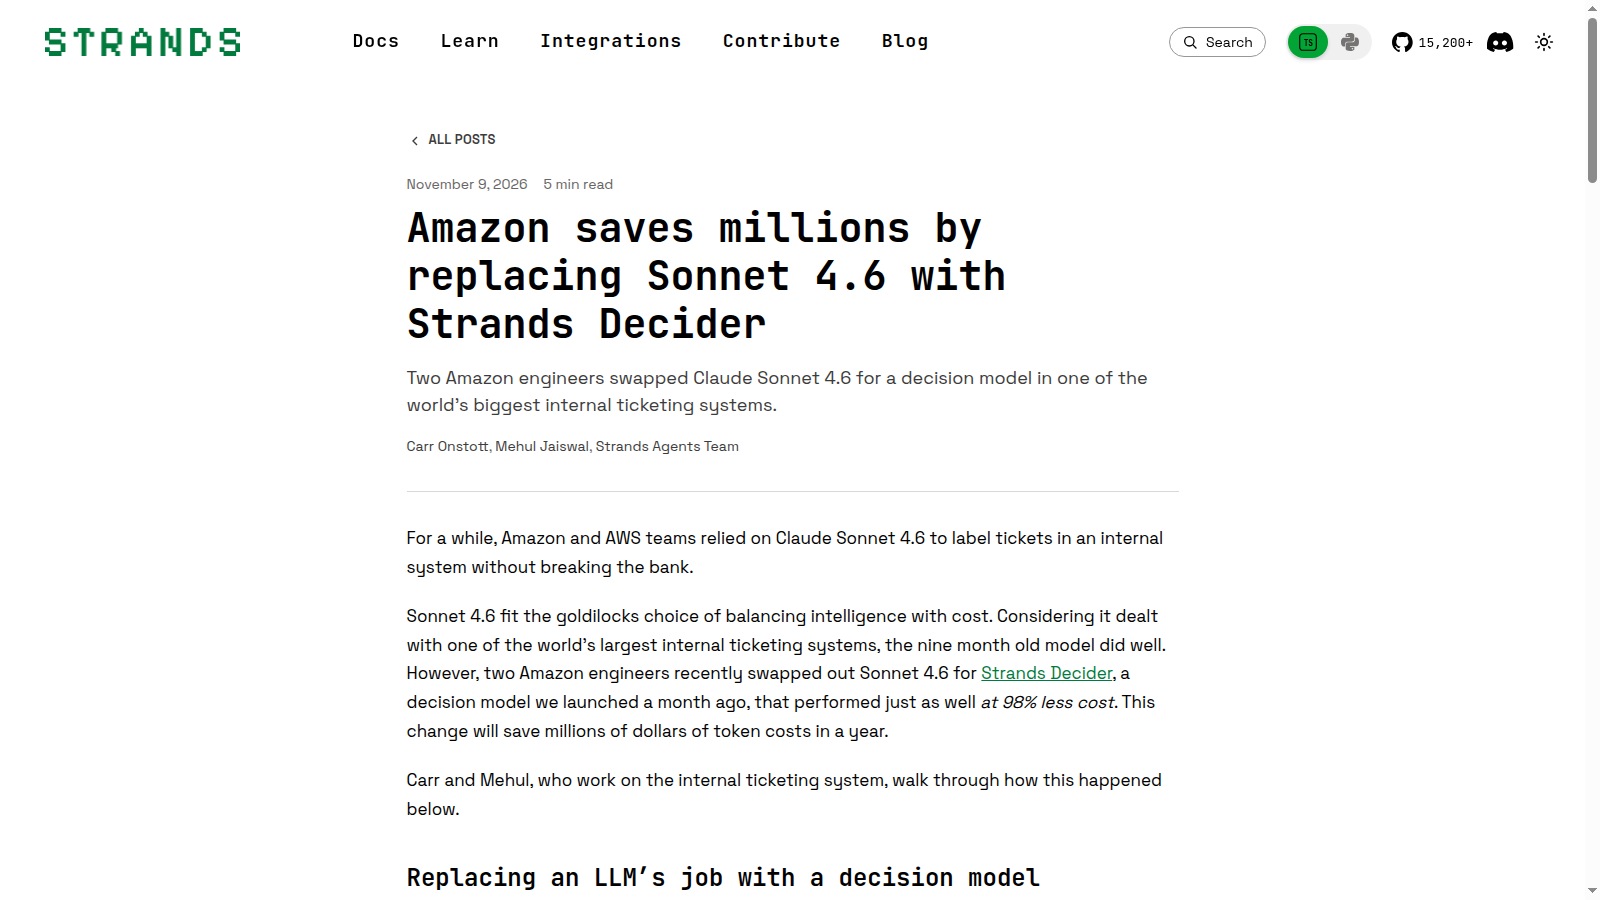
Il caso Amazon mette il costo in relazione al compito: scegliere una categoria consente un modello decisionale. Il risparmio dichiarato non va confrontato con prezzi API senza considerare utilizzo delle istanze, contesto conservato e gestione delle astensioni.
Limiti da conoscere
Limite: Nei ticket lunghi il caso elimina i commenti più vecchi per rientrare nel contesto; l'ordine delle chiavi JSON può modificare le probabilità. Il supporto Gemma 4 è dichiarato nel repository main, non ancora nel pacchetto PyPI. Nessuna prestazione italiana verificata.
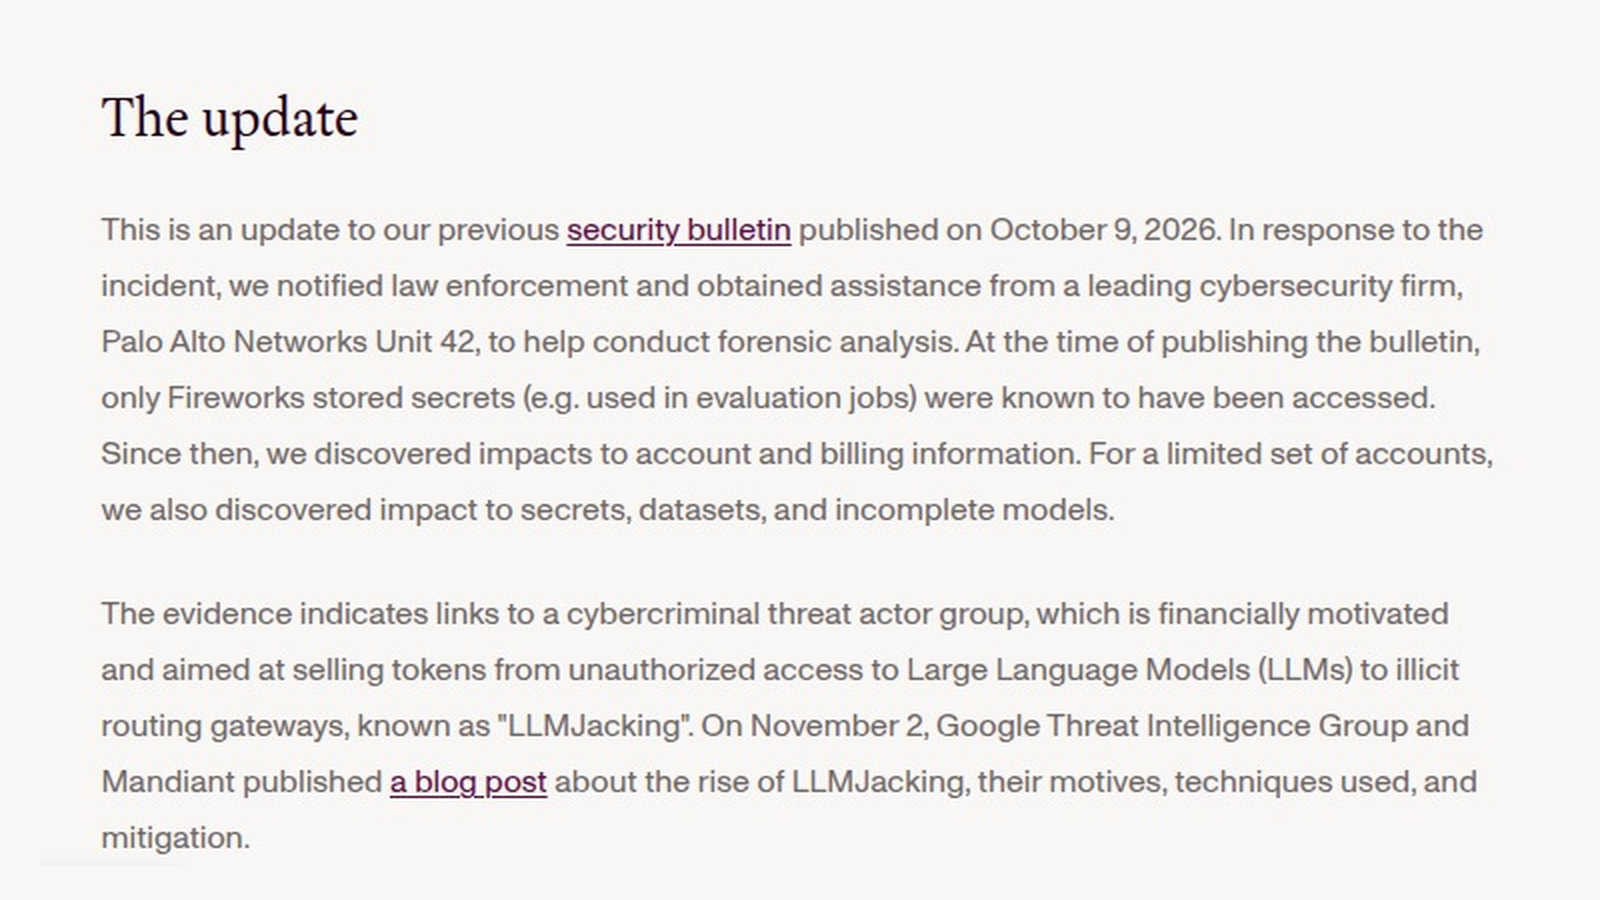
Il bollettino Fireworks richiede di distinguere i percorsi dati, non di trattare ogni servizio AI allo stesso modo: dataset persistenti e informazioni account hanno un perimetro diverso dall'inferenza che il fornitore dichiara non coinvolta nelle evidenze raccolte finora.
Limiti da conoscere
Limite: Fireworks dichiara di non aver rilevato impatti su Inference, Training SDK e Nexus e precisa che l'indagine continua. L'attività aggiuntiva descritta risale al 23 e 24 ottobre. L'assenza di evidenze nel bollettino non certifica l'assenza assoluta di esposizione.
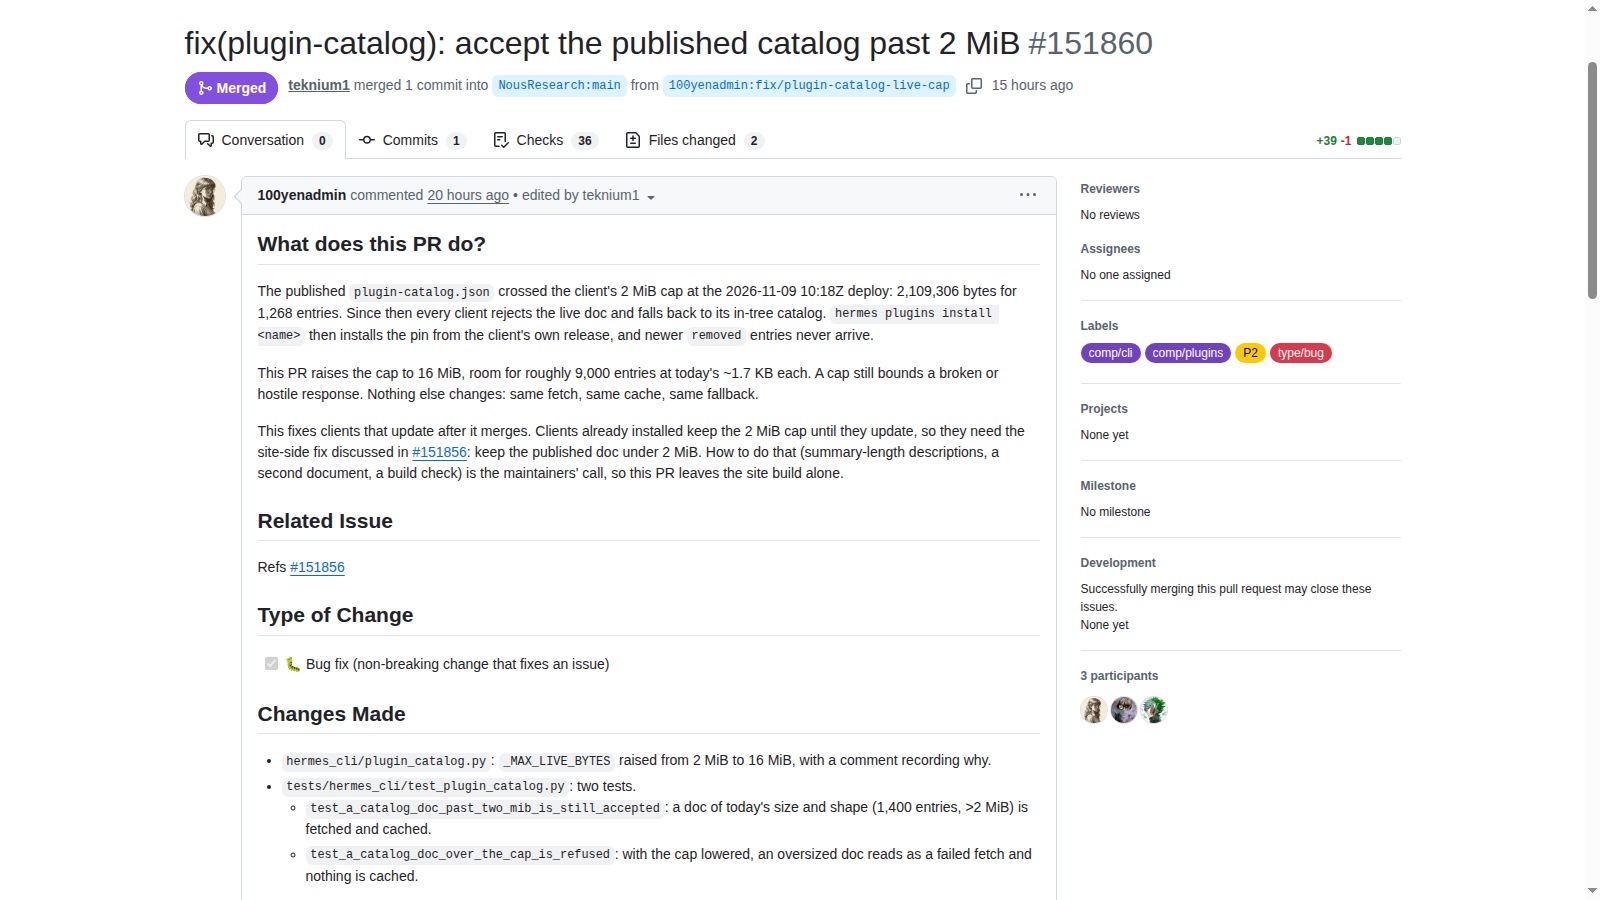
Il problema del catalogo Hermes riguarda la freschezza delle dipendenze, non la capacità del modello: un elenco live rifiutato poteva lasciare l’installazione su pin inclusi nella release. La patch 0.23.1 amplia il tetto, mentre Ollama interviene su un altro confine silenzioso, quello degli input troppo lunghi.
Limiti da conoscere
Limite: Analisi di release, PR e diff ufficiali, non un aggiornamento della nostra installazione. Le versioni precedenti conservano il vecchio limite finché non vengono aggiornate; la correzione non certifica sicurezza o qualità dei plugin.
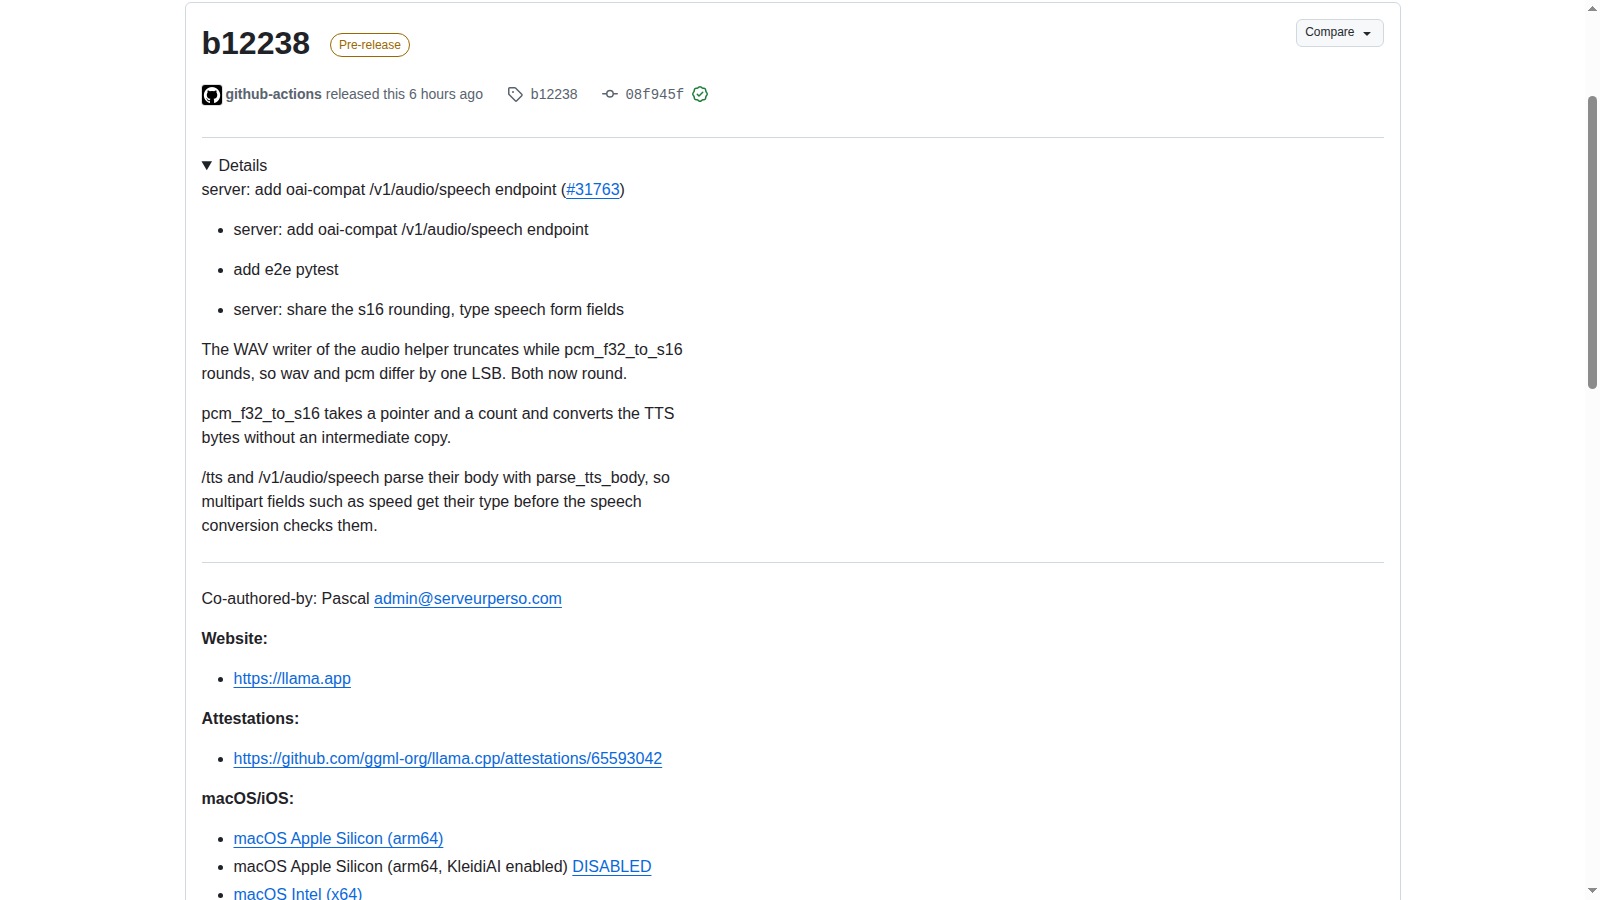
L’endpoint speech aggiunge un’uscita audio, distinta dallo streaming audio in ingresso per Gemma 4. La compatibilità è circoscritta a formati, voci e velocità documentati: scegliere il modello e adattare il client resta parte dell’integrazione.
Limiti da conoscere
Limite: b12238 è marcata prerelease nell’API GitHub. Nessun audio prodotto e nessuna valutazione di qualità o pronuncia italiana. MP3, SSE e variazioni di velocità non sono supportati da questo contratto documentato.
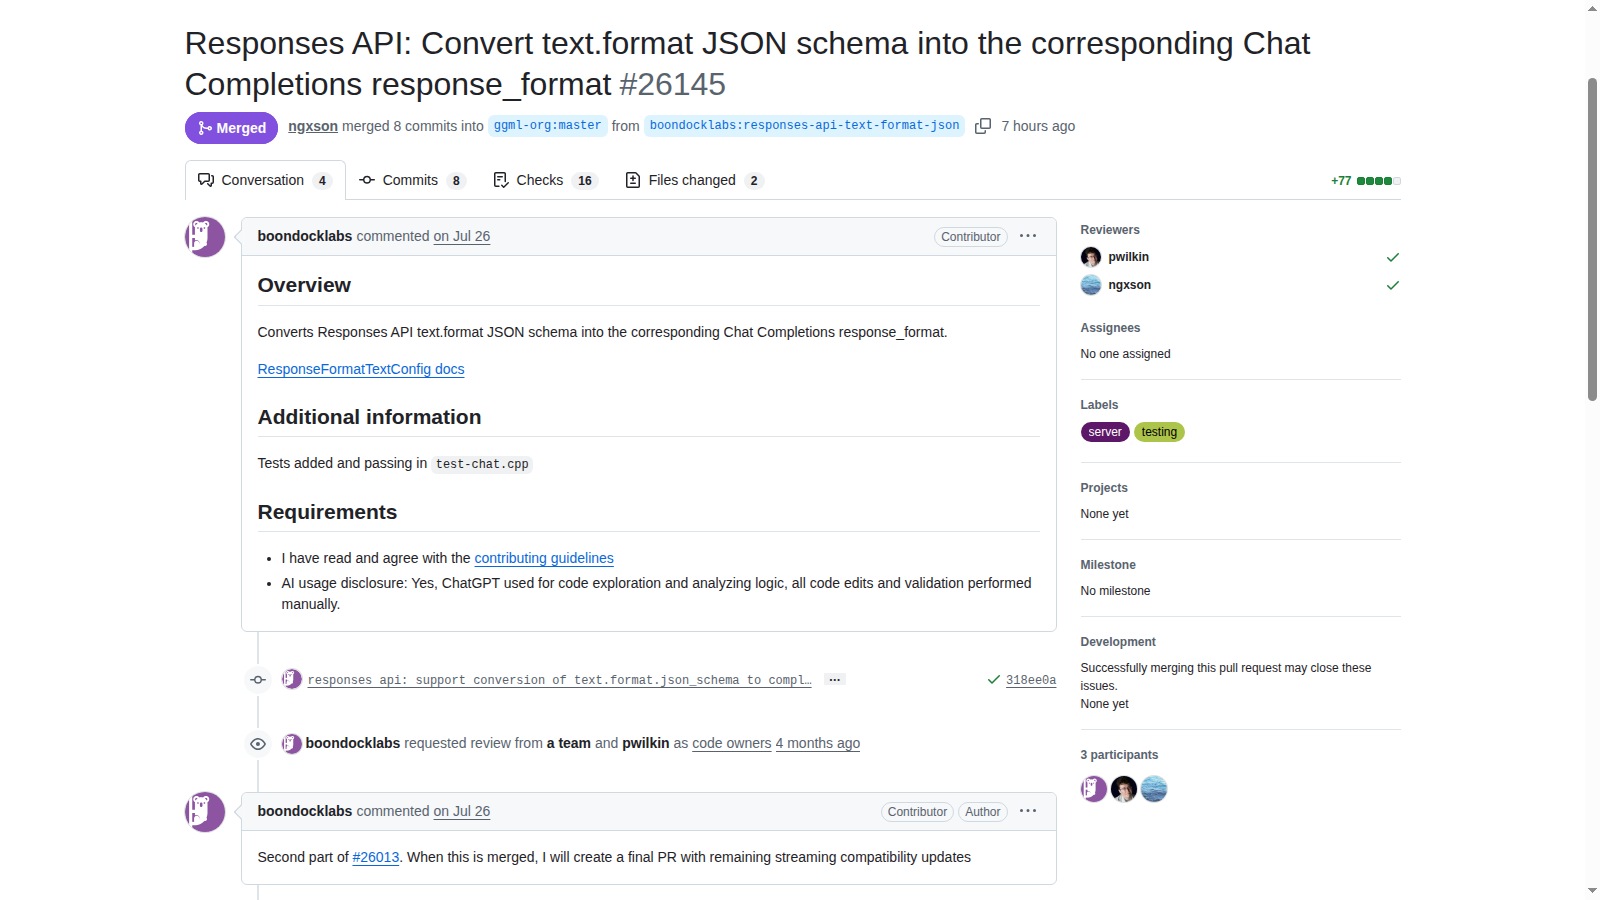
I fix dello schema operano su livelli diversi: il 9 novembre riguardava la lettura del formato al livello principale; qui cambia la traduzione da Responses a Chat Completions. Per chi migra un client è necessario seguire il vincolo lungo l’intero percorso, non sommare i fix in una promessa generica.
Limiti da conoscere
Limite: Build GitHub marcata prerelease. I test dichiarati nel repository non sono una nostra esecuzione e non dimostrano equivalenza completa delle API, supporto di ogni schema o correttezza semantica delle risposte.
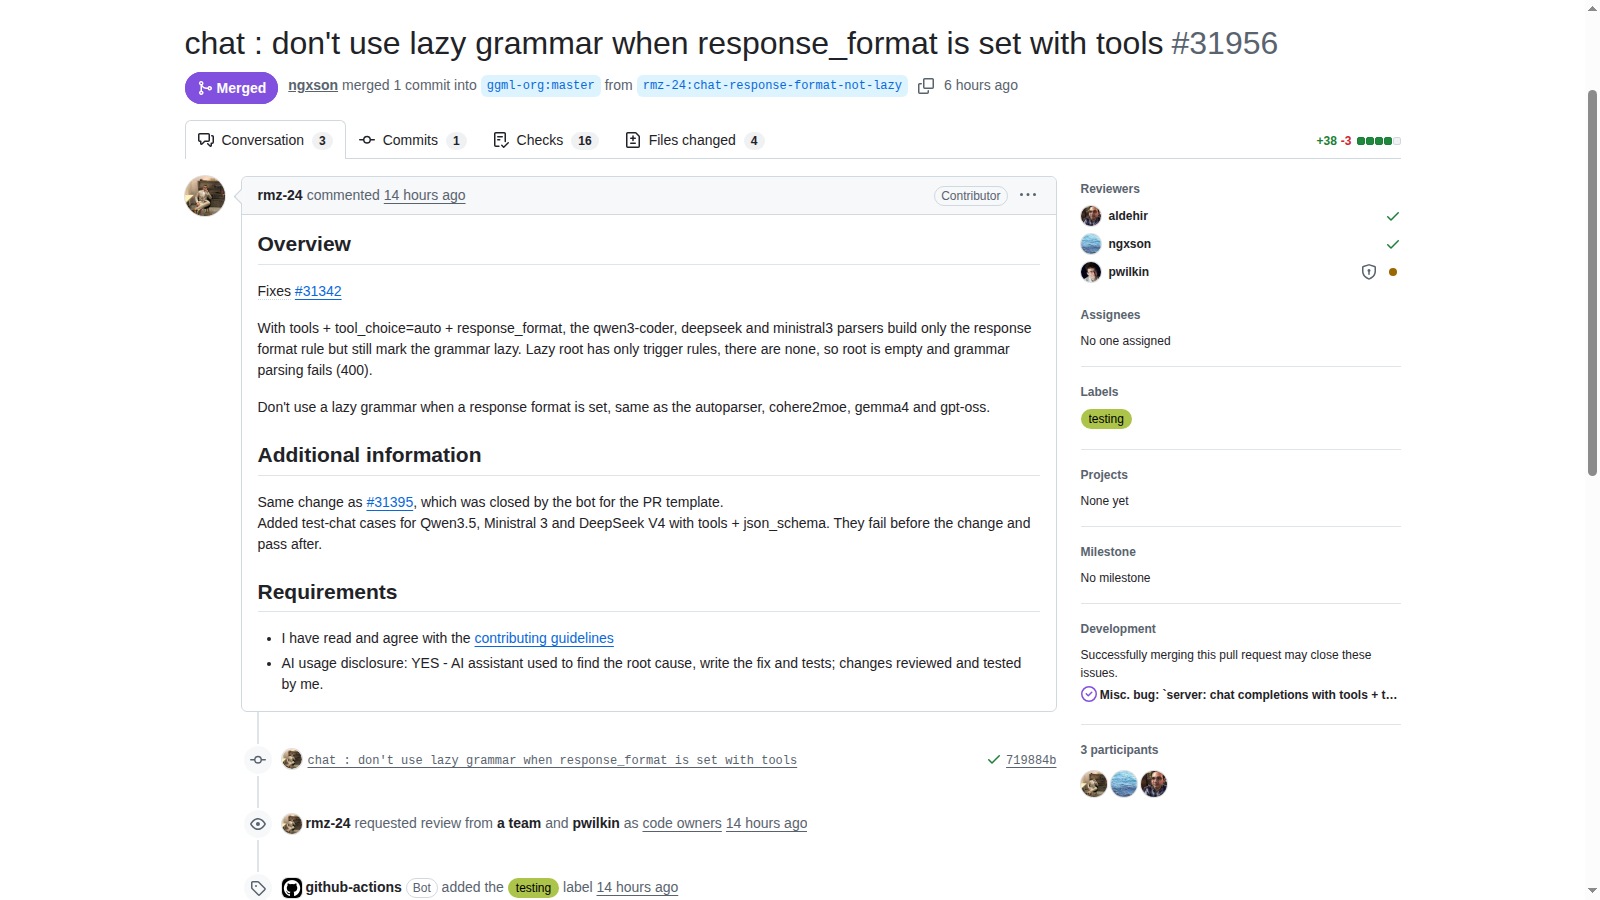
Una correzione del parser non equivale a un nuovo workflow agentico. Il caso tools più response_format mostra perché la lettura delle revisioni conta quanto il titolo della PR: eliminare un errore 400 non prova che il modello chiami gli strumenti mentre rispetta lo schema.
Limiti da conoscere
Limite: Verificato il merge della PR, non una release stabile né un nostro test runtime. Il fix non abilita le tool call nella configurazione descritta e non estende una garanzia a ogni parser o modello.
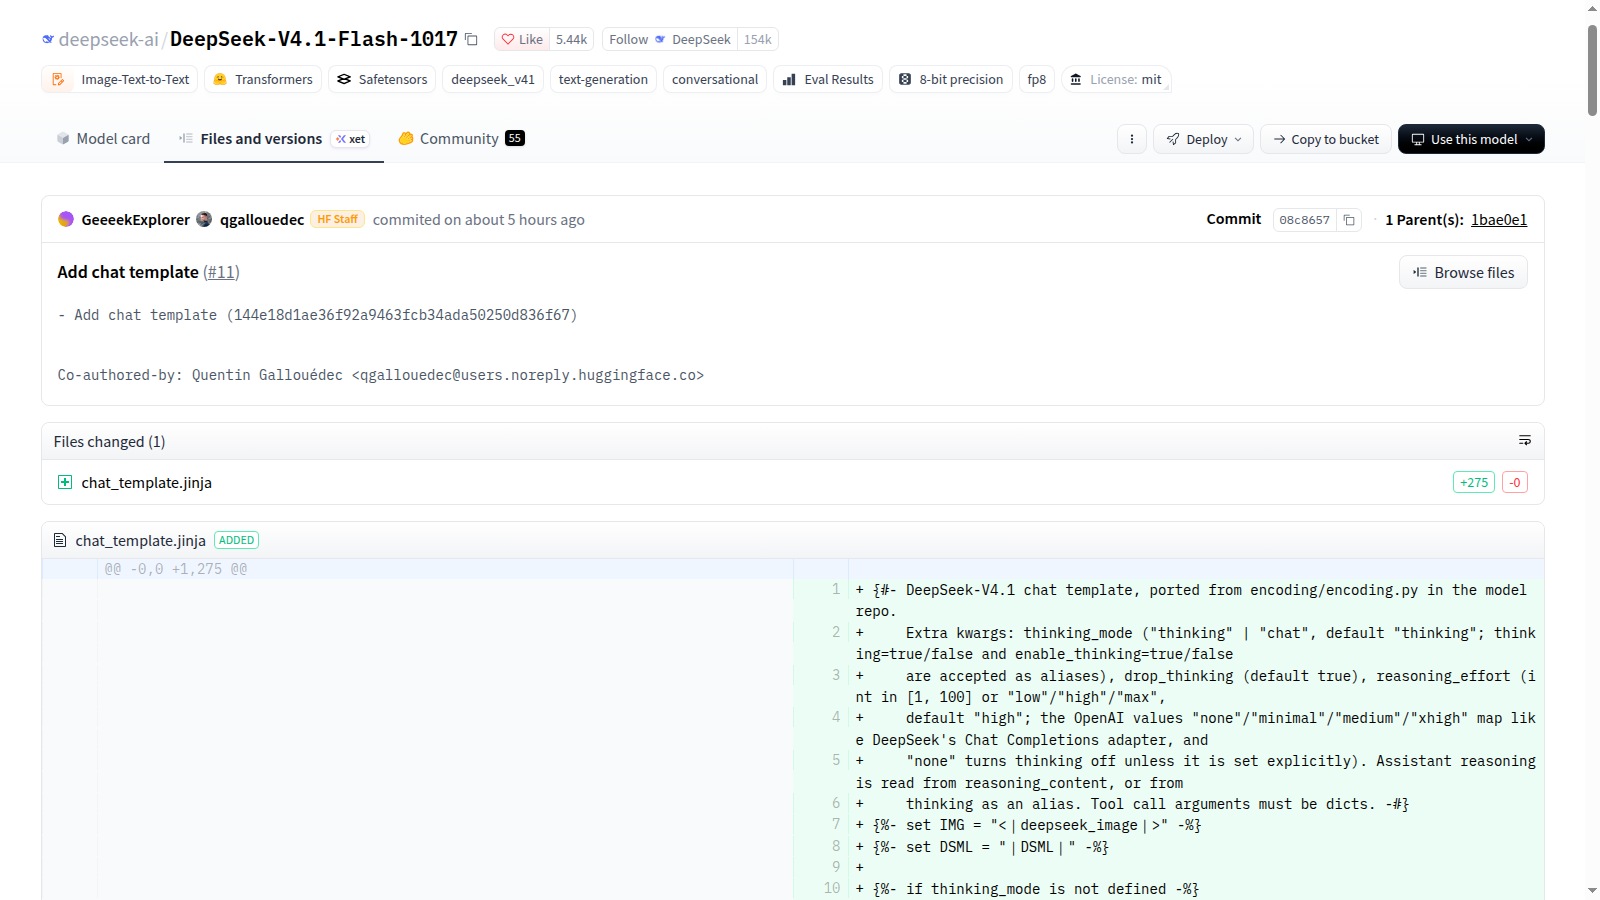
Il template DeepSeek è un aggiornamento dell’integrazione, non una seconda uscita dei pesi. Insieme ai fix dei parser llama.cpp ricorda che la qualità di un flusso locale dipende anche dalla rappresentazione dei messaggi e degli strumenti, non solo dal checkpoint scelto.
Limiti da conoscere
Limite: Confronto dei file e lettura del template, non inferenza. Nessuna misura di qualità, velocità o compatibilità con ogni runtime. Il nome del repository resta quello del lancio del 17 ottobre; la novità è il commit del 10 novembre.
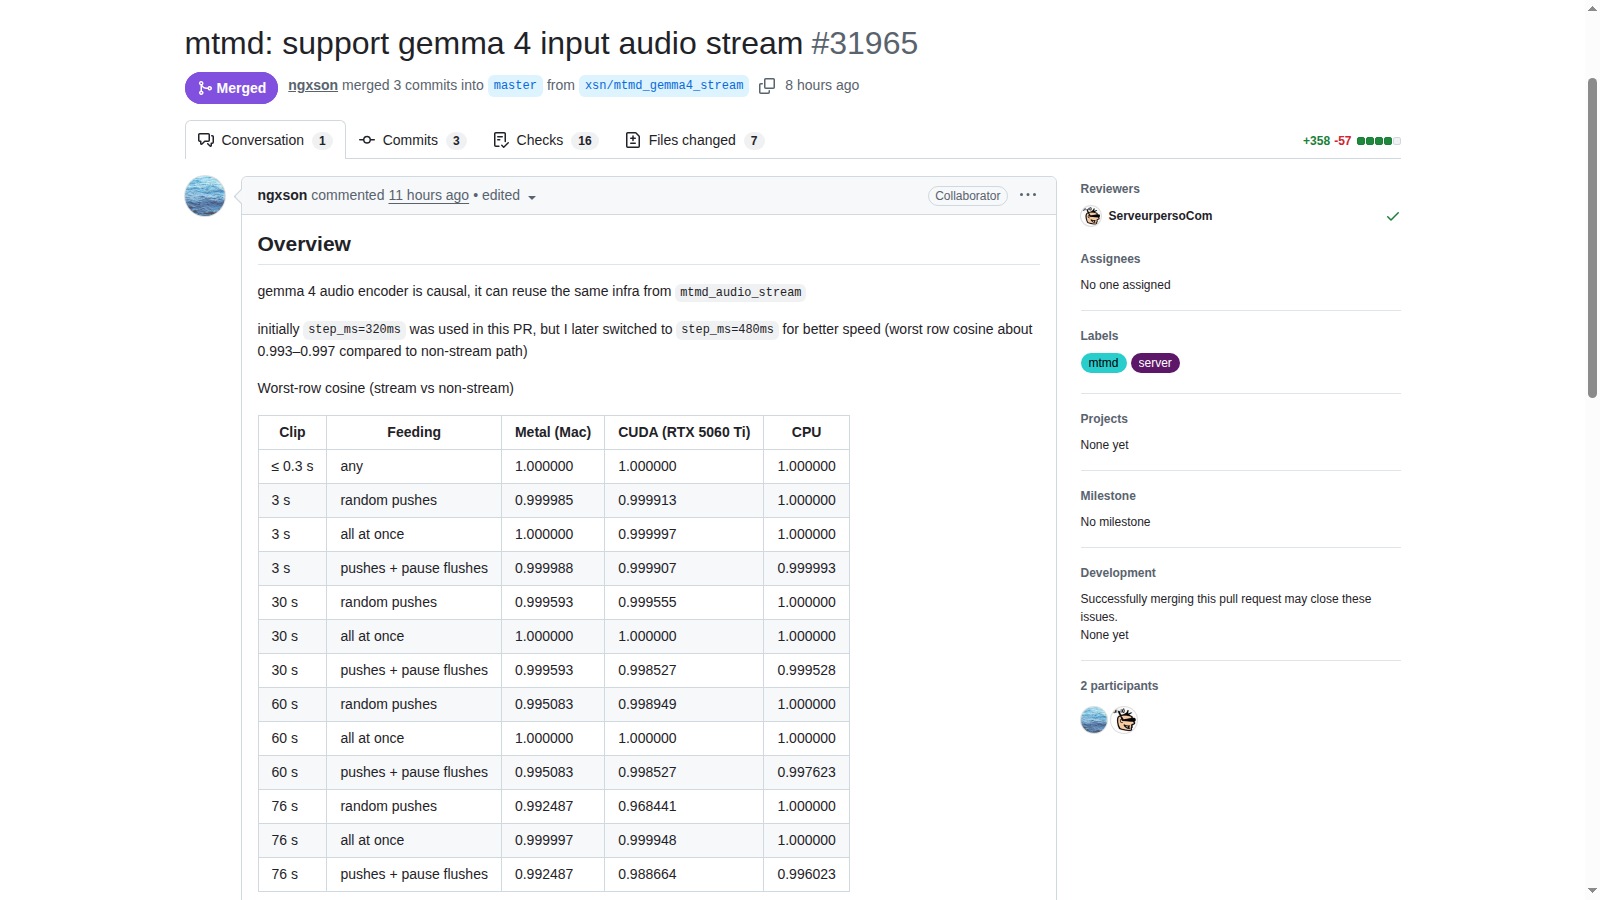
Gemma 4 riceve audio in ingresso mentre la build speech produce audio in uscita: sono due direzioni e due contratti diversi. I 480 ms del passo di elaborazione non vanno trasformati in un tempo di risposta promesso all’utente.
Limiti da conoscere
Limite: Build marcata prerelease, nessun audio elaborato qui. Le comparazioni numeriche della PR sono dell’autore e non misurano da sole comprensione, qualità della trascrizione o latenza dell’applicazione.
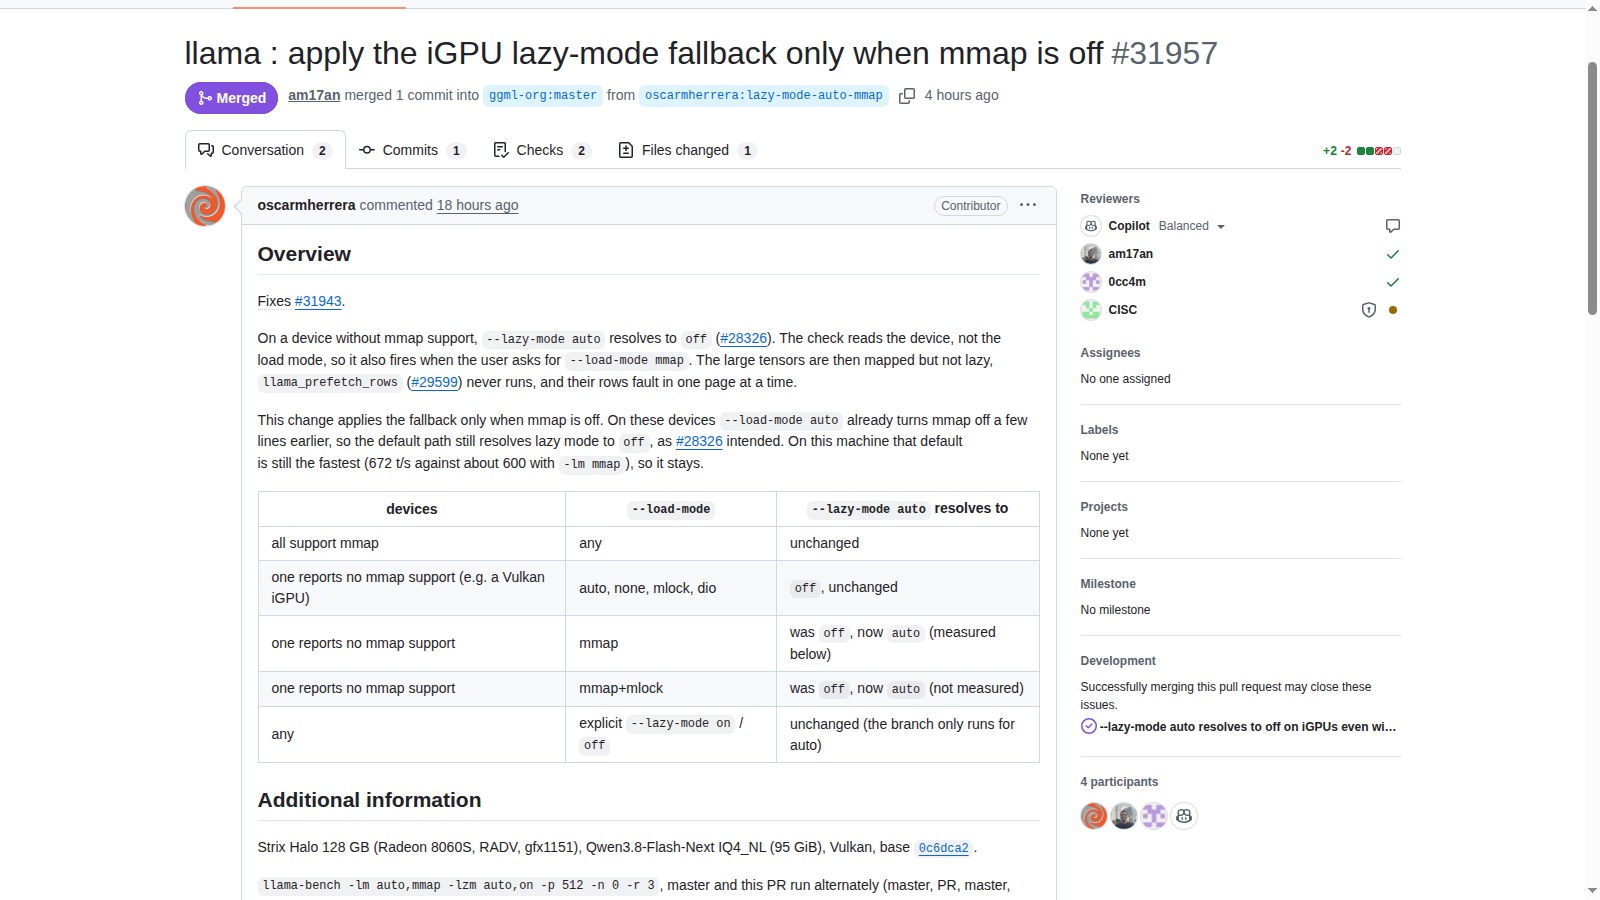
I cambiamenti hardware di llama.cpp non si sommano in un'accelerazione universale: iGPU Vulkan, Arc A-series e toolchain SYCL hanno prerequisiti distinti. Per decidere un aggiornamento servono una matrice di compatibilità e misure separate di prompt e generazione.
Limiti da conoscere
Limite: Il percorso iGPU predefinito auto resta invariato. Il caso Arc richiede attenzione ai vecchi runtime Linux. Nel confronto B570 dell'autore migliora il prompt processing, non la generazione. b12245 restituisce 404 nell'API verificata; b12243 e b12244 sono prerelease.
La guida educativa OpenAI sposta la domanda dall'accesso allo strumento alla valutazione: formazione dei docenti, regole e obiettivi precedono le metriche. È un contrappunto ai nuovi modelli della settimana, non una prova comparativa della loro efficacia didattica.
Limiti da conoscere
Limite: Il report del fornitore riassume esperienze contestuali, survey e attività di monitoraggio. Risparmio di tempo dichiarato e uso degli strumenti non sono misure equivalenti a conoscenza, autonomia e ritenzione. La generalizzazione ai corsi italiani richiede una valutazione dedicata.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.