
IL PUNTO SULL’AI
7 novembre 2026
llama.cpp integra Mage-VL-Cowork e calibra la cache MoE; Obsessive-1.7B arriva in GGUF, ma trova solo 24 risposte su 120 nel test live.
In questa edizione 6 notizie
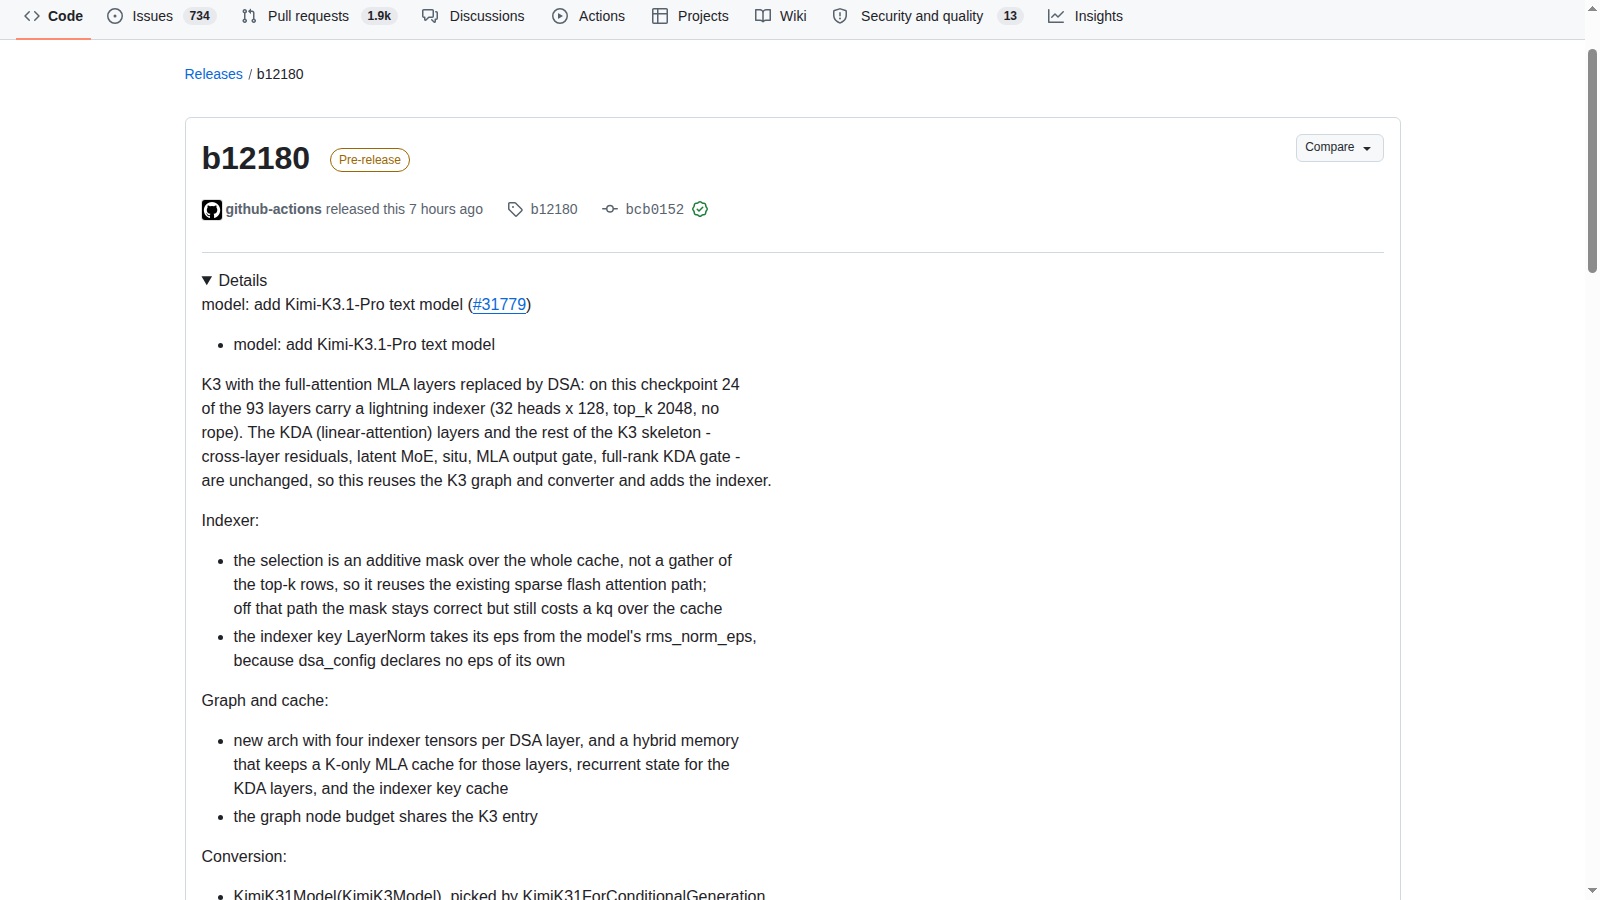
La build b12180 di llama.cpp introduce conversione e runtime per Kimi K3.1 Pro nella modalità testuale. La release è marcata prerelease; vision tower e mm_projector sono esclusi. La pubblicazione è del 7 novembre alle 00:18 italiane: è un delta del runtime, non un nuovo lancio dei pesi. llama.cpp: prerelease b12180 e confine del supporto.
Limiti da conoscere
Limite: Build marcata prerelease e supporto solo testuale. Non sono state misurate qui memoria, latenza o qualità del modello completo: il supporto del loader non dimostra che l’esecuzione sia sostenibile su un normale PC.
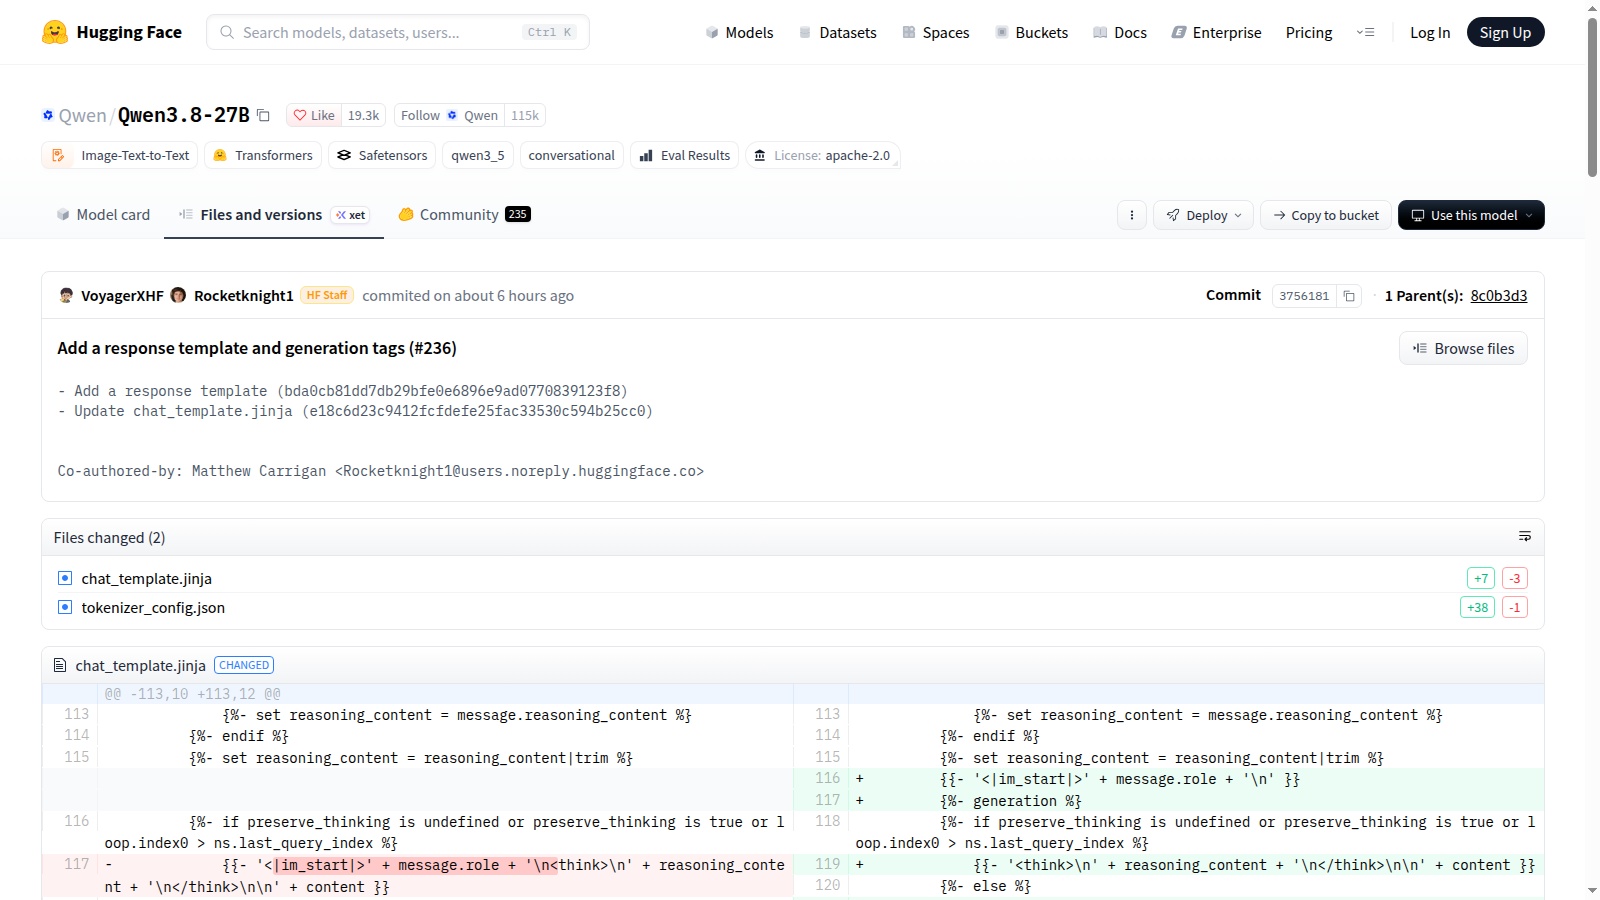
Il commit del 7 novembre aggiunge un response template e tag di generazione a Qwen3.8-27B. Nel confronto con la revisione precedente cambiano chat_template.jinja e tokenizer_config.json; i riferimenti LFS e le dimensioni dei 18 shard dei pesi restano uguali. È un delta di integrazione, non evidenza di nuovi pesi addestrati. Qwen: commit del response template e dei tag di generazione.
Limiti da conoscere
Limite: Confrontati file testuali e metadati Hub di due revisioni fissate. Nessun peso scaricato, rendering applicativo o test di inferenza eseguito; non sono dimostrati miglioramenti di qualità, velocità o compatibilità universale.
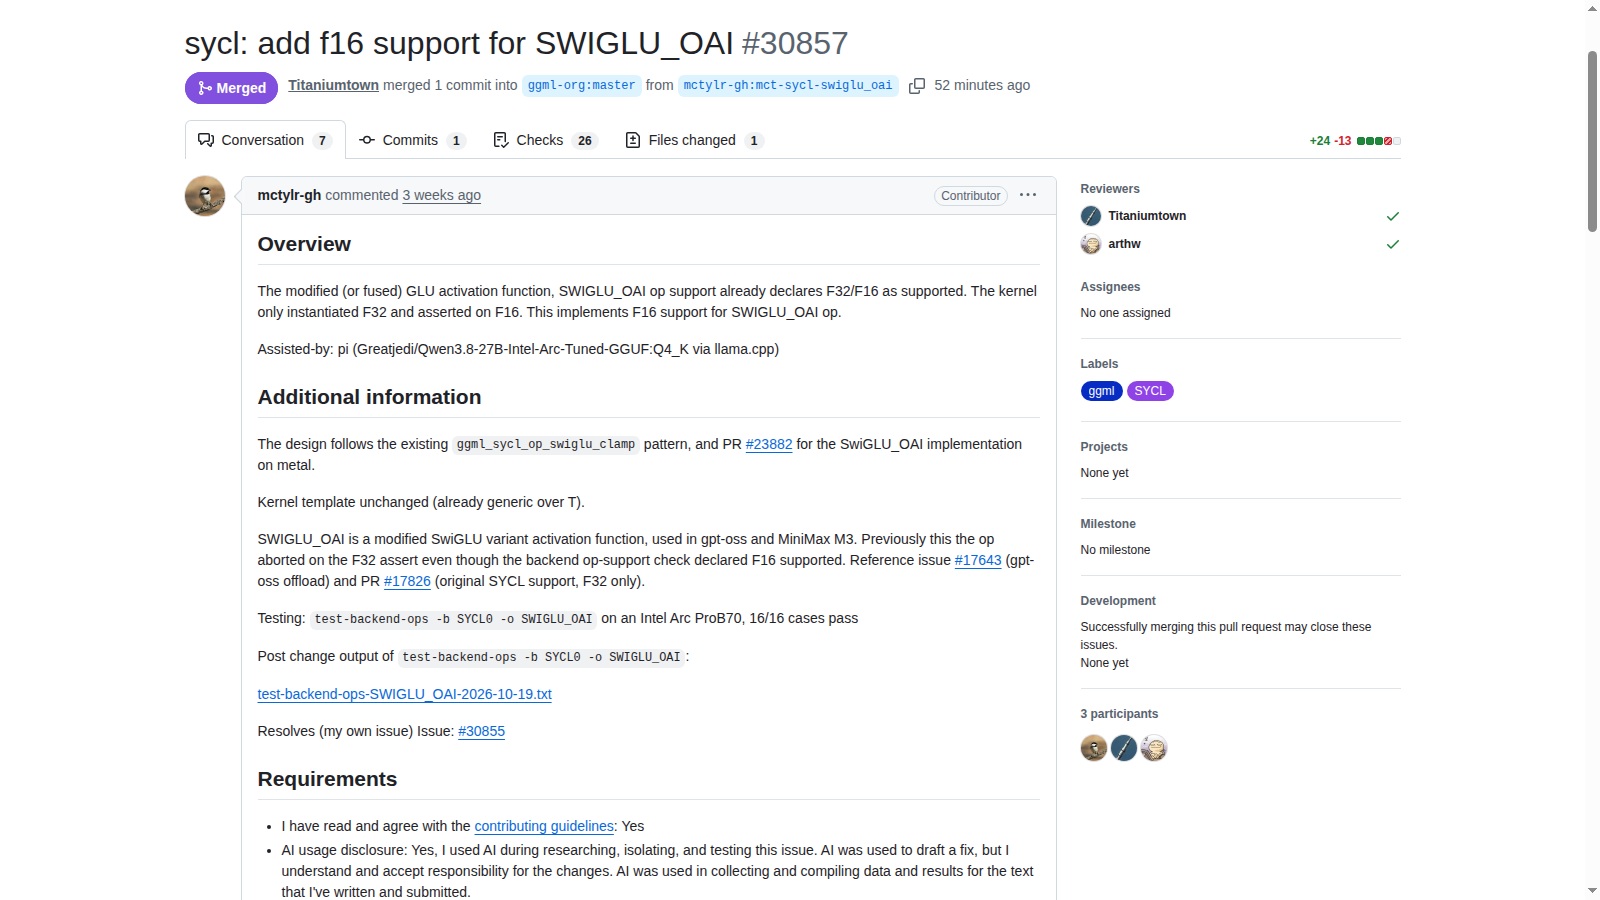
Quattro modifiche integrate il 7 novembre intervengono su operazioni GPU e richieste con prefisso condiviso: SYCL esegue SWIGLU_OAI anche in F16, Metal corregge GROUP_NORM, WebGPU aggiunge lo stesso operatore e il server visita gli slot padre prima dei figli. Il tag b12190 identifica il commit SYCL; alle 15:54 italiane la sua release REST non risultava disponibile, a differenza delle prerelease b12187-b12189. llama.cpp: supporto F16 per SWIGLU_OAI su SYCL.
Limiti da conoscere
Limite: Verifica documentale di merge, tag, diff e release API, senza compilazione o inferenza propria. I test citati sono dichiarazioni dei contributori; nessun guadagno di velocità, supporto completo a un modello o disponibilità di binari b12190 è dimostrato.
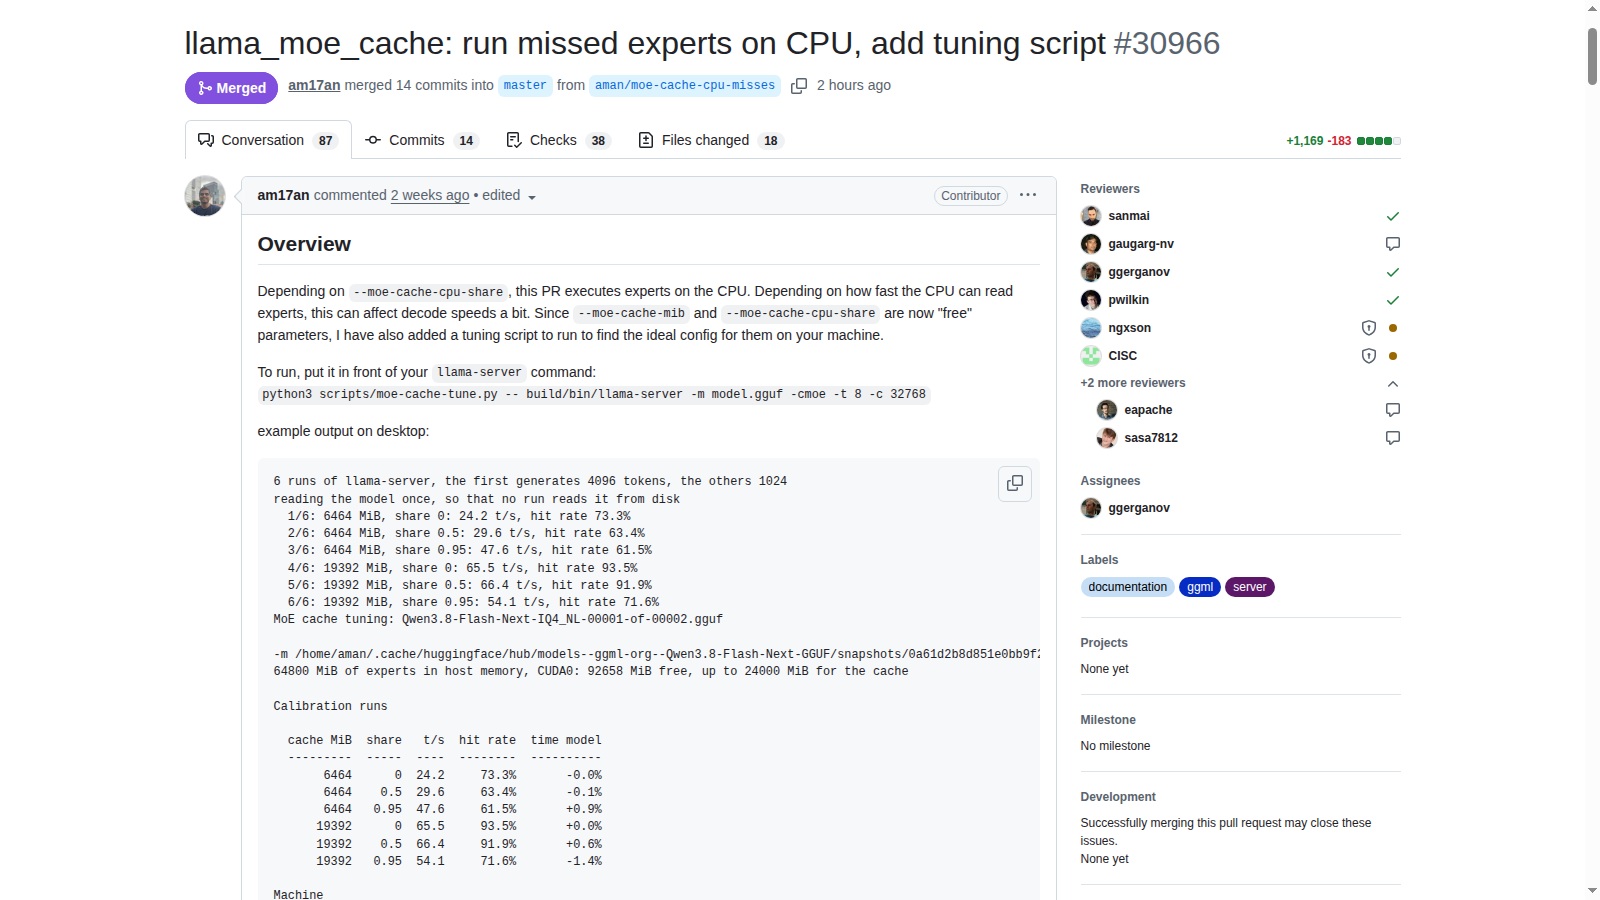
Il merge del 7 novembre aggiunge --moe-cache-cpu-share: a cache piena, una quota degli esperti MoE mancanti viene calcolata sulla CPU anziché trasferita alla GPU. Il nuovo script moe-cache-tune.py calibra due dimensioni di cache con tre quote CPU e propone una configurazione per quella macchina. È un nuovo controllo del runtime, non un nuovo modello né una promessa di accelerazione universale. llama.cpp: cache miss MoE sulla CPU e script di tuning.
Limiti da conoscere
Limite: Analisi di pull request, diff e file fissati al commit e95426f16982054c379ca7bdc8186996dd22f0fe; nessuna build o inferenza eseguita qui. Le misure nell'esempio sono dell'autore e le altre combinazioni sono stime. Un tag non prova disponibilità di binari o stabilità.
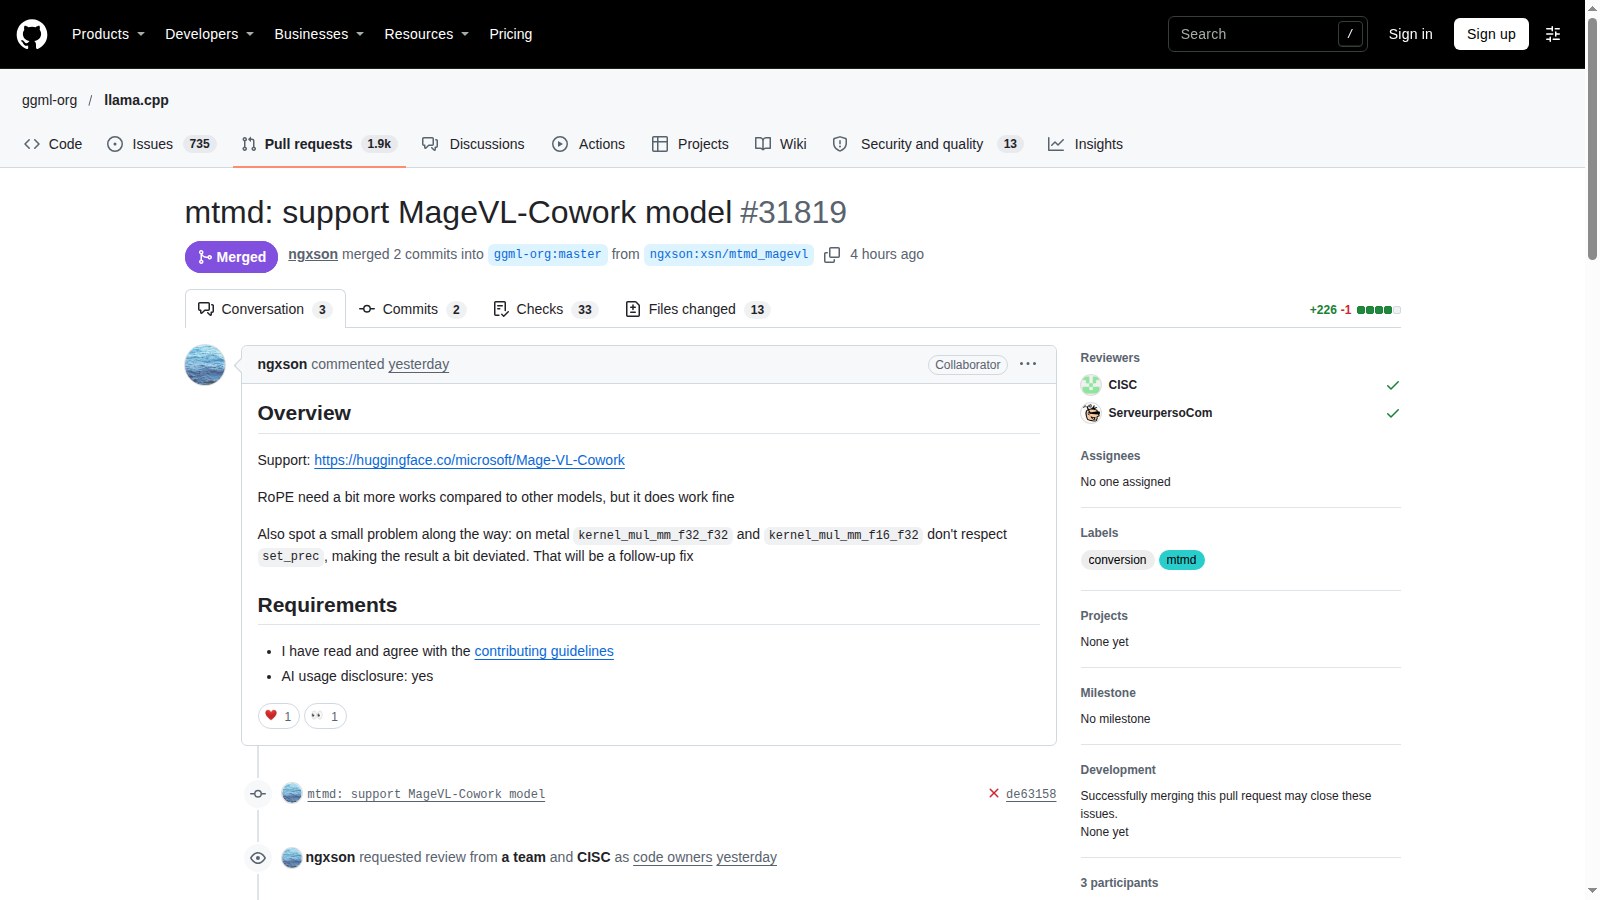
La prerelease b12192 del 7 novembre integra Mage-VL-Cowork nel percorso multimodale di llama.cpp. La pull request modifica 13 file e aggiunge conversione, caricamento e componenti del grafo per questa architettura. È un delta di compatibilità del runtime: non annuncia nuovi pesi né dimostra prestazioni migliori.
Limiti da conoscere
Limite: Analisi documentale della prerelease e del diff al merge 9f0e5098a5d5d8adb8dd5c59036ae2a38ab07db9. Nessuna build, inferenza o prova del backend eseguita. La pull request segnala una deviazione di precisione su Metal da correggere separatamente.
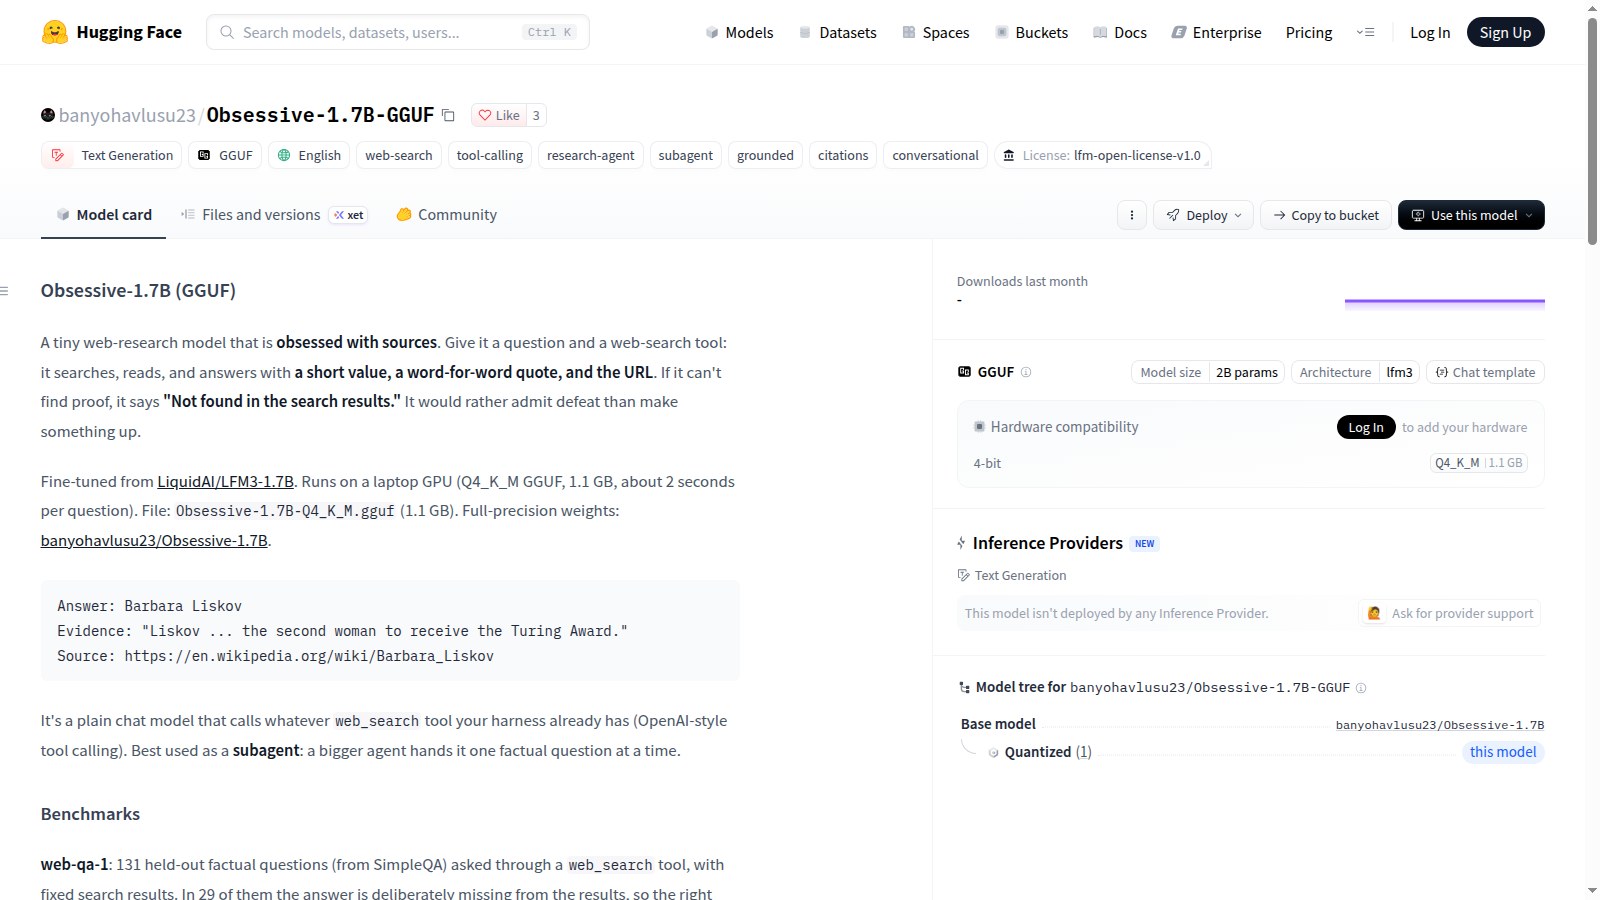
Il 7 novembre compare il GGUF Q4_K_M di Obsessive-1.7B, un modello comunitario per domande fattuali con ricerca web e citazioni. Il file pesa circa 1,1 GB. La scheda dichiara citazioni copiate correttamente nel test live, ma soltanto 24 risposte corrette su 120 e tre valori non supportati su 52: una fonte reale non garantisce una risposta pertinente.
Limiti da conoscere
Limite: Risultati dichiarati dall'autore, non replicati. Ricerca fissa e live hanno compiti e denominatori diversi. Inglese soltanto, una domanda per conversazione; modello e ricerca richiedono un harness. Nessun download dei pesi o test di inferenza svolto qui.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.