
L’ANALISI
Dharma Field Extractor: documenti in JSON e limiti
Dharma Field Extractor trasforma immagini di documenti in campi JSON. Il benchmark usa 546 documenti: risultati del produttore, non test nostri.
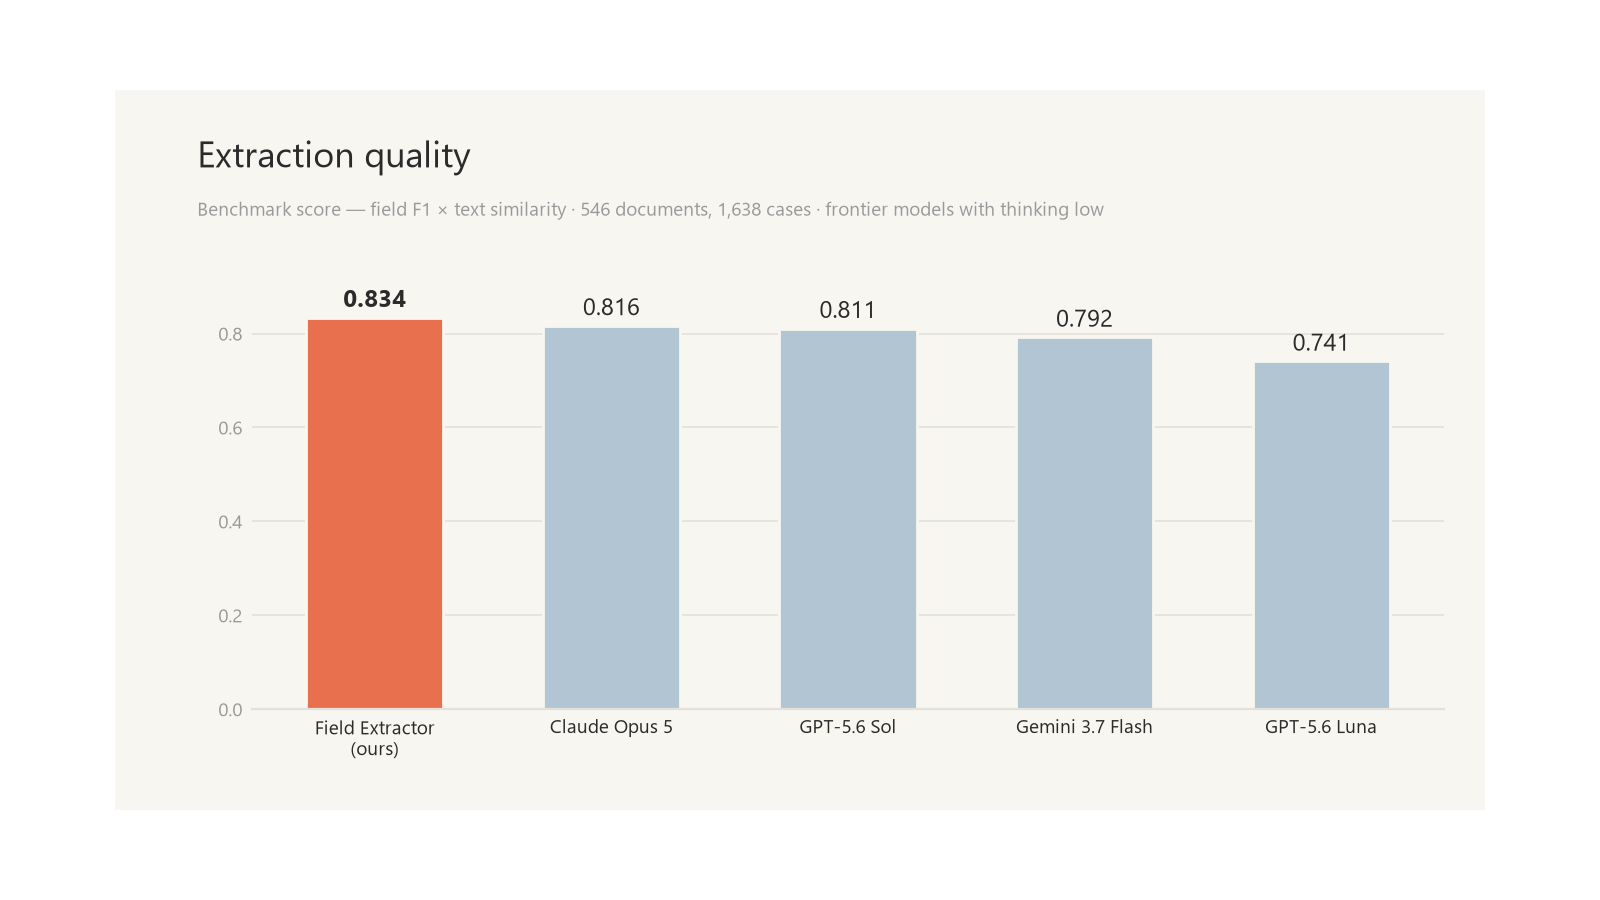
In breve: Dharma Field Extractor è un modello specializzato per trasformare immagini di documenti in campi JSON, anche secondo uno schema richiesto. La novità è l’estrazione strutturata, non soltanto la trascrizione OCR. L’annuncio mostra un benchmark e rimanda a un portale: non dimostra che il nuovo checkpoint sia già scaricabile o che il servizio sia stato provato da noi. Dharma-AI: Field Extractor, metodo e benchmark ufficiali.
Verifica documentale dell’articolo pubblicato da Dharma-AI su Hugging Face il 4 novembre 2026 e inventario dei modelli pubblici dell’organizzazione. Non abbiamo caricato documenti sul portale, ottenuto accesso al modello Field Extractor, collaudato l’output o verificato i costi. Le procedure che seguono sono un protocollo proposto; i dati del benchmark appartengono al produttore.
In cosa differisce dall’OCR tradizionale?
L’OCR restituisce testo; un’estrazione strutturata deve anche attribuire ogni valore alla chiave corretta. Il nuovo annuncio descrive due modalità: ricerca libera dei campi e compilazione di uno schema. Per chi integra documenti in un gestionale, la domanda concreta non è soltanto se una cifra sia leggibile, ma se sia collegata al campo giusto. Un JSON sintatticamente valido può comunque contenere un valore errato. La proposta pratica è quindi separare il controllo della struttura dalla verifica dei dati, evitando di considerarli lo stesso criterio di qualità. Dharma-AI: Field Extractor, metodo e benchmark ufficiali.
Che cosa misura davvero il benchmark?
Il produttore descrive 546 documenti e tre scenari, per 1.638 casi: estrazione libera, schema parziale e schema con campi deliberatamente inesistenti. La metrica combina corrispondenza dei campi, similarità dei valori e validità del JSON. Non è una percentuale universale di documenti corretti. Per usare il risultato nella propria decisione, servono esempi rappresentativi del proprio flusso e criteri espliciti sugli errori accettabili. Non abbiamo riprodotto questo confronto e non trasformiamo il risultato pubblicato in una graduatoria indipendente dei modelli. Dharma-AI: Field Extractor, metodo e benchmark ufficiali.
Come verificare i campi che non esistono?
Un protocollo utile contiene anche richieste impossibili: aggiungi allo schema un campo assente dal documento e definisci prima come deve essere rappresentata la mancanza. Controlla poi tipi, chiavi inattese e coerenza tra righe e colonne. Conserva una risposta attesa verificata da una persona e confronta ogni output con quella, non soltanto con la sua plausibilità. È importante registrare anche gli errori e i rifiuti: un esempio riuscito non descrive la distribuzione dei casi. Questi sono controlli proposti, non test già eseguiti sul nuovo modello. Dharma-AI: Field Extractor, metodo e benchmark ufficiali.
Perché il costo GPU non è il prezzo del servizio?
L’articolo distingue il calcolo del costo di esecuzione dalla tariffa commerciale. Per valutare un flusso proprio, separa inferenza, preparazione dei documenti, verifica umana, ritentativi e manutenzione. Confronta soluzioni soltanto dopo aver fissato volume, latenza e qualità richiesta. Non presentiamo il costo riportato nel benchmark come un preventivo utilizzabile da un’azienda. In particolare, senza un’offerta e un percorso di accesso verificati, non è possibile ricavare il prezzo pagabile del nuovo servizio da una stima di utilizzo della GPU. Dharma-AI: Field Extractor, metodo e benchmark ufficiali.
Si possono già scaricare i pesi e usare documenti reali?
Nella verifica dell’inventario pubblico dell’organizzazione compare Dharma-OCR-LITE, non un checkpoint distinto denominato Field Extractor. Il collegamento al modello OCR non prova la disponibilità dei pesi dell’estrattore. Prima di inviare documenti a un portale, verifica il servizio effettivo, le condizioni e la gestione dei dati. Per il primo collaudo proposto usa soltanto documenti sintetici e nessuna informazione personale. L’esito da ottenere è un campione misurato sul proprio schema; non basta che l’interfaccia accetti un caricamento o mostri un esempio del produttore. Hugging Face: inventario pubblico dei modelli Dharma-AI verificato il 4 novembre.
Condizioni e limitazioni
Non abbiamo provato il portale o riprodotto il benchmark. L’annuncio non collega un checkpoint scaricabile di Field Extractor: il modello pubblico Dharma-OCR-LITE citato è un prodotto distinto. Non risultano verificati un’API pubblica, prezzi, trattamento dei dati o disponibilità self-hosted del nuovo estrattore.
Checklist pratica
- Definire campi richiesti, tipi e rappresentazione dei valori mancanti.
- Preparare documenti sintetici con risposta attesa controllata da una persona.
- Includere tabelle, campi assenti, valori ambigui e documenti poco leggibili.
- Misurare separatamente validità del JSON e correttezza dei campi.
- Verificare accesso, disponibilità dei pesi e condizioni sui dati prima di usare il servizio.
- Confrontare costi soltanto a parità di volume, latenza e qualità, includendo i ritentativi.