
L’ANALISI
llama.cpp b12099: LIGHTNING_INDEXER arriva su Hexagon
llama.cpp b12099 aggiunge LIGHTNING_INDEXER su Hexagon per Q4_0, Q8_0, F16 e F32. È una prerelease; nessun benchmark su dispositivo eseguito.
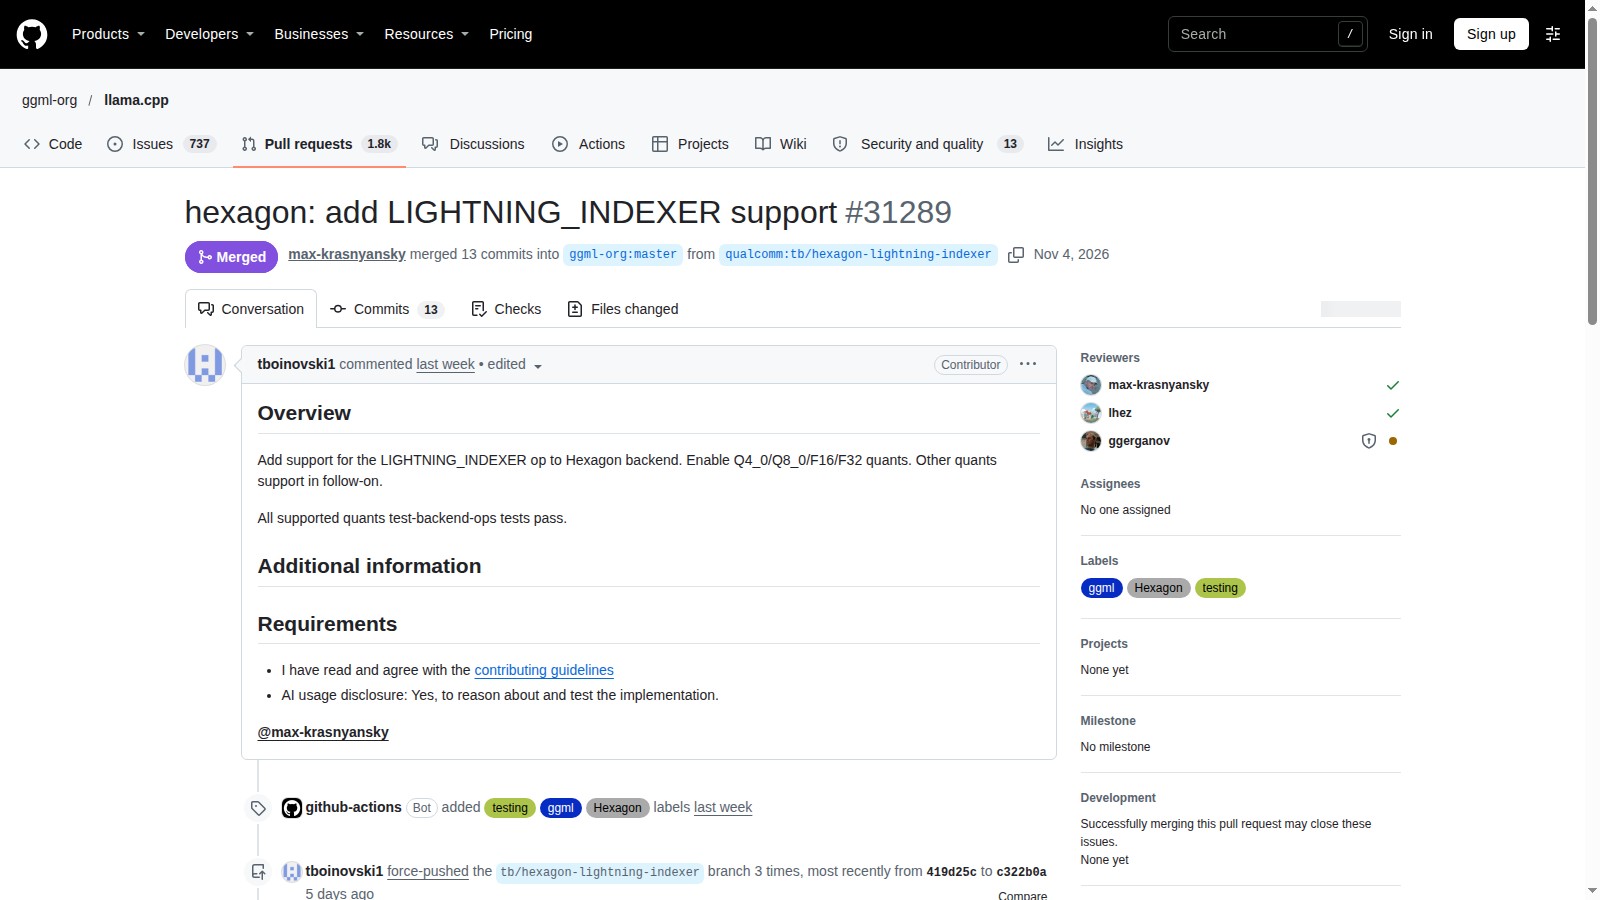
In breve: llama.cpp b12099 aggiunge LIGHTNING_INDEXER a Hexagon con Q4_0, Q8_0, F16 e F32. Cambia la copertura delle operazioni del backend NPU, non certifica che un intero modello funzioni o sia più veloce sul proprio Snapdragon. La build è pubblicata come prerelease. llama.cpp: release b12099.
Metodo: letti il REST ufficiale b12099, lo stato merged della PR 31289 e la guida Snapdragon fissata al commit di merge bee23322f1baa3d2dd16b8339bed6aff4a8eb663. Nessuna compilazione, installazione, esecuzione NPU o misura prestazionale in questo ciclo. Verifica delle fonti: 4 novembre 2026.
Qual è il cambiamento della build b12099?
Le note della release collegano la PR 31289 per LIGHTNING_INDEXER. Lo snapshot REST riporta published_at 2026-11-04T05:47:21Z e prerelease=true. L’apertura della PR il 28 ottobre non è la data di disponibilità della build; il merge è del 4 novembre. Il delta è quindi l’inclusione di un’operazione nel backend Hexagon, non un nuovo modello o un rilascio stabile generale. llama.cpp: release b12099.
Quali tipi sono coperti e quali no?
La descrizione della PR elenca Q4_0, Q8_0, F16 e F32; altri tipi sono previsti in interventi successivi. L’autore dichiara che i test test-backend-ops dei tipi supportati passano. Questa è evidenza del progetto, non un nostro collaudo. Non estendiamo il risultato ad altre quantizzazioni e non ricaviamo un miglioramento percentuale da commit dedicati a pipeline o buffering. llama.cpp: PR 31289, LIGHTNING_INDEXER per Hexagon.
Hexagon è lo stesso percorso di OpenCL?
La guida distingue CPU, GPU Adreno con OpenCL e NPU Hexagon. Un aggiornamento a Hexagon non equivale quindi a una nuova capacità della GPU OpenCL già raccontata nel Radar. Per valutare il proprio sistema occorre identificare il backend effettivo, non fermarsi alla marca Snapdragon. La guida mostra toolchain e wrapper dedicati, con percorsi separati di compilazione ed esecuzione. llama.cpp: guida Snapdragon al commit integrato.
Come valutare il cambiamento senza promettere uno speedup?
Il primo controllo proposto è riprodurre i test dell’operatore sul dispositivo compatibile e sulla revisione fissata; solo dopo ha senso provare un modello che richieda quella operazione. Registrare tipi, log e fallback rende confrontabile l’esito. Un benchmark completo deve tenere fissi modello, quantizzazione, prompt, contesto e backend: qui il protocollo è suggerito, non eseguito, e non attribuiamo al nuovo operatore i numeri degli esempi storici della guida. llama.cpp: guida Snapdragon al commit integrato.
Condizioni e limitazioni
Il REST marca b12099 come prerelease. I test degli operatori sono dichiarati dall’autore della PR, non ripetuti qui. Il supporto di un’operazione non dimostra compatibilità completa di un modello, disponibilità su ogni Snapdragon o maggiore velocità; altre quantizzazioni sono rimandate a lavori successivi.
Checklist pratica
- Conservare tag b12099, commit di merge e indicazione prerelease; non descriverlo come stable.
- Verificare sistema operativo, architettura e supporto Hexagon del dispositivo nella guida ufficiale.
- Controllare che il proprio caso usi LIGHTNING_INDEXER e uno dei tipi Q4_0, Q8_0, F16 o F32.
- In un ambiente di prova seguire build.py e la toolchain Snapdragon documentata, senza aggiornare una macchina produttiva alla cieca.
- Riprodurre prima i test dell’operatore, annotando errori e fallback invece di considerarli successi parziali.
- Provare poi il modello completo con una baseline identica, separando prefill, generazione e correttezza.
- Tenere la build precedente per un ritorno controllato; nessun aggiornamento automatico è stato applicato dal Radar.