
L’ANALISI
llama.cpp e Drama 3: sintesi vocale e limiti GGUF
llama.cpp b12116 integra Drama 3 con 16 speaker e audio a 44,1 kHz. Servono modello e proiettore GGUF; il voice cloning non è supportato.
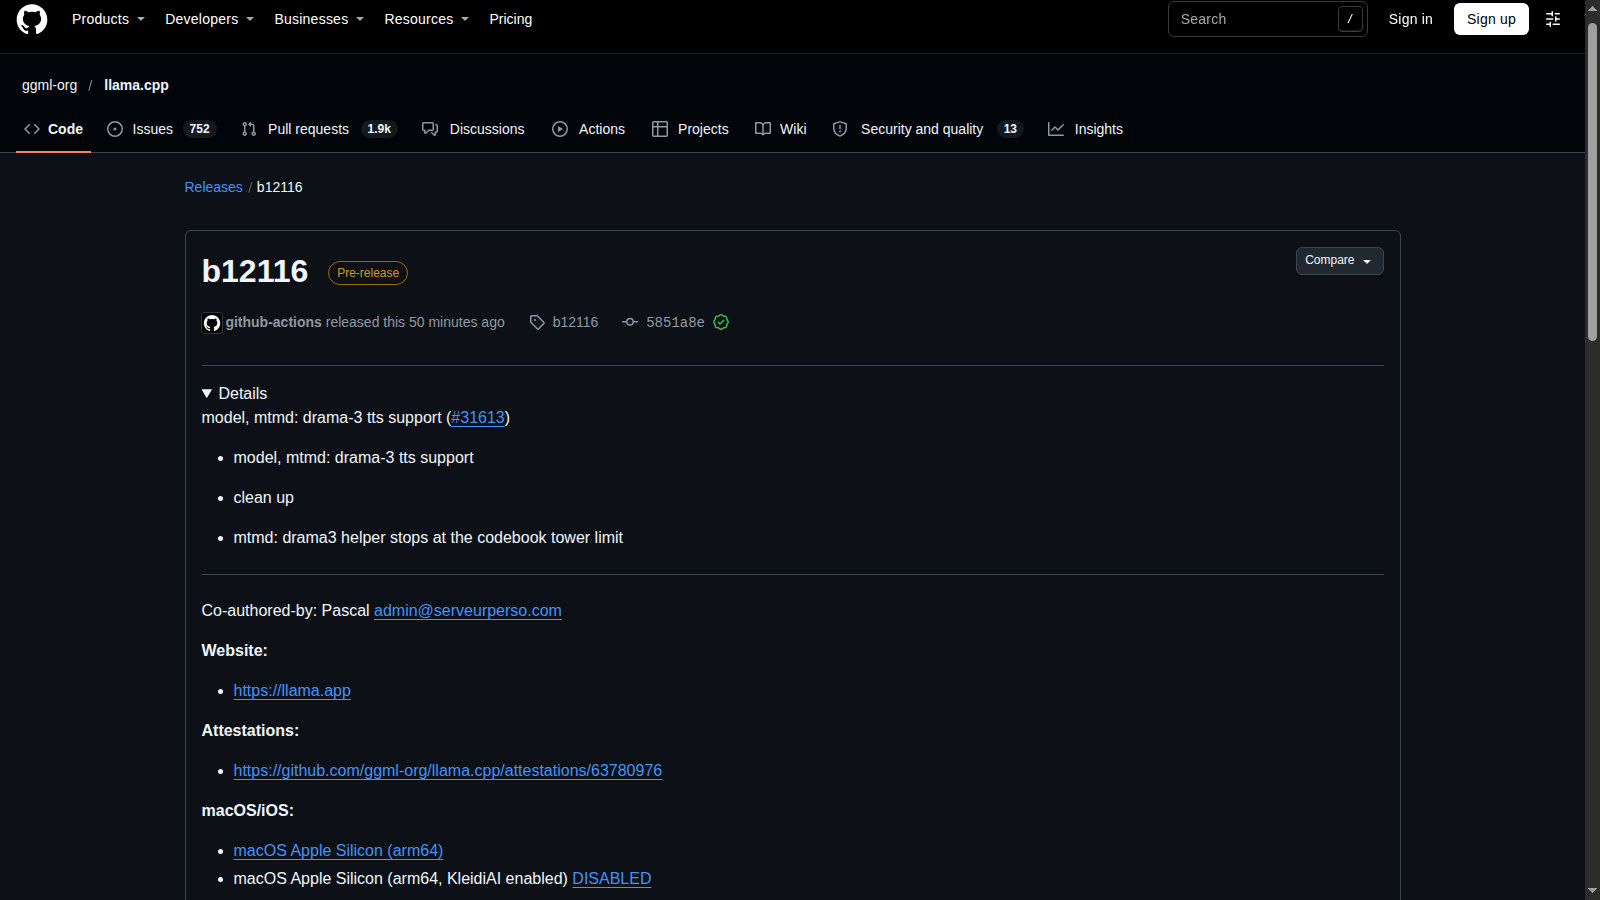
In breve: llama.cpp b12116 aggiunge una via GGUF per usare Drama 3 con llama-tts: il modello produce i token e un secondo file contiene la codebook tower e il decoder audio. La documentazione prevede tag per 16 speaker e uscita a 44,1 kHz. Non include ancora il voice cloning da file di riferimento. È un’analisi della release e delle istruzioni, non il risultato di una nostra prova vocale. llama.cpp b12116: release ufficiale e supporto Drama 3.
Metodo: lettura della release b12116, della pull request 31613 e del README TTS fissato allo stesso tag, con controllo della model card ufficiale. Nessuna compilazione, conversione, inferenza o valutazione d’ascolto eseguita. I comandi riportati dalla fonte sono una procedura da verificare nel proprio ambiente, non un’installazione già convalidata.
Che cosa cambia nella prerelease b12116?
La release del 4 novembre include il supporto Drama 3 nel modello e nel sottoprogetto mtmd. La pull request introduce anche il convertitore e istruzioni specifiche per llama-tts. La novità da valutare è quindi l’integrazione in un runtime diverso, non il lancio di Drama 3: il repository del modello esisteva già in ottobre. Il numero b12116 identifica una prerelease. Per chi ha fissato la stabile 0.9.0, il suo numero da solo non dimostra che questa integrazione sia inclusa. Conviene conservare il tag esatto accanto al risultato di ogni futura prova, così da non confrontare percorsi software differenti sotto lo stesso nome commerciale. llama.cpp b12116: release ufficiale e supporto Drama 3.
Perché servono due file GGUF?
Le istruzioni prevedono un GGUF principale e un mmproj separato. Per Drama 3, quest’ultimo contiene la codebook tower e la parte decoder di codec.pth. Il README propone la conversione del modello in Q8_0 e del proiettore in BF16; precisa inoltre che gli esperti FP8 del checkpoint vengono dequantizzati durante la conversione. Questi dettagli impediscono una scorciatoia frequente: scegliere un unico file dal nome plausibile e attribuire al modello ogni errore successivo. Il percorso da preparare comprende checkpoint coerente, conversione compatibile e coppia modello-proiettore. Non abbiamo misurato lo spazio temporaneo della conversione né RAM, VRAM, latenza o compatibilità dei backend. README TTS al tag b12116: parametri, limiti e conversione Drama 3.
Quali controlli vocali funzionano in questo percorso?
Il README documenta i tag speaker da 0 a 15 e spiega che un testo senza tag parte dallo speaker 0. La lingua dipende dal testo: l’opzione --tts-lang non è usata per questo modello. Il supporto a più personaggi non equivale al voice cloning: --tts-speaker-file risulta ancora non supportato nell’integrazione. Anche --top-k e --top-p non modificano il campionamento descritto. Per una futura verifica riproducibile occorre perciò registrare i parametri effettivamente applicati, non soltanto quelli accettati dalla riga di comando. Una prova minima può usare due brevi battute e due speaker, senza caricare campioni vocali di terzi. README TTS al tag b12116: parametri, limiti e conversione Drama 3.
Come impostare una prima prova controllata?
Il percorso pubblicato usa llama-tts con -m per il modello, -mm per il proiettore, -p per il testo e --output per il WAV. Prima di eseguirlo, fissare versione del runtime e revisione dei pesi, verificare le istruzioni di conversione e leggere la licenza indicata nella model card. Limitare il primo testo a due frasi consente di controllare generazione del file, alternanza dei personaggi e intelligibilità prima di estendere la prova. La codebook tower conserva la sequenza nella cache KV e impone 4096 posizioni per prompt e frame generati. Non traduciamo questo dato in minuti di audio disponibili: mancano una nostra misura e le condizioni complete del carico. Una prova utile deve conservare anche errori e impostazioni ignorate, non soltanto il file riuscito. README TTS al tag b12116: parametri, limiti e conversione Drama 3.
Che cosa resta distinto dal modello Fish Audio?
La model card presenta Drama 3 come sistema per dialoghi a più personaggi e contenuti lunghi, con capacità più ampie di quelle attualmente esposte da questa integrazione. Non trasferiamo automaticamente quelle promesse a llama-tts. Allo stesso modo, la disponibilità del runtime non stabilisce i diritti sui pesi o sulle voci: per un eventuale uso commerciale bisogna leggere i termini indicati dal produttore e usare materiali autorizzati. Per ora la conclusione sostenibile è circoscritta: esiste una nuova integrazione documentata e versionata da provare. Non è una raccomandazione di produzione, un confronto d’ascolto o una misura di qualità rispetto a servizi cloud. Fish Audio Drama 3: model card e collegamento alla licenza.
Condizioni e limitazioni
Non è stata eseguita sintesi audio. Nella specifica integrazione llama.cpp, --tts-speaker-file non è ancora supportato, --tts-lang non viene usato e --top-k/--top-p non controllano il campionamento. Il limite di 4096 posizioni riguarda la codebook tower, non una promessa sulla durata del parlato o sulla memoria richiesta.
Checklist pratica
- Fissare il tag llama.cpp b12116 e la revisione del checkpoint; non registrare soltanto il nome Drama 3.
- Leggere la licenza collegata dalla model card prima di scaricare o usare i pesi; usare solo materiale vocale autorizzato.
- Preparare modello GGUF e mmproj coerenti seguendo il README dello stesso tag.
- Eseguire una prova breve con due speaker e salvare comando, log, backend e file WAV.
- Non trattare --tts-speaker-file, --tts-lang, --top-k e --top-p come controlli già funzionanti per questa integrazione.
- Misurare risorse, tempo, qualità d’ascolto e fallimenti prima di estendere testo o carico.