
L’ANALISI
llama.cpp 0.9.0: FP8, cache KV e nuove voci locali
llama.cpp 0.9.0 aggiunge FP8 E4M3 e cache KV per più sequenze. La release non è una prerelease: novità, limiti e checklist di confronto.
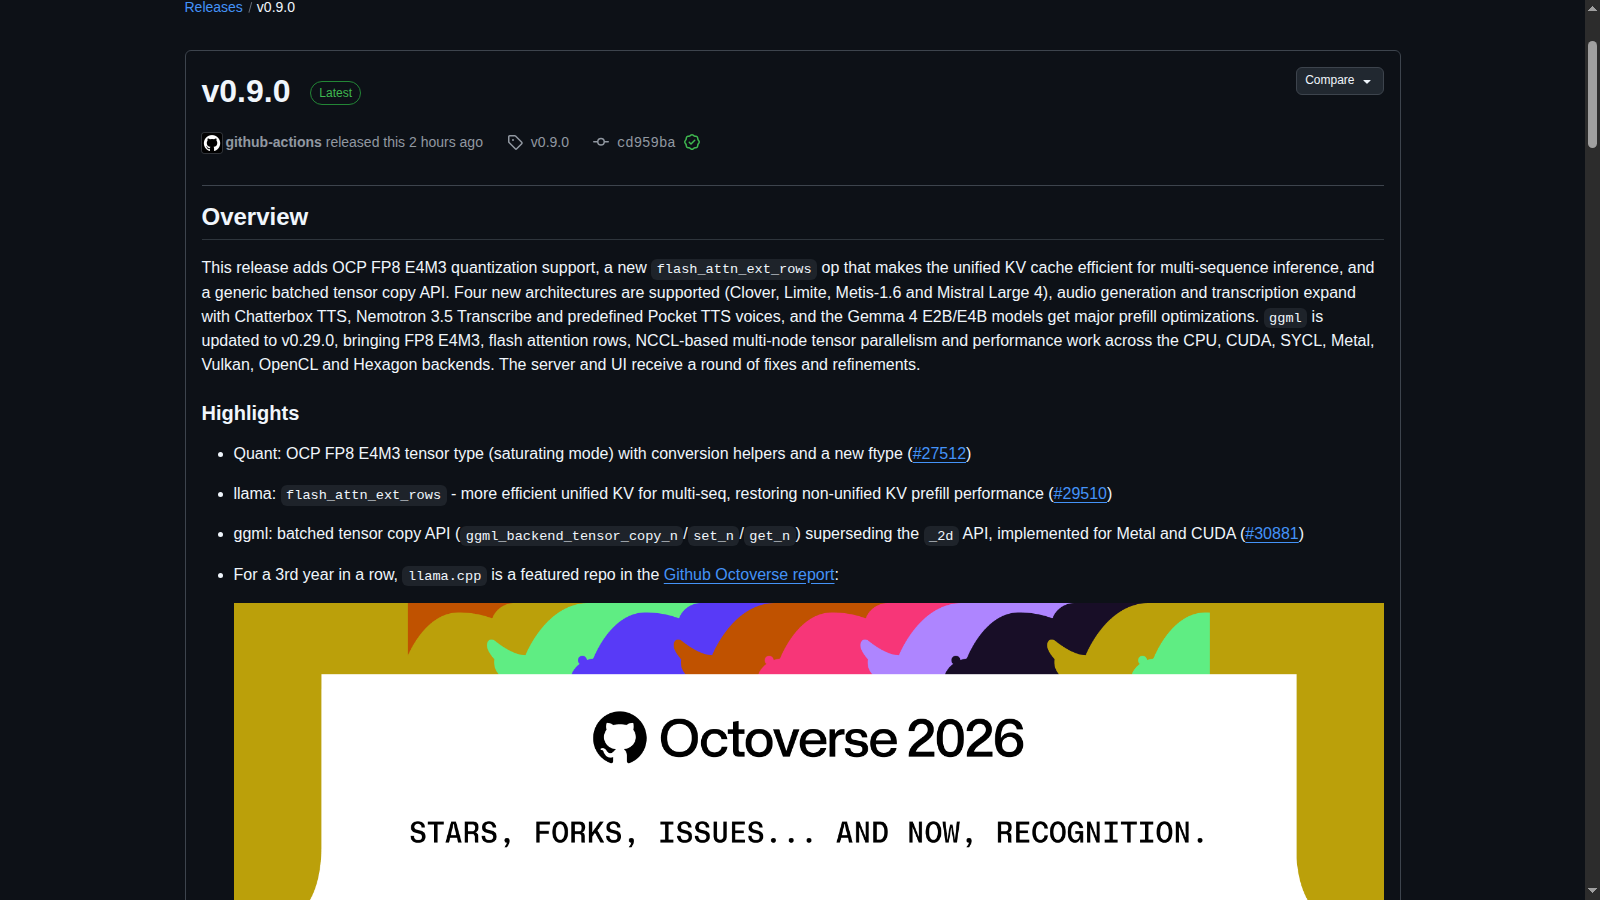
In breve: llama.cpp 0.9.0 è una release versionata, pubblicata il 4 novembre 2026 e non marcata come prerelease. Riunisce FP8 E4M3 e aggiornamenti della cache KV per più sequenze. Serve soprattutto a chi deve fissare una versione riproducibile del runtime: non è una prova di velocità sulla propria macchina né un pacchetto di pesi incluso. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
Metodo: lettura delle note della release ufficiale e verifica dell’oggetto REST GitHub, con data di pubblicazione e flag prerelease. Non abbiamo installato la versione, scaricato i modelli o eseguito confronti prestazionali. La checklist è un protocollo proposto, non un test già svolto da Francesco.
- La release v0.9.0 è stata pubblicata il 4 novembre 2026 alle 14:08, ora italiana, con prerelease=false. Note ufficiali
- Le note includono il tipo OCP FP8 E4M3 e una nuova operazione per la cache KV unificata multisequenza. Note ufficiali
- Il riferimento ai binari nelle note porta alla nightly b12110: versione del progetto e identificatore della build restano distinti. Note ufficiali
Che cosa cambia rispetto ai singoli tag b12100 e b12102?
Il nuovo evento è il rilascio numerato v0.9.0 del 4 novembre alle 14:08, ora italiana. L’oggetto REST dichiara prerelease=false. I fix sul matching dei tag GGUF e sui limiti delle viste, già trattati nelle schede del mattino, compaiono nel changelog e non diventano per questo nuove scoperte. Per il lettore cambia il riferimento da conservare nel proprio inventario: una release che raccoglie i cambiamenti. Non equivale a una garanzia di compatibilità o a un’autorizzazione per aggiornare automaticamente un ambiente di produzione. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
FP8 e cache KV significano meno memoria per tutti?
Le note introducono OCP FP8 E4M3 e flash_attn_ext_rows per la cache KV unificata multisequenza. Da questa descrizione non segue un risparmio uniforme per ogni modello o backend. Un confronto utile deve fissare lo stesso file dei pesi, gli input, la configurazione della cache e il numero di sequenze; altrimenti è facile attribuire al runtime una differenza prodotta dal carico. Questa è una condizione del test proposto, non il risultato di una misurazione nostra. Conviene registrare anche i casi in cui il proprio percorso non usa l’operazione interessata. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
Come leggere le novità su modelli e audio?
La release elenca supporto per Clover, Limite, Metis-1.6 e Mistral Large 4, oltre a Chatterbox TTS, Nemotron 3.5 Transcribe e voci predefinite Pocket TTS. Il perimetro è il runtime. Prima di provare uno di questi percorsi, resta da verificare separatamente il repository dei pesi, la revisione, la licenza, la compatibilità del formato e le risorse disponibili. Non presentiamo tutti i modelli come immediatamente eseguibili su un portatile né come già collaudati. Per un primo test scegli un solo compito e un file preciso, invece di cambiare insieme modello e motore. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
Quale build conservare per un confronto riproducibile?
Le note indirizzano ai binari della nightly b12110. Annota quindi sia v0.9.0 sia il commit o identificatore della build effettivamente usata, senza trattare i due nomi come intercambiabili. Conserva l’asset scaricato e il suo checksum, il comando di avvio e la configurazione del modello. Se compili da sorgente, fissa anche toolchain e opzioni. Per questa analisi non abbiamo scaricato o eseguito quei binari: sono passaggi del protocollo suggerito. Un riferimento di versione leggibile aiuta la manutenzione, ma da solo non descrive tutto l’ambiente di esecuzione. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
Come decidere se promuovere l’aggiornamento?
Prepara un piccolo insieme di richieste sintetiche rappresentative e confronta riferimento e candidato nello stesso ambiente isolato. Valuta prima la correttezza: file caricato, output strutturato quando richiesto, comportamento dei tool e stabilità del processo. Solo dopo confronta memoria e tempi, separando elaborazione del prompt e generazione, e annota numero di sequenze e condizioni del test. Definisci prima quale regressione blocca la promozione e tieni disponibile la versione precedente. Non c’è qui una soglia prestazionale universale: il criterio dipende dal compito che il tuo sistema deve completare. llama.cpp v0.9.0: note ufficiali e riferimento ai binari.
Condizioni e limitazioni
Verifica documentale delle note ufficiali e dello stato della release, senza compilazione o benchmark nostri. I miglioramenti descritti da upstream non garantiscono lo stesso risultato sul proprio hardware. Il supporto nel runtime non include automaticamente pesi, licenze o prestazioni dei singoli modelli.
Checklist pratica
- Congelare versione precedente, v0.9.0, commit e identificatore del binario effettivo.
- Conservare hash dei pesi e della build, configurazione e comandi di avvio.
- Verificare disponibilità e licenza dei pesi separatamente dal supporto del runtime.
- Usare input sintetici e un ambiente isolato, senza credenziali o dati di produzione.
- Confrontare prima correttezza e stabilità, poi memoria, prefill e generazione.
- Registrare backend e concorrenza; non estendere un risultato a hardware non provato.
- Stabilire il criterio di regressione e conservare la versione precedente per il ritorno controllato.