
L’ANALISI
DeepSeek V4.1 Flash: come riduce la KV cache sul contesto lungo
Il nuovo modello combina input visivi, contesto fino a un milione di token e tre tecniche di compressione della cache, ma resta un rilascio da infrastruttura professionale.
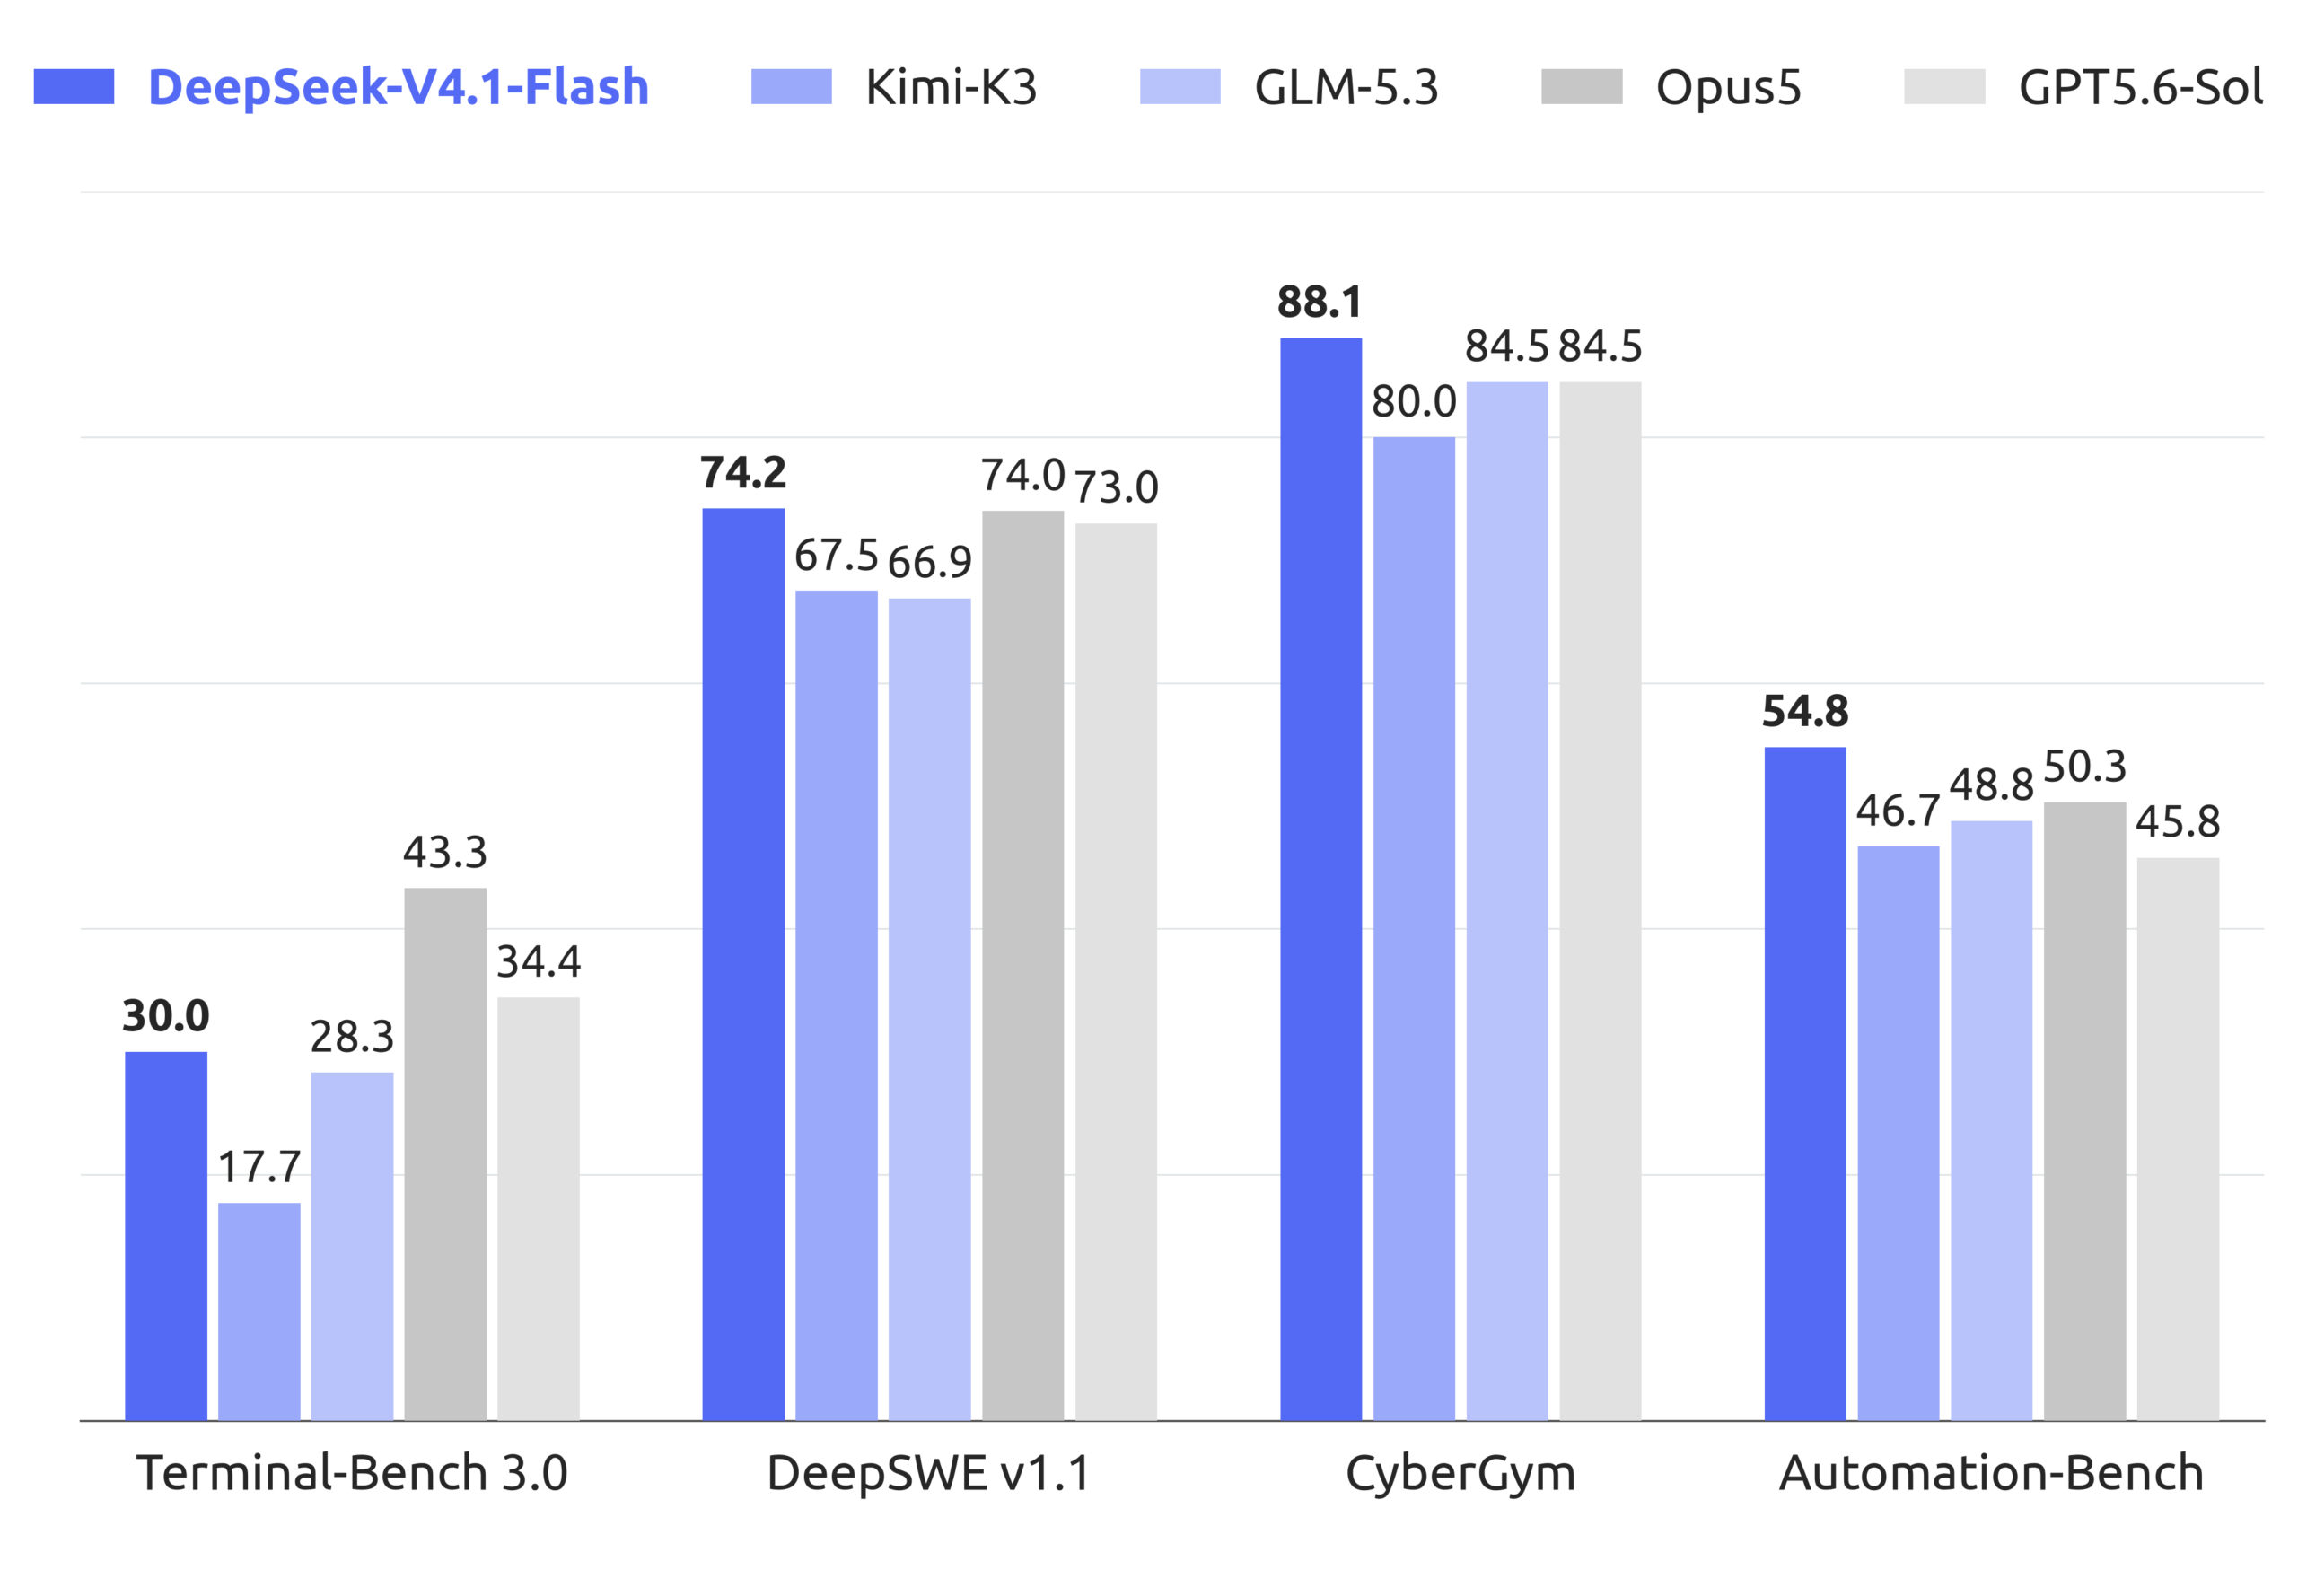
In breve: DeepSeek V4.1 Flash prova a rendere sostenibile il contesto molto lungo riducendo ciò che la GPU deve conservare per token. I pesi sono scaricabili e il modello accetta testo e immagini, ma il vantaggio reale dipende dal runtime, dall’hardware e dal carico, non dal solo limite nominale di un milione di token.
Che cosa è stato pubblicato
Il repository ufficiale distribuisce configurazione, tokenizer, codice personalizzato e shard dei pesi di DeepSeek V4.1 Flash. La model card descrive un modello multimodale Mixture-of-Experts con 552 miliardi di parametri nel backbone, immagini e testo in input e generazione testuale.
Perché la KV cache è il punto centrale
Nei carichi con prompt molto lunghi, la memoria occupata dalle chiavi e dai valori dell’attenzione cresce con il contesto. DeepSeek combina un encoder causale seguito dal decoder, attenzione sparsa condivisa tra livelli e cache principale FP4; dichiara 890 byte persistenti per token, circa un quarto di V4 Flash.
CED, CSA2 e replay limitato
La Causal Encoder-Decoder proietta la cache globale dagli stati finali dell’encoder. CSA2 assegna ai livelli modalità statiche Full, Reindex o Reuse, mentre SWA Bounded Replay ricostruisce gli stati mancanti ripetendo solo la finestra recente. Sono ottimizzazioni complementari, non un singolo trucco di quantizzazione.
Cosa cambia per agenti e multimodalità
Il contesto lungo è pensato per carichi ricchi di input, come repository, documenti e cronologie di strumenti. Il modello include anche un encoder visivo addestrato da zero. Questo amplia ciò che si può passare al modello, ma non prova che usare l’intero milione di token sia sempre più preciso o conveniente.
Condizioni e limiti
I valori di compressione, addestramento su 45 trilioni di token e risultati di benchmark sono dichiarazioni DeepSeek. Il codice richiede trust_remote_code e il modello da centinaia di miliardi di parametri non è una proposta locale consumer. Prima dell’uso servono misure indipendenti di memoria, latenza, qualità in italiano e stabilità del tool calling.
Checklist prima del deployment
- Fissare la revisione del repository e verificare gli hash degli shard.
- Stimare pesi, KV cache, attivazioni e margine GPU alla lunghezza realmente necessaria.
- Isolare e revisionare il codice remoto prima di abilitarlo.
- Provare testo, immagini e chiamate agli strumenti come percorsi separati.
- Confrontare 32K, 128K e contesti superiori invece di assumere utile il massimo.
- Misurare latenza, throughput, qualità e costo sul proprio hardware prima della produzione.